За последние два года LLM (большие языковые модели) значительно продвинулись в «переводе естественного языка в математические модели» и «переводе естественного языка в код решателей». Модели научились понимать условия задач, записывать MIP-формулы, вызывать Gurobi или другие решатели, что свидетельствует о начальных способностях к оптимизационному моделированию. Однако для реальных промышленных задач этого всё ещё далеко недостаточно.
Настоящая сложность заключается не в простом переводе ограничений в математические выражения, а в разработке алгоритмов, которые способны эффективно работать с большими примерами: быть выполнимыми, точными и быстрыми. Даже полностью корректная MIP-модель, переданная универсальному решателю, может не дать доказуемо качественного решения даже за час. Именно поэтому OR-инженеры в реальных условиях всё ещё пишут декомпозиционные алгоритмы, генерацию столбцов, методы Бендерса, локальный поиск, метаэвристики и гибридные алгоритмы, сочетающие математическое программирование и эвристики.
Недавно исследователи из Массачусетского технологического института и других учреждений представили FrontierOR: эталонный тест для оценки способности LLM к проектированию алгоритмов для крупномасштабной оптимизации.
В отличие от традиционных тестов, которые проверяют только «способность к моделированию» или «способность вызывать решатель», FrontierOR фокусируется на том, может ли LLM, подобно настоящим OR-исследователям и инженерам, разрабатывать масштабируемые, качественные и эффективные алгоритмы с учётом сложной структуры проблемы.
Ссылка на статью: arxiv.org/abs/2605.25246
Домашняя страница проекта: frontieror.vercel.app
Ссылка на код: github.com/Minw913/FrontierOR
Ссылка на набор данных: SmartOR/FrontierOR
Ключевой вопрос FrontierOR именно таков: Способны ли самые мощные большие модели на сегодняшний день, отталкиваясь от реальных проблем, самостоятельно разрабатывать конкурентоспособные эффективные алгоритмы? Могут ли они перестать быть просто «вызывателями решателей» и, подобно экспертам по OR, выбирать стратегии декомпозиции, эвристики, поиска и их комбинации, исходя из структуры задачи?
Значение этой работы в том, что она смещает акцент оценки LLM-for-OR с «умеет ли писать модели» на «умеет ли проектировать алгоритмы». Это также важный рубеж, который большие модели должны преодолеть на пути к реальным промышленным системам принятия решений.
Контекст исследования
Уже существует ряд эталонов, оценивающих способность LLM к моделированию оптимизационных задач, например, генерацию математических моделей по описанию на естественном языке, вызов решателей или проверку ответов на небольших примерах. Эти задачи очень важны, но они часто не могут дать ответ на более близкий к промышленному внедрению вопрос: способна ли модель на крупных примерах, где производительность стандартных решателей уже исчерпана, самостоятельно создавать более эффективные алгоритмические пути?
В практике исследования операций универсальные решатели — это отправная точка, а не конечная цель. Реальные задачи часто имеют особую структуру: потоки в сетях, временную декомпозицию, маршрутизацию транспортных средств, взаимосвязь запасов и маршрутов, взаимосвязь станков и операций в планировании, взаимосвязь мощности и покрытия при размещении объектов и т.д. Хорошие алгоритмисты используют эту структуру, чтобы разбить исходную задачу, аппроксимировать её, ослабить ограничения, рекомбинировать, а затем решить с помощью гибридных эвристических или точных методов.
Таким образом, по-настоящему ориентированный на OR эталон для больших моделей должен одновременно удовлетворять трём условиям: источники задач должны быть достаточно реалистичными, примеры — достаточно большими, а оценка — достаточно строгой. FrontierOR был предложен именно в этом контексте: это не набор «упражнений по оптимизации» для больших моделей, а превращение сложных задач из OR-литературы за последние тридцать с лишним лет, прошедших рецензирование, в задачи по проектированию алгоритмов с автоматической оценкой.
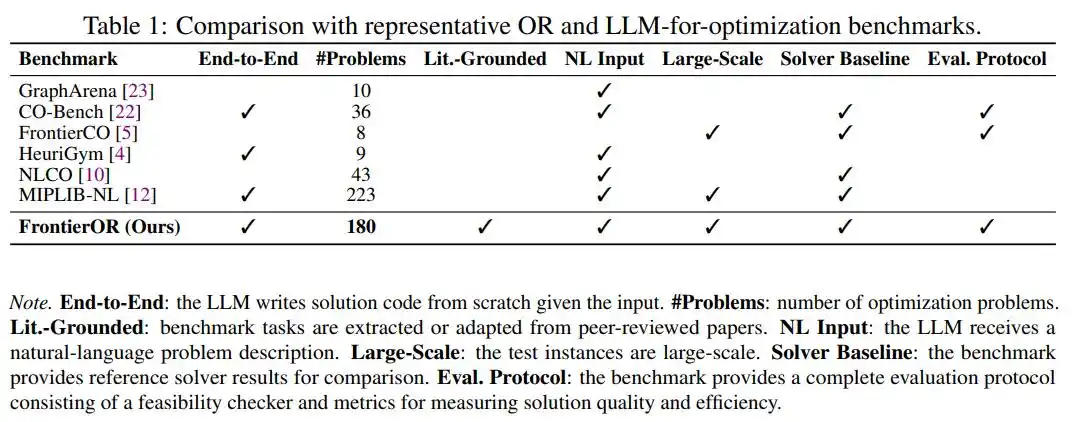
Таблица 1. Многомерное сравнение FrontierOR с репрезентативными OR/LLM-for-optimization эталонами
Методология исследования
Процесс создания FrontierOR можно обобщить в четыре этапа: выбор задач из литературы, преобразование проблем из статей в стандартизированные компоненты задачи, двойная проверка качества (автоматическая и экспертная) и, наконец, отбор более сложного подмножества Hard.
- Первый этап: выбор задач из реальной литературы. Источники данных охватывают 180 статей из более чем 20 OR-журналов за период с 1992 по 2025 год. Для включения задача должна иметь чёткое определение, а исходная статья должна демонстрировать практическую ценность специализированного алгоритма по сравнению с универсальным решателем.
- Второй этап: стандартизация компонентов задачи. Каждая статья преобразуется в описание задачи на естественном языке, математическую модель, эталонную реализацию для Gurobi, эталонное решение и независимый проверяющий на выполнимость.
- Третий этап: двухуровневая проверка качества. Сначала автоматическая перекрёстная проверка контролирует соответствие эталонного решения Gurobi и проверяющего выполнимость; затем 15 экспертов по OR проводят несколько раундов аудита, проверяя согласованность модели, описания, кода и проверяющего.
- Четвёртый этап: отбор подмножества Hard. Из 180 задач выбираются 50 более сложных, фокусируясь на комбинаторном взрыве, большем масштабе, более связанных ограничениях и сценариях, где Gurobi не может доказать оптимальность за бюджет в 1 час.
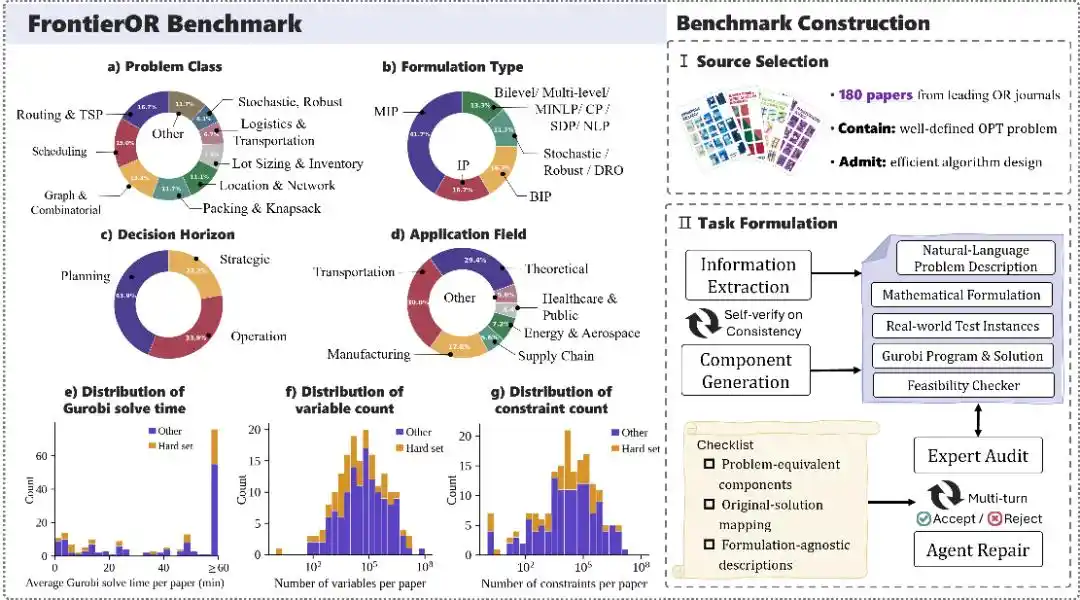
Рисунок 1. Полная картина эталона FrontierOR: категории задач, области применения, масштаб примеров и процесс создания
Протокол оценки
Процесс оценки также подчёркивает сквозные возможности. Сначала модель генерирует полную алгоритмическую программу на основе описания задачи на естественном языке. Программа сначала проходит предварительный отбор на выполнимость, допустимость и качество на небольших примерах: если превышено время, решение недопустимо или разрыв (gap) с решением Gurobi на малом примере превышает 10%, то она не допускается к оценке на больших примерах.
После прохождения предварительного отбора программа запускается на нескольких крупномасштабных примерах для каждой задачи и сравнивается с проверенным экспертами эталонным решением Gurobi. FrontierOR использует четыре показателя: Execution rate (частота выполнимости), Feasibility (допустимость), Solution quality (качество решения) и Quality-Time Efficiency (QTE, качественно-временная эффективность). QTE — самый строгий: успехом считается только относительная разница в целевом значении с эталонным решением Gurobi не более 1% ИЛИ решение, превосходящее решение Gurobi.
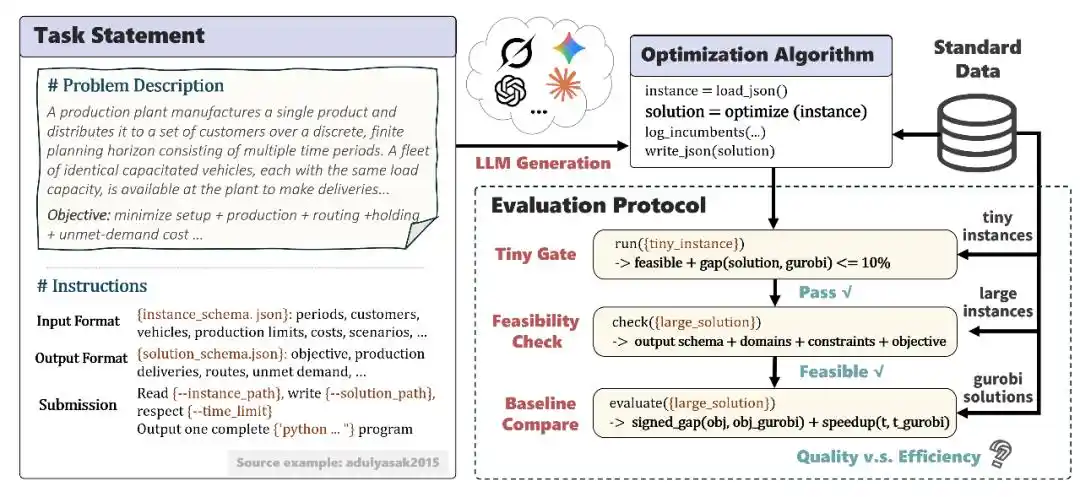
Рисунок 2. Двухэтапный процесс оценки FrontierOR: предварительный отбор на малых примерах, оценка качества и скорости на больших примерах
Результаты экспериментов
One-shot (одноразовая генерация): выполнимость близка к пределу
В настройке one-shot модель должна с нуля сгенерировать полную алгоритмическую программу, допускается ограниченная самостоятельная отладка на основе ошибок выполнения, но нельзя многократно переписывать алгоритм на основе отзывов оценки. Эта настройка проверяет комплексную способность модели за один раз прочитать задачу, построить модель, спроектировать алгоритм и закодировать его.
Результаты показывают, что выполнимость у самых мощных моделей уже очень высока. Например, GPT-5.3-Codex достигает Execution rate 0.98 на полном наборе (Full), Gemini 3.1 Pro и Claude Opus 4.6 также достигают 0.93. Это говорит о том, что для передовых моделей «запустится ли код» уже не является основной проблемой.
Но выполнимость не равносильна умению решать. Показатели Feasibility, Solution quality и QTE по-прежнему значительно ниже Execution rate. Иными словами, большие модели уже могут писать формально полные программы оптимизации, но заставить эту программу сохранять допустимость, быть близкой к оптимальной и быть быстрее Gurobi в промышленном масштабе по-прежнему сложно.
С точки зрения общего расслоения, передовые модели значительно превосходят другие основные модели как на полном наборе (Full), так и на подмножестве Hard. На полном наборе FrontierOR Feasibility передовых моделей составляет 0.60–0.62, в то время как у других основных моделей — около 0.18–0.42. На подмножестве Hard разрыв сохраняется: передовые модели — 0.49–0.64, другие основные модели снижаются до 0.13–0.37.
Подмножество Hard ещё больше увеличивает разрыв в алгоритмических способностях между передовыми моделями. На полном наборе QTE трёх передовых моделей находится в узком диапазоне 0.25–0.31, что кажется близким; но на подмножестве Hard QTE Claude Opus 4.6 по-прежнему достигает 0.32, а у GPT-5.3-Codex падает до 0.18 — разница почти в 2 раза. Таким образом, подмножество Hard становится настоящим «водоразделом инженерных алгоритмических способностей».
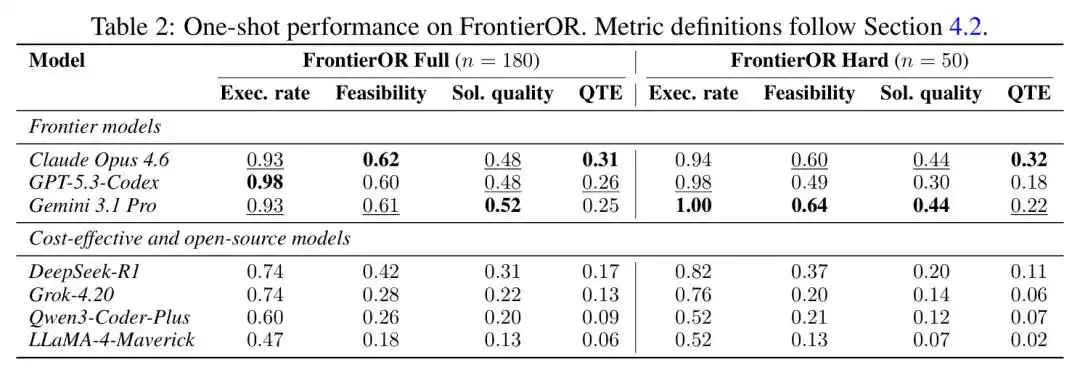
Таблица 2. Результаты оценки FrontierOR one-shot: показатели выполнимости, допустимости, качества решения и QTE на полном наборе (Full) и подмножестве Hard
Появляется дифференциация в выборе алгоритмов
Исследовательская группа дополнительно проанализировала методы решения, используемые в программах, сгенерированных моделями, разделив их на пять категорий: чистый вызов решателя, декомпозиция, конструктивная эвристика, локальный поиск/метаэвристика, а также гибридные методы математического программирования и эвристик. Этот анализ очень важен, поскольку он непосредственно показывает, обладает ли модель истинным сознанием проектирования алгоритмов.
Результаты показывают, что более слабые модели сильно зависят от чистого вызова решателя. Например, около 99% программ LLaMA-4-Maverick представляют собой монолитный вызов решателя (solver call), что по сути является передачей задачи универсальному решателю. Напротив, распределение методов у Claude Opus 4.6 наиболее сбалансировано: около 37% — чистый решатель, 27% — локальный поиск/метаэвристика, 27% — гибриды математического программирования и эвристик.
Что ещё важнее, методы, отличные от чистого вызова решателя, в целом имеют преимущество по показателю QTE. Это означает, что «разнообразие методов» само по себе является конкурентоспособностью: чем больше модель способна выбирать декомпозицию, эвристики и гибридные алгоритмы в зависимости от структуры задачи, тем выше вероятность одновременно выиграть в качестве и скорости на больших примерах.
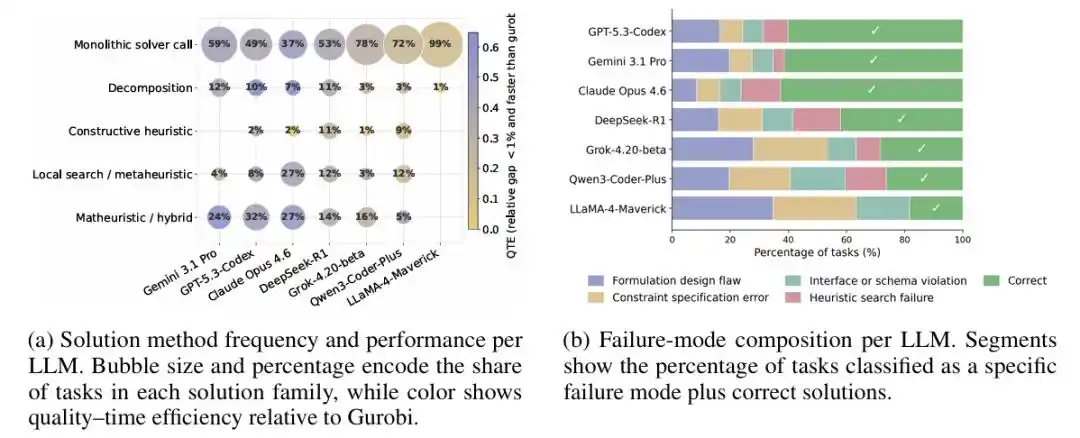
Рисунок 3. Распределение методов решения в программах, сгенерированных разными моделями, и анализ режимов сбоя
Смещение режимов сбоя: от «неумения моделировать» к «недостаточно глубокому поиску»
Анализ режимов сбоя показывает, что с ростом возможностей моделей место возникновения ошибок систематически смещается назад. Более слабые модели в основном ошибаются на ранних этапах: проектирование математической модели, спецификация ограничений, схемы ввода-вывода и т.д.; у более сильных моделей ошибки на этих базовых этапах значительно сокращаются, и новые узкие места смещаются в сторону глубины и качества эвристического поиска.
Это очень похоже на траекторию роста алгоритмиста-человека. Новички сначала допускают ошибки моделирования: нечёткое определение переменных, пропуск ограничений, несоответствие ввода-вывода; более опытные инженеры реже допускают такие простые ошибки, но сталкиваются с более сложными проблемами: достаточно ли сильна стратегия поиска, эффективен ли дизайн окрестности, способны ли релаксация и восстановление совместить скорость и качество.
Таким образом, FrontierOR не только говорит нам, «кто набрал больше баллов», но и показывает, «где находится предельная возможность». Это особенно важно для проектирования систем LLM-for-OR следующего поколения: будущий прорыв может исходить не от модели, которая лучше пишет формулы, а от системы, которая лучше умеет искать, комбинировать алгоритмические навыки и использовать обратную связь для самоулучшения.
Самоэволюция
Одноразовая генерация — это только первый шаг. В реальности проектирование алгоритмов никогда не заканчивается одним вариантом, это итеративный процесс постоянного запуска, анализа неудач, изменения стратегий и повторного запуска. Поэтому FrontierOR дополнительно оценивает три структуры самоэволюции во время тестирования: OpenEvolve, EoH и CORAL.
Эксперимент выбрал 40% самых сложных задач из подмножества Hard в качестве тестового набора для self-evolve, используя программу, однократно сгенерированную GPT-5.3-Codex, в качестве начального семени. Для каждой структуры установлено единое ограничение в 30 кандидатных программ, а окончательный лучший результат считается конечным состоянием. Это гарантирует, что различия в основном обусловлены механизмом поиска, а не разницей в начальных программах.
Результаты очень впечатляющие: при всех трёх структурах самоэволюции наилучшая кандидатная программа по всем показателям значительно превосходит однократно сгенерированную. QTE вырос с 0.15 в режиме one-shot до максимум 0.50, что означает, что на самых сложных задачах примерно в половине больших примеров алгоритмы, сгенерированные LLM, уже могут одновременно удовлетворять двум условиям: «качество близко к Gurobi» и «скорость не ниже Gurobi».
Среди них CORAL, благодаря механизму разделяемой памяти нескольких агентов, добился наиболее стабильного улучшения, достигнув QTE 0.50; OpenEvolve следует за ним с QTE 0.49; EoH также привёл к заметному улучшению, но с большей волатильностью производительности, QTE 0.33.
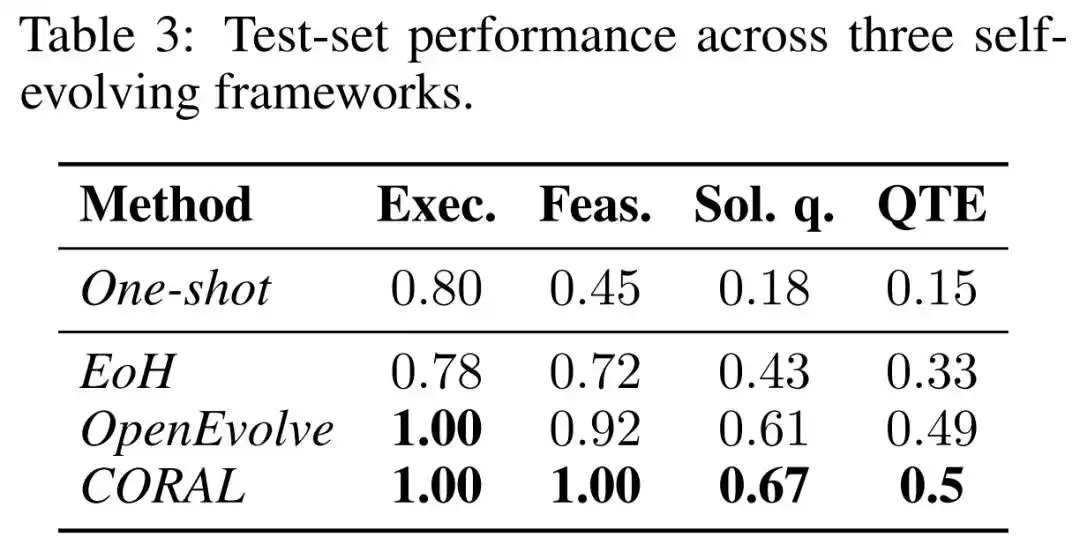
Таблица 3. Производительность трёх структур самоэволюции во время тестирования на самых сложных задачах: QTE увеличился с 0.15 до 0.50
Дальнейшее наблюдение за траекториями эволюции выявляет весьма показательное явление: измерение скорости часто может превзойти базовый уровень Gurobi в течение первых 5 попыток, в то время как измерение качества решения значительно сложнее. Причина вполне понятна: чтобы алгоритм работал быстрее, можно использовать лёгкую конструктивную эвристику; но чтобы одновременно с «более быстрым» быть близким к глобальному оптимуму, требуются более тонкие окрестности, стратегии восстановления, релаксации и управления поиском.
Это говорит о том, что самоэволюция LLM — это не просто «попробовать код несколько раз». По-настоящему эффективная самоэволюция должна уметь запоминать прошлые неудачи, определять узкие места производительности, динамически корректировать направление поиска и делать структурированный компромисс между скоростью и качеством.
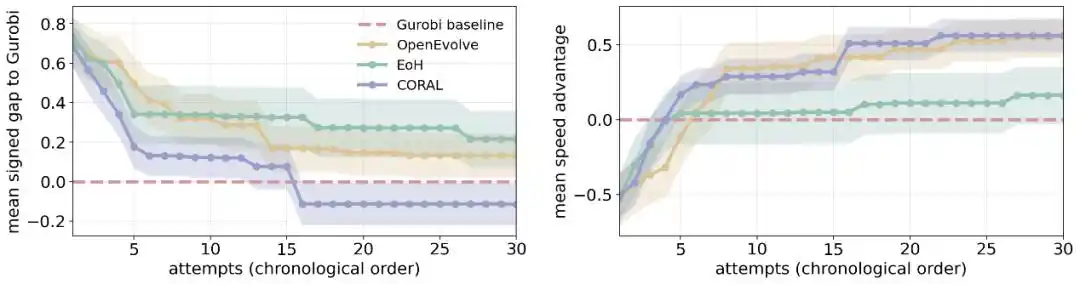
Рисунок 4. Двумерные траектории эволюции качества и скорости для трёх структур самоэволюции: скорость легко преодолевается первой, повышение качества сложнее
Будущее применение
Ценность FrontierOR не только в ранжировании моделей, но и в предоставлении чёткого направления для разработки систем интеллектуальной оптимизации следующего поколения. Если большие модели смогут стабильно понимать реальные бизнес-требования, распознавать структуры оптимизации, вызывать или комбинировать соответствующие алгоритмические навыки и самостоятельно совершенствоваться на основе обратной связи выполнения, то у них есть шанс стать «ИИ-алгоритмистами» в промышленных системах принятия решений.
В сценариях цепочки поставок такая система может на основе заказов, складов, запасов, транспортных сетей и требований к срокам автоматически генерировать алгоритмы планирования и маршрутизации, ориентированные на конкретный масштаб; в энергетических системах она может разрабатывать быстрые стратегии аппроксимационного решения для диспетчеризации сетей, управления накоплением энергии, балансировки нагрузки; в транспортных и городских системах она может генерировать оптимизационные алгоритмы, пригодные для развёртывания в реальном времени, с учётом динамического спроса, распространения перегрузок и ограничений ресурсов.
Более того, FrontierOR также намекает на будущую форму агентной оптимизации (agentic optimization): LLM больше не просто генератор кода, а агент проектирования алгоритмов, который умеет использовать библиотеку навыков, вызывать средства проверки, проводить эксперименты, выполнять отнесение ошибок и активно исследовать в условиях ограниченного бюджета.
Перспективы
- Создание библиотеки навыков проектирования алгоритмов OR. Осаждение распространённых стратегий, таких как декомпозиция, релаксация, генерация столбцов, локальный поиск, восстановление, перезапуск, гибридные решения, в модули навыков, доступные для поиска, комбинирования и выполнения, чтобы агент мог автоматически выбирать шаблоны алгоритмов в зависимости от структуры задачи.
- Разработка более надёжных верификаторов/оценщиков. Оценщик должен не только проверять выполнимость, но и определять, какие ограничения приводят к сбою, в каком локальном поиске происходит застой, тем самым превращая отзывы выполнения в направления для следующего цикла проектирования.
- Повышение способности самоэволюции к планированию бюджета. На крупномасштабных примерах каждая оценка дорогостояща. Будущие системы должны научиться определять, когда исследовать новую структуру, когда настраивать параметры, когда прекращать неэффективные направления.
- Содействие глубокой интеграции LLM с традиционными решателями. Самое многообещающее направление может заключаться не в «замене LLM решателя», а в том, что LLM отвечает за обнаружение структуры и проектирование алгоритма, а традиционные решатели — за локальную точную оптимизацию и достоверную проверку.
Подводя итог, FrontierOR нарисовал первую систематическую карту инженерных алгоритмических способностей OR для больших моделей: большие модели уже могут писать частично конкурентоспособные алгоритмы оптимизации, но истинными определяющими факторами верхнего предела становятся уже не синтаксис кода или перевод формул, а способность обнаружения структуры, проектирования поиска и самоэволюции.
Если исследования LLM-for-OR на предыдущем этапе отвечали на вопрос «умеет ли большая модель строить модели», то FrontierOR начинает задавать более сложный и реалистичный вопрос: может ли большая модель стать настоящим проектировщиком алгоритмов?
Ссылки: arxiv.org/abs/2605.25246
Эта статья взята с официального аккаунта WeChat «新智元» (Новый интеллектуальный элемент), автор: 新智元; редактор: LRST