Dialog dengan Mai-Lan dari Amazon Web Services: Medan Pertarungan Berikutnya untuk S3, Menghadapi Gelombang Konsumsi Data di Era Agent

marsbitDipublikasikan tanggal 2026-05-08Terakhir diperbarui pada 2026-05-08

Abstrak

Awal tahun ini, popularitas OpenClaw di pasar Tiongkok menunjukkan potensi besar agen AI. Namun, pertanyaan mendesak bagi penyedia cloud muncul: apakah infrastruktur data, terutama lapisan data, siap menghadapi konsumsi data yang sangat agresif dan frekuensi tinggi oleh agen yang berkembang pesat? Mai-Lan Tomsen Bukovec, Wakil Presiden Teknologi Amazon Web Services, menekankan bahwa agen mengkonsumsi data dengan cara yang sangat aktif dan agresif, dengan frekuensi panggilan ke gudang data atau danau data yang luar biasa tinggi. Agen bekerja dalam mode "paralel dan pilih yang terbaik", menjalankan puluhan hingga ratusan kueri secara bersamaan untuk mencari jalur optimal, membuatnya menjadi konsumen data yang jauh lebih intensif daripada manusia—dengan frekuensi panggilan dan throughput data yang meningkat secara eksponensial. Biaya atau nilai menjadi faktor penentu dalam membangun infrastruktur agen. Menyambut ulang tahun ke-20 Amazon S3, layanan ini telah melakukan tiga transformasi besar untuk memenuhi kebutuhan era AI: S3 Table (format tabel), S3 Files (file), dan S3 Vector (vektor). Dukungan native S3 untuk Apache Iceberg (S3 Table) memungkinkan agen berinteraksi efisien dengan data melalui SQL. S3 Vectors, yang diperkenalkan sebagai tipe data native, digunakan untuk membangun konteks data dan sebagai memori bersama yang berkembang pesat untuk sistem agen. S3 Files, yang dirilis baru-baru ini, memungkinkan agen mengakses data S3 melalui standar POSIX seperti sistem file,...

Awal tahun ini, popularitas OpenClaw di pasar Tiongkok membuat semua orang melihat potensi besar Agent. Namun, yang mengikutinya adalah sebuah pertanyaan ujian yang harus dijawab oleh semua penyedia layanan cloud: Ketika Agent mulai berkembang biak seperti lobster siber dan memanggil data dengan frekuensi tinggi, apakah infrastruktur cloud AI, terutama lapisan datanya, sudah siap?

Misalnya, tim data perusahaan sering menghadapi hambatan di tingkat data saat men-deploy Agent ke lingkungan produksi. Membangun Agent di platform yang berbeda seperti basis data vektor, basis data relasional, basis data grafik, dan danau/gudang data, memerlukan penyinkronan pipa data untuk menjaga ketepatan waktu informasi konteks. Namun, dalam lingkungan produksi yang sebenarnya, informasi konteks ini secara bertahap akan menjadi usang.

Urgensi masalah ini berasal dari pola konsumsi data Agent yang sangat berbeda dengan insinyur manusia.

"Agent sedang mengonsumsi data dengan cara yang sangat aktif dan agresif. Frekuensi pemanggilannya terhadap data warehouse atau danau data sungguh menakjubkan."

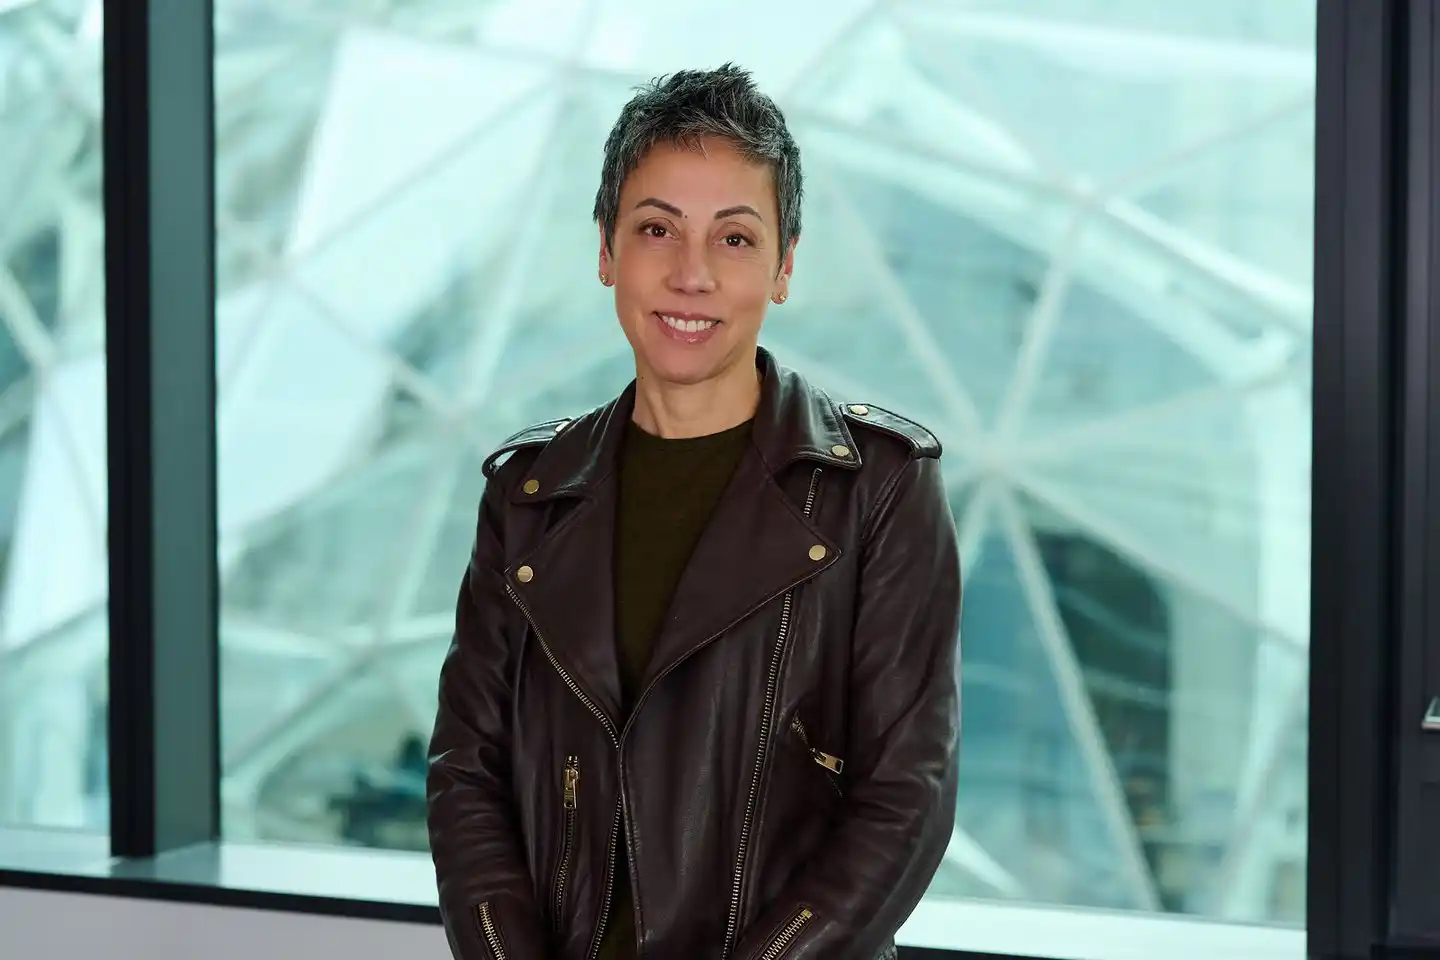
Mai-Lan Tomsen Bukovec, Wakil Presiden Teknis Amazon Web Services, baru-baru ini dalam diskusi dengan penulis menekankan bahwa Agent bekerja dengan mode "parallel search for the best" atau pencarian paralel untuk yang terbaik: bukan satu kueri dalam satu waktu, melainkan puluhan hingga ratusan kueri secara bersamaan, membandingkan untuk menemukan jalur terbaik. Ini membuat Agent menjadi konsumen data yang jauh lebih agresif daripada manusia — frekuensi pemanggilan lebih tinggi beberapa tingkat besaran, dan throughput data mengalami pertumbuhan eksponensial.

Mai-Lan lebih lanjut menyatakan, "Saat ini pelanggan sangat ingin membangun infrastruktur Agent. Biaya, atau dengan kata lain nilai untuk uang, bukan lagi faktor sekunder, melainkan menjadi faktor penentu. Dalam enam bulan hingga satu tahun ke depan, seiring dengan ledakan Agent, pemilihan layanan data dasar akan menjadi sangat krusial."

Saat ini, euforia OpenClaw mulai mereda, menyisakan peringatan uji tekanan terhadap kemampuan penyimpanan dan komputasi dasar penyedia cloud. Mai-Lan percaya bahwa Amazon Web Services memiliki keunggulan alami di bidang ini. Skala Amazon S3 (Amazon Simple Storage Service), serta efisiensi biaya Amazon Redshift dan Amazon Athena dalam konteks konkurensi tinggi, memang dipersiapkan untuk mode interaksi data Agent yang sangat besar dan berfrekuensi ultra-tinggi ini.

Bertepatan dengan ulang tahun ke-20 produk Amazon S3, seputar tuntutan pemrosesan data pelanggan di era AI, Amazon S3 baru-baru ini juga mewujudkan tiga transformasi besar: S3 Table (format tabel), S3 Files (file), dan S3 Vector (vektor).

Seperti dukungan native S3 Table untuk Apache Iceberg. Mai-Lan menunjukkan bahwa saat Agent memproses data, ia cenderung berinteraksi langsung dengan data format Iceberg melalui SQL. Logika dasarnya adalah bahwa Agent dibangun di atas model besar (LLM), dan model besar tersebut selama proses pelatihan telah mengembangkan kemampuan pemrosesan yang matang untuk sintaks SQL dan format data Iceberg. Menyimpan semua data tabel dalam format Iceberg di S3 memungkinkan Agent memproses data dengan efisien tanpa perlu mempelajari berbagai API akses yang kompleks. Saat ini, Agent menunjukkan tingkat kecocokan yang tinggi dengan S3 dan Iceberg.

Ketika kemampuan Iceberg diperkenalkan ke S3, hal itu memicu gelombang inovasi baru. Sumber data seperti Postgres, Oracle mulai menulis langsung ke Iceberg, dan sistem Agent dapat berinteraksi langsung dengan tabel-tabel ini. Dan dengan diluncurkannya S3 Vectors, semakin banyak aplikasi AI yang mulai menggunakan vektor sebagai pembawa memori bersama, sehingga menyuntikkan "keadaan" (state) ke dalam pengalaman interaksi AI.

Mai-Lan juga mencatat bahwa vektor telah diperkenalkan sebagai tipe data native S3. Penerapan vektor terutama berpusat pada dua dimensi: pertama, menggunakan vektor untuk membangun informasi konteks bagi data yang disimpan di S3; kedua, menggunakan vektor sebagai memori bersama. Dalam lima bulan setelah peluncuran S3 Vectors, umpan balik pasar sesuai dengan harapan. Banyak pelanggan mulai menggunakan fitur ini, menghasilkan vektor melalui model embedding untuk memperkaya konteks data. Penggunaan S3 Vectors sebagai ruang memori untuk sistem Agent mengalami pertumbuhan yang eksplosif.

Perlu disebutkan bahwa S3 Files dirilis beberapa minggu yang lalu, memungkinkan Agent memproses data di S3 melalui standar POSIX, yaitu dengan cara sistem file. Dalam sistem Agent, model besar sangat memperhatikan bentuk "file". Baik pustaka Python maupun skrip Shell adalah konten yang familiar selama proses pelatihan model besar. Agent secara alami cenderung menggunakan file sebagai antarmuka data.

Untuk itu, ide desain S3 Files adalah memasang sistem file EFS pada bucket penyimpanan S3. Melalui mekanisme ini, pengguna dapat memproses data S3 berdasarkan standar POSIX dalam sistem file: file kecil dapat diakses lebih cepat melalui cache EFS, sedangkan file besar dapat ditransmisikan secara streaming langsung dari S3. Hal ini memungkinkan Agent berinteraksi secara native dengan data S3 menggunakan bahasa sistem file yang familiar, dan melihat sistem file bersama sebagai "ruang memori bersama" dari S3.

Dari perspektif perkembangan kemampuan memori model besar, kemajuan ini sangat berarti. Pengalaman AI saat ini secara bertahap memperkenalkan konteks percakapan yang lebih dalam dan interaksi personalisasi — baik di antara Agent, antara manusia dan Agent, maupun antara Agent dan data, kinerja model terus berkembang. Dengan perluasan lebih lanjut melalui antarmuka alami sistem file ini, kemampuan memori sistem Agent diharapkan dapat ditingkatkan ke tingkat yang lebih dalam.

Penulis menyadari, dari tahun 2006 yang didominasi data semi-terstruktur seperti gambar, hingga data analitik di kemudian hari, dari data warehouse awal hingga kebangkitan danau data, Amazon Web Services saat ini sedang mendorong Amazon S3 dengan kuat untuk menjadi landasan kunci yang menangani beban kerja AI, guna menyesuaikan diri dengan tuntutan pelanggan saat ini. Mai-Lan berpendapat bahwa inti desain Amazon S3 adalah mendorong pertumbuhan tipe data utama dengan cara yang ekonomis, dan selalu berpegang pada prinsip-prinsip seperti ketersediaan, daya tahan, dan ketahanan data. Dan inilah alasan mengapa pelanggan terus mempercayakan bisnis datanya kepada S3 selama 20 tahun, dan ini juga akan menopang kemungkinannya untuk 20 tahun ke depan.

(Penulis artikel | Yang Li, Editor | Yang Lin)

Kripto yang Sedang Tren

Pertanyaan Terkait

QApa perbedaan mendasar dalam cara konsumsi data antara Agent AI dan insinyur manusia?

AAgent AI mengonsumsi data dengan cara yang sangat aktif dan agresif. Ia bekerja dalam mode 'paralel dan optimasi', menjalankan puluhan hingga ratusan kueri secara bersamaan untuk menemukan jalur terbaik. Frekuensi pemanggilan data oleh Agent jauh lebih tinggi (beberapa orde magnitudo) dan throughput data meningkat secara eksponensial dibandingkan dengan konsumsi data oleh manusia.

QApa tiga transformasi utama yang baru-baru ini diterapkan pada Amazon S3 untuk memenuhi kebutuhan era AI?

AAmazon S3 baru-baru ini menerapkan tiga transformasi utama: S3 Table (format tabel dengan dukungan native untuk Apache Iceberg), S3 Files (memungkinkan akses data S3 melalui sistem file POSIX), dan S3 Vectors (memperkenalkan vektor sebagai tipe data native untuk menyimpan konteks dan memori bersama).

QMengapa format Apache Iceberg dan S3 Table sangat cocok untuk interaksi dengan Agent AI?

AKarena Agent AI dibangun di atas model bahasa besar (LLM) yang telah terlatih dengan baik dalam sintaks SQL dan format data Iceberg. Dengan menyimpan semua data tabel dalam format Iceberg di S3, Agent dapat memproses data secara efisien tanpa perlu mempelajari berbagai API akses yang kompleks, sehingga mencapai kecocokan yang tinggi.

QBagaimana cara kerja S3 Files, dan apa manfaatnya bagi Agent AI?

AS3 Files bekerja dengan memasang sistem file EFS pada bucket S3. Ini memungkinkan pengguna memproses data S3 berdasarkan standar POSIX: file kecil diakses dengan cepat melalui cache EFS, file besar dialirkan langsung dari S3. Manfaatnya bagi Agent AI adalah ia dapat berinteraksi secara native dengan data S3 menggunakan bahasa sistem file yang sudah dikenal (seperti pustaka Python atau skrip Shell), dan menganggap sistem file bersama sebagai 'ruang memori bersama' dari S3.

QMenurut Mai-Lan, mengapa Amazon S3 terus menjadi pilihan utama pelanggan untuk beban kerja data mereka, termasuk di era AI?

AKarena desain inti Amazon S3 berfokus pada mendorong pertumbuhan tipe data utama dengan cara yang ekonomis, sekaligus tetap mematuhi prinsip-prinsip ketersediaan data, daya tahan, dan ketahanan. Keandalan dan prinsip-prinsip inilah yang selama 20 tahun membuat pelanggan mempercayakan bisnis data mereka ke S3, dan akan menjadi dasar untuk 20 tahun ke depannya, termasuk dalam menangani ledakan konsumsi data di era Agent AI.

Bacaan Terkait

Dari Kesuksesan di GitHub Hingga Presentasi Oral di ECCV, Pengembang Global Bereksplorasi dengan LingBot-Map

Robot kini mempelajari kemampuan yang dulu hanya dimiliki manusia: mengingat dunia yang telah dilalui. Ant Financial Lingo telah merilis model dasar rekonstruksi 3D streaming sumber terbuka bernama LingBot-Map, yang mengeksplorasi jalur teknis baru dalam masalah inti "bagaimana robot mengingat ruang". Hanya dengan kamera RGB biasa, model ini memungkinkan robot untuk memperkirakan pose kamera dan merekonstruksi struktur tiga dimensi secara real-time selama proses akuisisi video, mengisi celah teknologi kunci dalam persepsi ruang waktu nyata. Proyek GitHub resminya telah mendapatkan 16.9K Stars dan 1.9K Forks. Kini, penelitian ini mendapatkan pengakuan baru: makalahnya "Geometric Context Transformer for Streaming 3D Reconstruction" diterima sebagai presentasi lisan (Oral) di ECCV 2026. Ini melengkapi verifikasi ganda dari ekosistem pengembang dan akademisi. Sebelumnya, komunitas sumber terbuka telah aktif mengembangkan proyek ini, seperti membuat antarmuka desktop untuk Mac, skema peluncuran satu klik, adaptasi untuk perangkat keras konsumen seperti RTX 4060 8GB, dan eksplorasi pintu masuk akuisisi baru seperti kacamata pintar Ray-Ban Meta Gen-2. Inti dari LingBot-Map adalah mengatasi tantangan manajemen konteks dalam rekonstruksi streaming: bagaimana menjaga memori jangka panjang tanpa biaya komputasi dan penyimpanan yang tak terbatas. Model ini mengusulkan Geometric Context Attention (GCA), yang membagi status streaming menjadi tiga lapisan: Anchor Context (membangun koordinat ruang stabil), Local Pose-Reference Window (mempertahankan posisi lokal yang presisi), dan Trajectory Memory (mengompresi sejarah jangka panjang). Desain ini mengurangi token yang dibutuhkan hampir 80 kali lipat dibandingkan perhatian kausal tradisional untuk urutan 10.000 frame, dengan konsumsi memori dan komputasi yang hampir konstan. Dalam pengujian benchmark, LingBot-Map menunjukkan kinerja unggul. Pada dataset Oxford Spires, ia mengungguli metode baseline offline terkuat dan metode aliran online lainnya, mempertahankan konsistensi geometris jarak jauh tanpa deteksi loop eksplisit, dengan kecepatan inferensi 20.29 FPS. Pada rekonstruksi awan titik di dataset ETH3D, 7-Scenes, dan NRGBD, LingBot-Map mencapai skor F1 tertinggi, menghasilkan struktur yang lebih presisi dan lengkap. LingBot-Map adalah bagian dari sistem persepsi ruang robot Ant Financial Lingo, bersama LingBot-Vision (pemahaman struktur visual) dan LingBot-Depth (persepsi ruang presisi tinggi). Bersama-sama, mereka membentuk tautan kecerdasan spasial dari persepsi, pemahaman, hingga tindakan, mendorong robot dari sekadar melihat dunia menuju memahami dan memanfaatkannya.

marsbit9m yang lalu

Dari Kesuksesan di GitHub Hingga Presentasi Oral di ECCV, Pengembang Global Bereksplorasi dengan LingBot-Map

marsbit9m yang lalu

Kotlin 'J God' dalam Wawancara Kontroversial Dua Jam: Saya Lebih Memilih Kehilangan 80% Peluang Kerja Daripada Menggunakan AI untuk Pemrograman

Dalam wawancara kontroversial selama dua jam, Jake Wharton, pakar Kotlin yang dikenal sebagai "J God", menyatakan dengan tegas bahwa ia menolak menggunakan AI untuk pemrograman. Ia bahkan bersedia kehilangan 80% peluang kerja demi prinsip ini, dengan alasan etika dan kekhawatiran akan kualitas perangkat lunak jangka panjang. Wharton mengkritik keras perusahaan yang memaksa insinyur menggunakan AI, menyebutnya sebagai keputusan sepihak dari manajemen yang mengabaikan pertimbangan teknis. Menurutnya, AI tidak boleh menjadi fondasi kemampuan rekayasa, melainkan hanya alat bantu. Ia juga menyoroti risiko ketergantungan berlebihan pada AI, yang menurutnya dapat mengikis kemampuan dan daya tawar insinyur. Selain AI, Wharton menolak bekerja di perusahaan kripto, yang dianggapnya mirip skema Ponzi. Ia lebih memilih perusahaan kecil dan fokus yang mendukung open source. Saat ini, ia bergabung dengan Skylight, perusahaan yang menurutnya menggunakan AI dengan bijak dan tidak memaksakannya. Ia juga membahas masa depan Kotlin, mengakui bahwa Java terus berkembang, tetapi Kotlin tetap unggul dalam penanganan null safety dan ekosistem alatnya. Meski mengagumi desain bahasa Swift dan Rust, Wharton yakin Kotlin akan tetap relevan berkat komunitas dan alat pendukungnya yang matang. Secara keseluruhan, Wharton menekankan pentingnya pemahaman mendalam dalam pengembangan perangkat lunak dan menolak tren industri yang dianggapnya berisiko dan tidak etis.

marsbit14m yang lalu

Kotlin 'J God' dalam Wawancara Kontroversial Dua Jam: Saya Lebih Memilih Kehilangan 80% Peluang Kerja Daripada Menggunakan AI untuk Pemrograman

marsbit14m yang lalu

AI Mendefinisikan Ulang Apa Itu Guru yang Baik

AI telah memasuki ruang kelas, dengan tingkat adopsi lebih dari 30% dalam persiapan pelajaran K-12 di Tiongkok. Namun, pertanyaan yang mengemuka bukan lagi apakah AI akan menggantikan guru, melainkan bagaimana peran guru berevolusi. Penelitian menunjukkan AI unggul dalam tugas standar seperti pembuatan materi dan analisis data, sehingga guru hemat waktu. Namun, eksperimen seperti yang dilakukan di Turki mengungkap risiko "efek tongkat": siswa yang mengandalkan AI tanpa batasan menunjukkan penurunan performa saat ujian, dibandingkan dengan mereka yang menggunakan AI dengan "pembatas" yang dirancang guru untuk hanya memberikan petunjuk. AI mengambil alih tugas yang terstandarisasi, tetapi tidak dapat menggantikan penilaian, kehadiran fisik, dan pengaruh manusiawi seorang guru. Faktor kunci kesuksesan siswa justru "efikasi kolektif guru"—keyakinan bersama para guru bahwa mereka dapat memengaruhi prestasi anak didik. Kerangka literasi AI guru menekankan tiga lapisan: mengetahui keandalan AI, memerintah AI untuk bekerja, dan yang paling penting, menggunakan AI untuk mendesain ulang proses pembelajaran. Lapisan ketiga ini masih jarang dilatihkan. AI memberi setiap guru "bonus waktu", tetapi bagaimana memanfaatkannya menjadi titik pembeda. Beberapa guru menggunakannya untuk interaksi yang lebih personal, sementara yang lain terjebak dalam "kemalasan metakognitif", mengandalkan AI tanpa penilaian kritis. AI menjadikan bimbingan individual secara biaya menjadi mungkin, menjawab sebagian "masalah dua sigma" Bloom. Namun, eksperimen menunjukkan bimbingan AI yang murah tidak otomatis efektif. Di sini, peran guru justru semakin krusial: untuk memastikan bimbingan itu dilakukan dengan benar. AI mungkin membuka jalan dari skor 30 ke 70, tetapi perjalanan dari 70 ke 100—tempat di mana ketekunan, penilaian kritis, dan keyakinan diri dibangun—tetap membutuhkan seorang guru yang hadir untuk mengetahui kapan harus membantu dan kapan harus mundur, membiarkan siswa berpikir sendiri.

marsbit15m yang lalu

AI Mendefinisikan Ulang Apa Itu Guru yang Baik

marsbit15m yang lalu

Trading

Spot

Artikel Populer

Cara Membeli ERA

Selamat datang di HTX.com! Kami telah membuat pembelian Caldera (ERA) menjadi mudah dan nyaman. Ikuti panduan langkah demi langkah kami untuk memulai perjalanan kripto Anda.Langkah 1: Buat Akun HTX AndaGunakan alamat email atau nomor ponsel Anda untuk mendaftar akun gratis di HTX. Rasakan perjalanan pendaftaran yang mudah dan buka semua fitur.Dapatkan Akun SayaLangkah 2: Buka Beli Kripto, lalu Pilih Metode Pembayaran AndaKartu Kredit/Debit: Gunakan Visa atau Mastercard Anda untuk membeli Caldera (ERA) secara instan.Saldo: Gunakan dana dari saldo akun HTX Anda untuk melakukan trading dengan lancar.Pihak Ketiga: Kami telah menambahkan metode pembayaran populer seperti Google Pay dan Apple Pay untuk meningkatkan kenyamanan.P2P: Lakukan trading langsung dengan pengguna lain di HTX.Over-the-Counter (OTC): Kami menawarkan layanan yang dibuat khusus dan kurs yang kompetitif bagi para trader.Langkah 3: Simpan Caldera (ERA) AndaSetelah melakukan pembelian, simpan Caldera (ERA) di akun HTX Anda. Selain itu, Anda dapat mengirimkannya ke tempat lain melalui transfer blockchain atau menggunakannya untuk memperdagangkan mata uang kripto lainnya.Langkah 4: Lakukan trading Caldera (ERA)Lakukan trading Caldera (ERA) dengan mudah di pasar spot HTX. Cukup akses akun Anda, pilih pasangan perdagangan, jalankan trading, lalu pantau secara real-time. Kami menawarkan pengalaman yang ramah pengguna baik untuk pemula maupun trader berpengalaman.

1.8k Total TayanganDipublikasikan pada 2025.07.17Diperbarui pada 2026.06.02

Cara Membeli ERA

Diskusi

Selamat datang di Komunitas HTX. Di sini, Anda bisa terus mendapatkan informasi terbaru tentang perkembangan platform terkini dan mendapatkan akses ke wawasan pasar profesional. Pendapat pengguna mengenai harga ERA (ERA) disajikan di bawah ini.

活动图片