GPT-5 тоже мучается с "вертится на языке", Google проверил 4,5 миллиона раз: ключи потеряны

marsbitОпубликовано 2026-08-14Обновлено 2026-08-14

Введение

Google провела исследование «Пустые полки или потерянные ключи?», выявив, что современные большие языковые модели (LLM), такие как GPT-5 и Gemini 3, сталкиваются с проблемой, похожей на человеческий феномен «кончика языка»: они часто не могут извлечь факты, которые явно хранятся в их параметрах. Исследователи создали бенчмарк WikiProfile (2150 фактов из Википедии) и протестировали 13 моделей, сделав около 4.5 миллионов запросов. Ключевые выводы: * **Основная проблема — не кодирование, а извлечение.** Модели кодируют 95-98% фактов, но при прямом запросе не могут вспомнить 26-34% из них. Даже с включённым «размышлением» (thinking) 11-12% фактов остаются недоступными. * **«Забывание» затрагивает определённые типы знаний:** 1) **Редкие факты** — они кодируются почти так же хорошо, как популярные, но извлекаются гораздо хуже. 2) **Обратные вопросы** (например, «сын Марии» вместо «мать Тома») — модель знает связь, но не может её сформулировать в ответе, хотя в заданиях с выбором справляется хорошо. * **«Размышление» помогает вспомнить.** Механизм thinking помогает восстановить 40-65% фактов, которые есть в памяти, но не всплывают сразу. Это работает через «расширяющуюся активацию» — генерацию связанных контекстов, которые подводят к правильному ответу. * **Масштабирование (scaling) решает проблему кодирования, но не извлечения.** Увеличение параметров модели снижает долю «невыученных» фактов, но доля «невспоминаемых» остаётся высокой и становится основной причиной ошибок ...

Имя прямо вертится на языке.

Вы видите знакомое лицо, но никак не можете вспомнить его имя. В психологии для этого явления есть название: «феномен кончика языка» (tip-of-the-tongue).

Теперь Google в ходе исследования обнаружил, что у GPT-5 и Gemini 3 наблюдается та же самая проблема.

Эти модели поместили 95%–98% проверяемых фактов в свои параметры. Но если спросить их напрямую, они не могут ответить на 26%–34% фактов.

Если включить режим «размышления» (thinking) и дать подумать подольше, всё равно остаётся 11%–12%, которые никак не вспомнить.

Когда большая модель не может ответить, во многих случаях это не означает, что у неё в «мозгах» этого нет. Она это учила, но не может извлечь.

Это исследование называется «Пустые полки или потерянные ключи?» (Empty Shelves or Lost Keys?), принято на конференцию ICML 2026.

12 августа Google Research опубликовал в блоге краткий обзор результатов, одновременно представив набор данных и эталонный тест под названием WikiProfile.

Полки не пусты, ключи потеряны

Модель может ошибаться по двум причинам.

Первая — она вообще этого не изучала. Тогда нужно добавлять данные и параметры на этапе предварительного обучения. Вторая — она изучала, но не может извлечь при другом способе формулировки вопроса, и это уже проблема пост-обучения и этапа логического вывода.

Обе эти проблемы раньше сводили к вопросу точности.

Предложенная Google концепция «профиля знаний» (knowledge profile) перестаёт задаваться вопросом «верно ли ответила модель на этот вопрос», а вместо этого определяет, «в каком состоянии находится этот факт в памяти модели». Всего выделяется пять состояний.
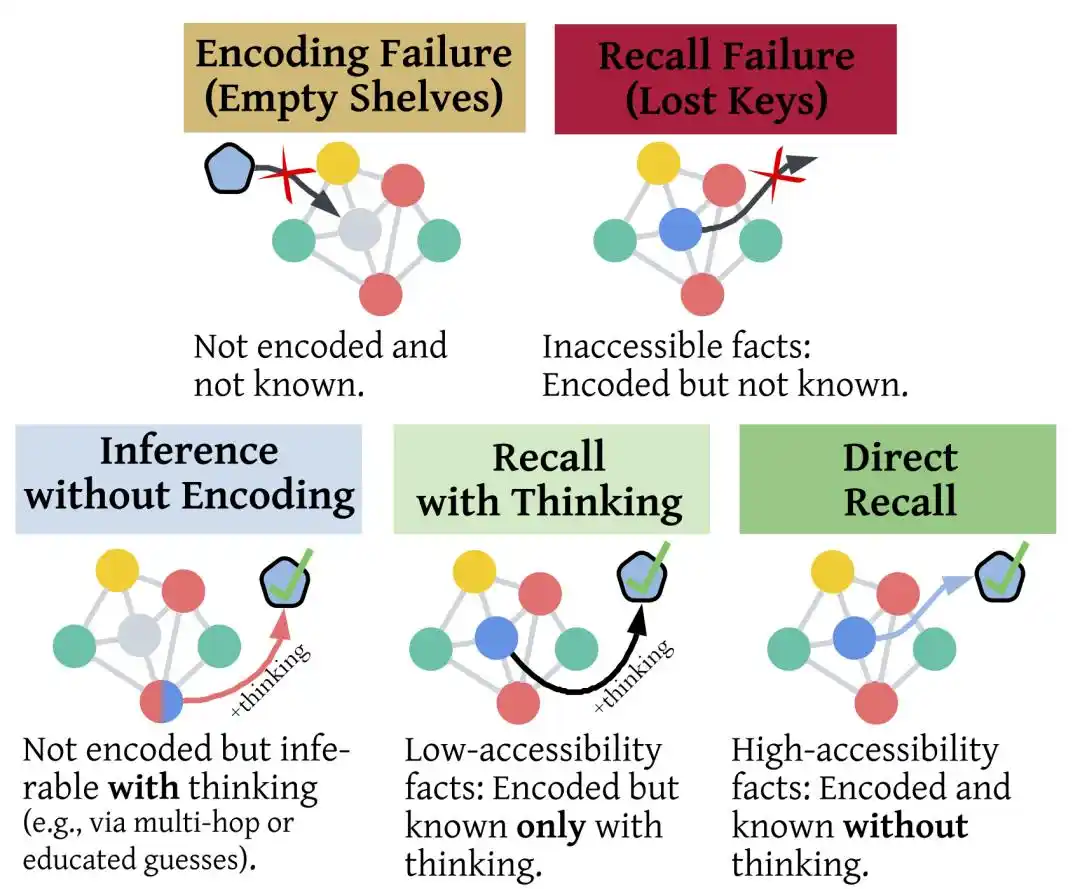
«Профиль знаний» делит каждый факт на пять состояний: сбой кодирования, сбой извлечения, прямое извлечение, извлечение с помощью thinking, ответ угадан без хранения в памяти.

Один и тот же неверный ответ в разных состояниях требует совершенно разных методов исправления.

Как определить, сохранён ли факт в памяти?

Метод заключается в том, чтобы обрезать оригинальный текст Википедии до момента появления ответа и заставить модель продолжить написание; или напрямую задать вопрос после того же контекста.

В этих двух типах задач запрещено включать thinking, чтобы отделить «запомнил» от «вывел логически».
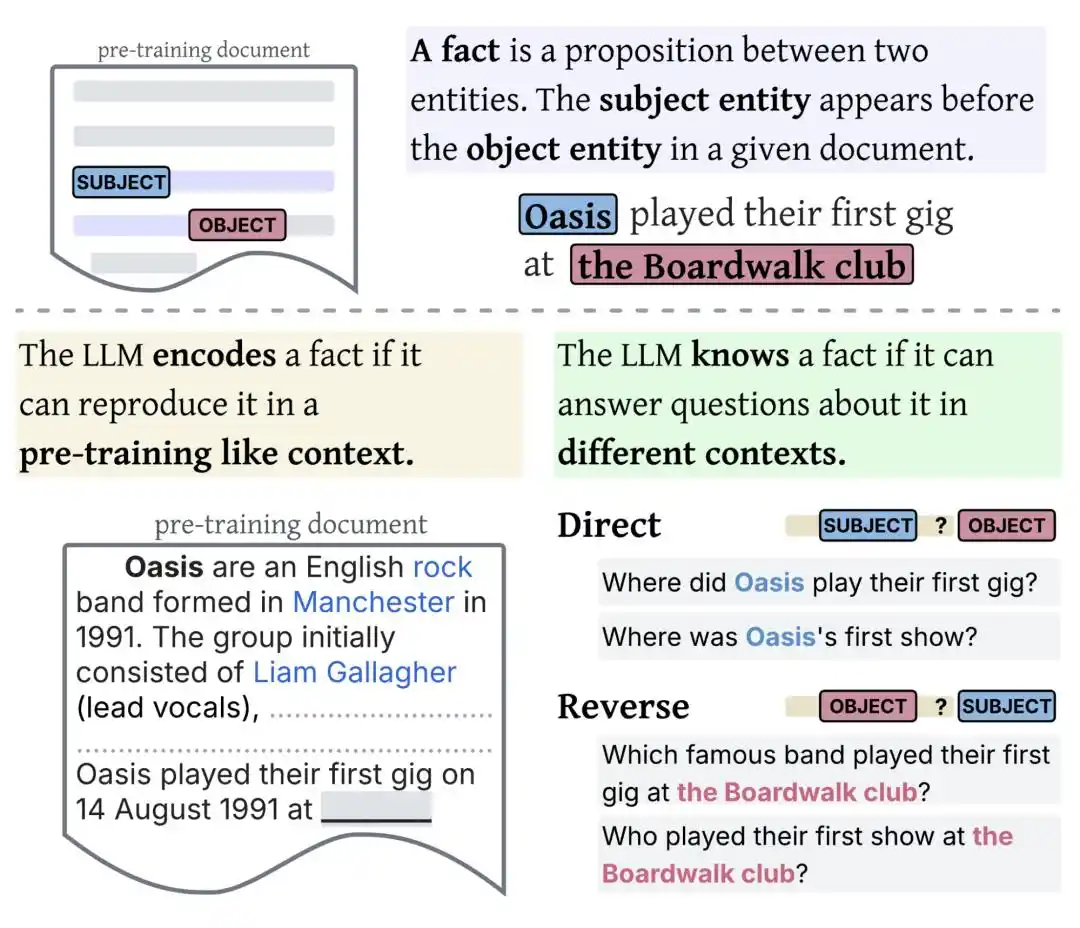
Слева проверяется, сохранён ли факт: обрезка текста Википедии и дополнение моделью. Справа проверяется, может ли модель ответить: вопросы с разной формулировкой, в прямой и обратной форме.

Эталонный тест называется WikiProfile, всего 2150 фактов, все взяты из англоязычной Википедии.

Каждому факту соответствует 10 вопросов: 2 на проверку сохранения, 4 на самостоятельный ответ, 4 на выбор из вариантов. Итого 21500 вопросов.

Создание вопросов полностью поручено модели: Gemini-2.5-Pro генерирует, Google Search проверяет каждый вопрос. Если ответ неоднозначен или вопрос двусмыслен, вместе с ним отбрасывается весь факт. Затем проводится ручная проверка, отбрасывается менее 2%.

Тестировались 13 моделей, охватывающих семейства Gemini 3, GPT-5, GPT-4.1 и Gemma 3. Каждая модель запускалась с включённым и выключенным thinking, по каждому вопросу делалось 8 выборок, собрано около 4,5 миллионов ответов.

Полное тестирование одной передовой модели стоит примерно 500 долларов.

Результат — это цифры в начале статьи.

В ошибках передовых моделей, связанных с фактами, «невозможность извлечь» уже превзошла «не изучено» и стало основной проблемой.

Неизвлекаемое застревает в двух одинаковых местах

Первое — малопопулярные знания.

Ранее основным объяснением была недостаточная ёмкость модели — некоторые малопопулярные факты просто не заучивались.

Согласно данным этого исследования, малопопулярные знания на самом деле сохранены. Gemini-3-Pro сохранила 94,5% малопопулярных фактов, популярных — 99,5%, разница всего 5 процентных пунктов.

Но когда дело доходит до ответа, малопопулярные факты падают до 63,3%, а популярные остаются на уровне 84,7%, разница в 21 пункт.

При сохранении разница почти незаметна, при извлечении разница в четыре раза.
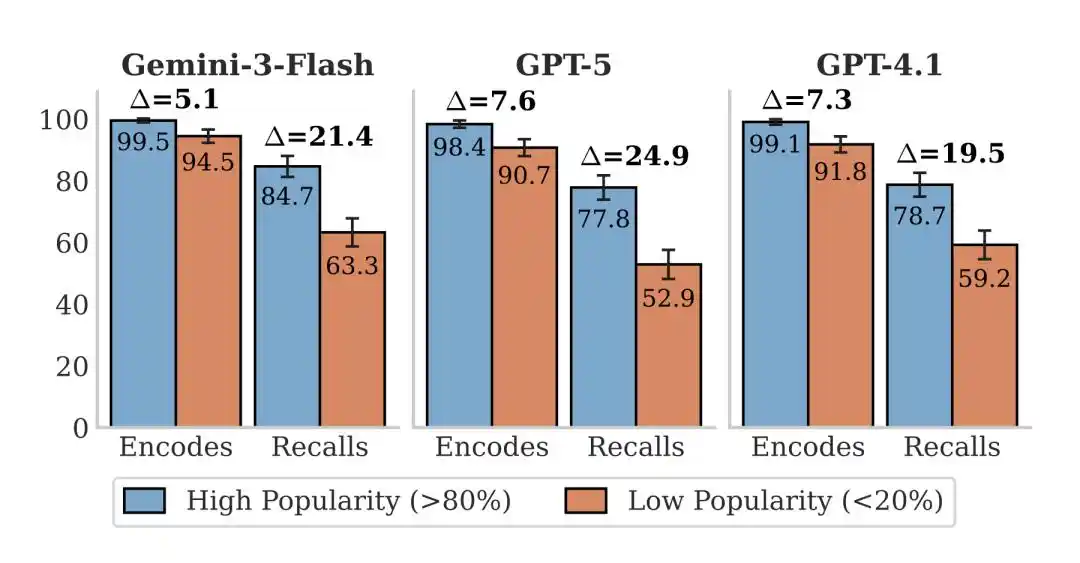
Сравнение малопопулярных фактов (последние 20%) и популярных (первые 20%). Разница в коэффициенте сохранения мала, разница в коэффициенте прямого извлечения заметно больше.

У GPT-5 разрыв ещё больше.

Она сохранила 90,7% малопопулярных фактов и 98,4% популярных. Но когда нужно ответить, малопопулярных остаётся только 52,9%, а популярных — 77,8%.

Почти половина малопопулярных фактов явно лежит в модели, но их просто не получается вызвать.

Разница при сохранении невелика, разница при извлечении велика. Истина о проблеме «длинного хвоста» заключается не в том, что модель не видела эти малопопулярные факты, а в том, что эти знания труднее активировать.

Второй сценарий — обратные вопросы. Спросите ИИ, кто мать Тома Круза, он ответит быстро и точно. Спросите наоборот — кто сын этой женщины, и он зависнет.

В статье 2023 года это назвали «проклятием обращения» (reversal curse): модель выучила, что «A — это B», но не может автоматически обобщить до «B — это A». Объяснение в то время было: двунаправленная связь вообще не была усвоена.

Google превратил ту же серию вопросов в тесты с четырьмя вариантами ответов, и результат немедленно изменился.

Коэффициент извлечения GPT-5 при прямых вопросах составляет 82,9%, при обратных падает до 74%. Но как только переключаются на задачи распознавания с выбором из вариантов, обратные вопросы не только не становятся сложнее прямых, но 9 из 13 моделей справляются с ними даже лучше, остальные 4 показывают одинаковый результат.

Задачи с выбором из вариантов решаются, но стоит перейти на вопросы с открытым ответом — модель не может ответить.
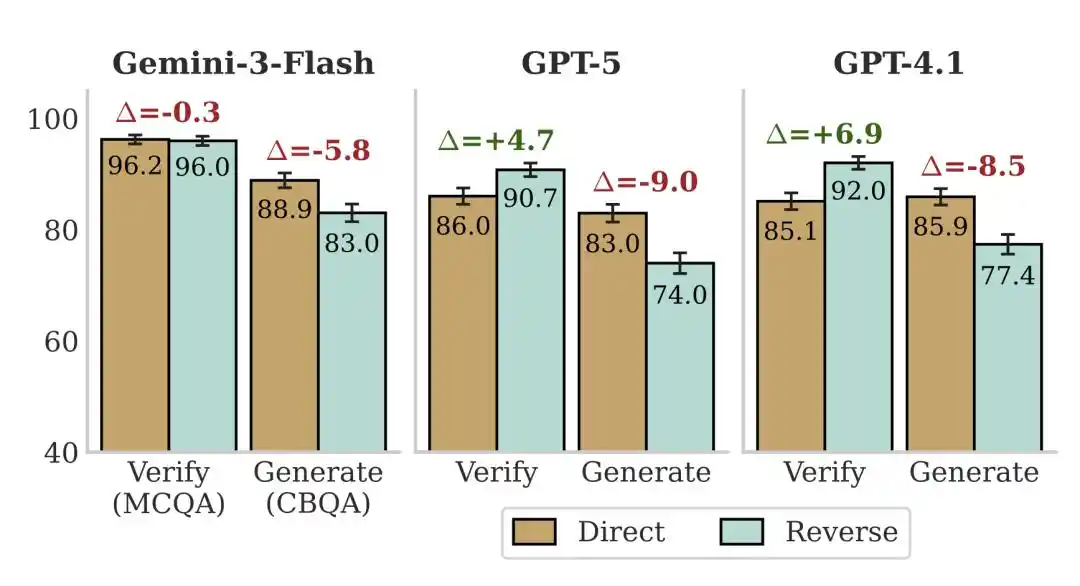
Одна и та же серия прямых и обратных вопросов. В задачах распознавания с выбором из 4 вариантов обратные вопросы не сложнее прямых. В задачах генерации с закрытой книгой обратные вопросы заметно сложнее.

Это говорит о том, что связь явно присутствует, реальная проблема — в том, как её извлечь.

Объяснение авторов: когда факт сохраняется, вместе с ним в память закладывается контекст, формулировка и порядок, в котором он был представлен.

Если способ, которым вы задаёте вопрос, отклоняется от того, как это было во время обучения, ключ не подходит к замку.

Другая роль thinking — помочь вспомнить

Вопросы в WikiProfile — это «спросил — ответил», без промежуточных шагов рассуждения.

«В каком клубе состоялось первое выступление Oasis?» — на такой вопрос либо помнишь, либо нет.

Теоретически, если дать модели подумать подольше, это не должно сильно помочь.

Но thinking действительно вытягивает забытое. Для фактов, которые были сохранены, но на которые не удалось ответить, оно возвращает 40%–65%.

Ключевая подсказка скрыта в его предпочтениях: для фактов, которые вообще не были сохранены, thinking может вернуть только 5%–15%.
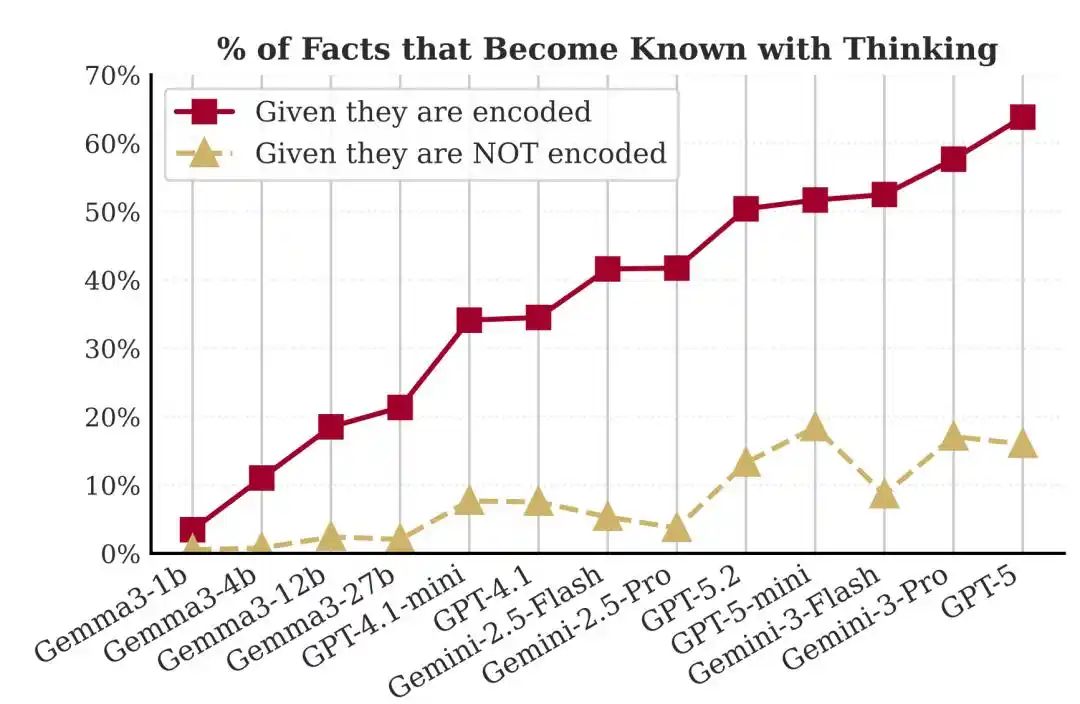
Доля фактов, восстановленных после включения thinking. Сохранённые в параметрах факты возвращаются на 40%–65%, не сохранённые — только на 5%–15%.

Она не выводит ответ, используя другие знания, а ищет ключ на месте.

Авторы также исключили более простое объяснение.

Можно подумать, что thinking просто позволяет модели давать более разнообразные ответы, увеличивая шанс угадать один раз из восьми попыток. Если бы это было так, ответы должны были бы быть более разбросанными.

В реальности всё наоборот: при включённом thinking количество правильных ответов на один и тот же вопрос в восьми попытках становится более концентрированным.

Наибольшая польза проявляется именно в двух самых проблемных местах, упомянутых выше.

Разрыв между малопопулярными и популярными фактами у Gemini-3-Pro сократился с 21,4 пункта до 12,5. Разрыв между прямыми и обратными вопросами у GPT-5 сократился с 9 пунктов до 2. Где самые большие трудности, туда и направляются усилия.

Сопутствующая статья Google «Размышлять, чтобы вспомнить» (Thinking to Recall) даёт механистическое объяснение:

Во-первых, вычислительный буфер: генерируемые токены размышлений, даже если их содержание само по себе не имеет смысла, предоставляют модели дополнительные неявные вычислительные ресурсы.

Во-вторых, прайминг фактами: когда модель сначала выдаёт ряд связанных фактов, она строит семантический мост к правильному ответу.

В человеческом познании это называется «распространённая активация» (spreading activation).

Если не можете вспомнить чьё-то имя, сначала вспомните, в какой компании он работает, какую носит причёску, при каких обстоятельствах вы встречались в последний раз — имя часто само всплывает.

Способ избавления от «феномена кончика языка» у людей и моделей оказывается одним и тем же.

Но у этого способа есть и цена.

Та же статья предупреждает: если промежуточные факты в цепочке рассуждений выдуманы, вероятность галлюцинаций в конечном ответе оказывается выше.

Если мост построен криво, чем дальше идёшь, тем сильнее ошибаешься.

Увеличение масштаба равносильно пополнению запасов, но не выдаче ключей

Возьмём открытое семейство моделей Gemma 3 в качестве линейки.

Когда количество параметров увеличивается с 1B до 27B, частота сбоев кодирования падает с 85% до 23%.

Масштаб действительно пополняет запасы, полки явно заполняются. Но частота сбоев извлечения не снижается синхронно. Её доля в оставшихся ошибках постоянно растёт и на модели 27B становится основным компонентом ошибок.

Для передовых моделей ситуация ещё более крайняя: сбои извлечения составляют более 70% всех ошибок GPT-5.2, и чем сильнее модель, тем выше эта доля.
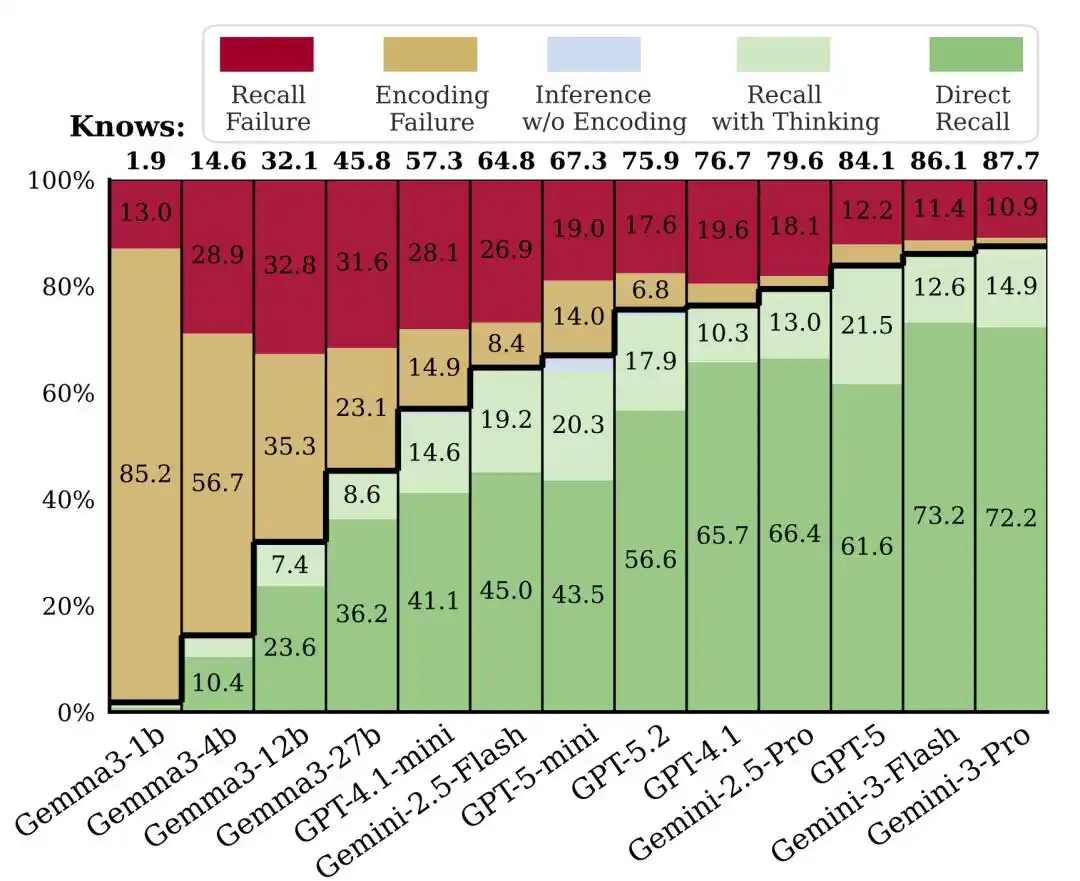
Распределение пяти состояний для 13 моделей. С увеличением параметров сбои кодирования постоянно сокращаются, сбои извлечения почти не меняются.

Масштаб улучшает то, сколько сохранено, а не то, сколько можно извлечь.

Это не ставит крест на scaling laws, а очерчивает их границы.

Поскольку доля сохранённых фактов уже достигла потолка в 95%–98%, дальнейшее увеличение параметров и данных принесёт видимо уменьшающийся прирост точности.

Следующий этап выигрыша, скорее всего, придёт от методов пост-обучения и логического вывода, то есть от того, как эффективно использовать уже сохранённые знания.

Конечно, может помочь дополнение извлечением (retrieval augmentation).

Но авторы также отмечают: знания в параметрах по-прежнему связаны с беглостью, скоростью реакции и кросс-контекстной интеграцией, их сложно полностью заменить внешним поиском.

Сначала она должна понять, что не может вспомнить

Итак, когда нужно дать модели подумать подольше?

В статье эта проблема определяется как метапознание, то есть способность модели оценивать собственное состояние: она должна сначала осознать «я не могу ответить прямо сейчас», чтобы понять, что этот вопрос стоит того, чтобы включить thinking и подумать подольше.

В последние два года стандартным ответом на вопрос о повышении надёжности моделей было добавление больше данных и увеличение параметров.

Это исследование проясняет ситуацию: на уровне фактов полки передовых моделей уже забиты достаточно полно. Следующее испытание — сможет ли модель сама достать товар с полки.

Следующий шаг ещё сложнее: сначала она должна понять, что не может вспомнить.

Источники:

https://research.google/blog/empty-shelves-or-lost-keys-recall-is-the-bottleneck-for-parametric-factuality/

https://aihot.virxact.com/items/cmsqe6mat01bsroli3hw71nz7

Эта статья из WeChat-официального аккаунта «Новая Эра ИИ» (新智元), автор: ASI启示录

Связанные с этим вопросы

QЧто такое «эффект кончика языка» в исследовании Google о GPT-5 и Gemini 3?

A«Эффект кончика языка» — это психологический феномен, когда человек не может вспомнить известное ему слово или имя. В исследовании Google обнаружено, что модели GPT-5 и Gemini 3 демонстрируют аналогичное поведение: они хранят факты в параметрах, но не могут их извлечь при прямом запросе.

QКакой метод использовали в исследовании, чтобы определить, сохранила ли модель факт?

AИсследователи использовали метод «профилирования знаний». Они брали текст из Википедии, обрезали его перед появлением ответа, и просили модель продолжить текст. Если модель правильно завершала предложение, факт считался сохранённым. Также задавали прямые вопросы в том же контексте без использования функции размышления (thinking).

QКакие два основных сценария, где модели испытывают наибольшие трудности с извлечением информации?

AПервый сценарий — малопопулярные (редкие) факты. Хотя они сохраняются почти так же хорошо, как популярные, извлекаются гораздо хуже. Второй сценарий — обратные вопросы. Модели хорошо отвечают на вопрос «А является Б», но с трудом отвечают на вопрос «Б является А», хотя в тестах с множественным выбором эта связь распознаётся.

QКак функция размышления (thinking) помогает моделям вспомнить информацию?

AФункция thinking помогает моделям «вспомнить» информацию, предоставляя дополнительное вычислительное время (буфер) и активируя связанные факты через механизм «распространения активации». Это аналогично тому, как человек, пытаясь вспомнить имя, сначала вспоминает связанные детали. Thinking особенно эффективна для фактов, уже сохранённых в модели, извлекая 40–65% из них.

QЧто исследование говорит об увеличении масштаба модели (scaling) для решения проблемы извлечения фактов?

AИсследование показывает, что увеличение масштаба (параметров и данных) в основном улучшает способность модели сохранять факты («наполнять полки»), но почти не влияет на способность их извлекать («находить ключи»). У более крупных моделей основная доля ошибок приходится на неудачное извлечение, а не на отсутствие знаний. Это указывает на то, что будущие улучшения должны быть сосредоточены на методах после обучения и логического вывода.

Похожее

CPI спровоцировал ожидания повышения ставок! Крипторынок убивает и быков, и медведей, ликвидировано почти 100 тысяч позиций

Заголовок: CPI спровоцировал ожидания повышения ставок! На крипторынке уничтожены и быки, и медведи, почти 100 000 ликвидированных позиций. Краткое изложение на русском: Бюро трудовой статистики США опубликовало данные по индексу потребительских цен (CPI) за август. Общий показатель вырос на 3,4% в годовом исчислении, а базовый CPI (без учета продуктов питания и энергоносителей) замедлился до 2,4%, что является самым низким уровнем с марта 2021 года. Однако месячный рост базового CPI составил 0,3%, превысив ожидания. Цены на бензин выросли на 3,9%, что внесло значительный вклад в общий рост индекса. Эти данные резко усилили ожидания ужесточения денежно-кредитной политики ФРС. Согласно данным Polymarket, вероятность повышения процентной ставки на 25 базисных пунктов на предстоящем заседании 16 сентября выросла до 80%. Аналитики, включая экспертов из CICC, ожидают этого шага, отмечая, что инфляционное давление сохраняется, особенно в сфере услуг. На криптовалютном рынке данные CPI вызвали высокую волатильность. Bitcoin сначала упал примерно до $76 000, затем вырос почти до $79 837, после чего снова откатился вниз. За 24 часа общая сумма ликвидированных позиций на рынке достигла $674 млн, пострадали около 94 000 трейдеров. Кратковременное пересечение 50-дневной скользящей средней выше 200-дневной (так называемый "золотой крест") на дневном графике Bitcoin быстро стало недействительным. Технический анализ указывает на сильное сопротивление в зоне $82 000 - $85 000 для Bitcoin, где сосредоточено много монет долгосрочных держателей. Ключевой уровень поддержки находится около $75 000. В то время как фонды ETF для Bitcoin фиксировали отток средств, фонды для Ethereum, напротив, привлекали новые инвестиции.

marsbit1 ч. назад

CPI спровоцировал ожидания повышения ставок! Крипторынок убивает и быков, и медведей, ликвидировано почти 100 тысяч позиций

marsbit1 ч. назад

Google и Meta поймали за накруткой рейтингов

Аналитическая компания SemiAnalysis обвинила Google и Meta в манипулировании результатами тестирования AI-моделей. В частности, модели Gemini 3.8 Flash от Google и Muse Spark 1.3 от Meta показали резкое падение результатов при переходе с версии 2.1 бенчмарка Terminal-Bench (оценивающего способности AI-агентов выполнять задачи) на более новую и защищённую от натаскивания версию 4.0. Например, оценка Gemini упала с 89.4 до 19.1 балла. По мнению аналитиков, причина в том, что компании используют для обучения не сами публичные тестовые задания, а покупают специально созданные «симуляционные» данные, максимально близкие к ним, что даёт аналогичный эффекту «зазубривания». Это стало целой индустрией, где задачи для тренировки продаются за сотни тысяч долларов. В качестве примера конфликта интересов указана компания Datacurve, которая одновременно владеет бенчмарком DeepSWE, продаёт тренировочные данные для него и проводит тестирование. Её модель Muse Spark занимает там первое место. SemiAnalysis предупреждает, что судьба любого качественного публичного бенчмарка — быть «разобранным на запчасти» лабораториями. Выходом они видят создание качественных приватных тестов, но это приведёт к исчезновению общедоступных объективных стандартов для сравнения моделей, что выгодно крупным игрокам, но усложняет оценку для сообщества разработчиков.

marsbit1 ч. назад

Google и Meta поймали за накруткой рейтингов

marsbit1 ч. назад

Новые крипто-золотоискатели в поисках физических активов: Безрассудное приключение сооснователя Coinbase на венесуэльских нефтяных месторождениях

Сооснователь Coinbase Фред Эрсам, накопивший состояние в криптоиндустрии, неожиданно инвестирует в традиционный сектор — нефтяные месторождения Венесуэлы. Через свою компанию Primavera Infinita он подписал контракт с государственной нефтяной компанией PDVSA на разработку блока Budare-Elotes, цель которого — увеличить добычу на более чем 70 тысяч баррелей в день. Это решение связано с изменением политического ландшафта: после ареста Мадуро и смягчения санкций США Венесуэла открывается для иностранных инвестиций. Эрсам, имеющий связи с администрацией Трампа, видит возможность высокой прибыли в условиях переоценки активов. Однако такие гиганты, как ExxonMobil, опасаются политических рисков и прошлого опыта национализации. Эрсам, не имеющий опыта в нефтяной отрасли, собирает профессиональную команду, следуя венчурной логике. Ключевой вызов — несоответствие между длительным циклом окупаемости проектов и нестабильной политической ситуацией. Его ставка — на продолжительность текущего «окна возможностей». Его инвестиции отражают broader trend: крипто-капитал всё чаще ищет убежище в реальных активах с физической дефицитностью, таких как энергоресурсы, металлы и сельхозугодья, как это видно на примерах BitMEX’s Артура Хейса и инвестиций Tether в агрохолдинг Adecoagro. Это показывает эволюцию от стремления токенизировать реальные активы к их прямому приобретению и контролю.

marsbit2 ч. назад

Новые крипто-золотоискатели в поисках физических активов: Безрассудное приключение сооснователя Coinbase на венесуэльских нефтяных месторождениях

marsbit2 ч. назад

Опровержение тезиса об «отказе» Ethereum от ETH: Что на самом деле означает возможность оплачивать Gas без ETH?

Если вы взаимодействуете с блокчейном, вы наверняка сталкивались с ситуацией, когда на новом кошельке есть стейблкоины, но для перевода не хватает ETH на оплату газа (комиссии сети). Это классическая проблема для новичков. Недавно Виталик Бутерин упомянул о прогрессе в работе над EIP-8141 (Frame Transactions, или "фрейм-транзакции"), что открывает новые возможности: в будущем можно будет совершать переводы, даже если в кошельке нет ETH. Газ можно будет оплачивать напрямую из USDC, а некоторые приложения для привлечения пользователей могут и вовсе взять комиссию на себя. Это вызвало радикальные заявления: "Если для Ethereum больше не нужен ETH, то в чём его ценность?" Однако ответ не так прост. То, чем пользователь платит за услугу, и то, чем протокол в итоге рассчитывается за работу сети — две разные вещи. **Что значит "не использовать ETH для оплаты газа"?** Сейчас в обычной транзакции Ethereum отправитель, подписывающий операцию, и плательщик за газ — одно лицо. EIP-8141 разделяет эти функции. Транзакция может быть разбита на "фреймы": один подтверждает операцию, другой определяет, кто заплатит за газ, третий выполняет перевод. Таким образом, пользователь (Фрэнк) может подписать перевод 100 USDC, а сторонний Paymaster (или спонсор) оплатит газ в ETH от своего имени. Затем Фрэнк компенсирует Paymaster, например, 0.1 USDC. Для Фрэнка весь процесс выглядит как оплата в USDC, ему не нужно знать текущую цену газа в ETH или держать ETH на балансе. **Почему Ethereum "прячет" газ?** Ключевая цель — решить давнюю проблему: зачем обычному пользователю разбираться в тонкостях газа? В реальном мире, переводя деньги через приложение, вас не просят купить специальную "расчётную монету". В крипто же каждая сеть требует свой нативный токен для комиссий, что создаёт барьер для новичков. Кроме того, фрейм-транзакции могут объединять несколько действий (например, одобрение и своп) в одну атомарную операцию. Если своп не удастся, одобрение автоматически откатится, повышая безопасность. **Так это плюс или минус для ETH?** EIP-8141 **не отменяет** роль ETH как основного актива для оплаты комиссий в сети Ethereum. Пользователь может не чувствовать его присутствия, но Paymaster, приложения или другие сервисы, оплачивающие газ за него, по-прежнему должны будут использовать ETH в рамках действующего механизма рынка комиссий (EIP-1559). Меняется лишь точка сосредоточения спроса на ETH. Сегодня миллионы пользователей держат немного ETH для газа. В будущем меньшее число крупных сервисов (Paymaster, кошельки) будут держать большие балансы ETH для обслуживания миллионов пользователей, которые платят, например, стейблкоинами. Не стоит ожидать, что каждая оплата в USDC мгновенно создаст покупательский спрос на ETH на бирже. У сервисов будут свои стратегии управления ликвидностью и хеджирования. **Ключевой вопрос** в другом: упростит ли это улучшение пользовательского опыта привлечение большего числа людей и увеличение реальной активности в сети Ethereum? Если раньше 100 потенциальных пользователей отсеивались из-за сложностей с газом, а теперь 80 из них остаются и совершают транзакции, то общий объём сожжённого в сети ETH (через механизм сжигания базовой комиссии) может вырасти, даже если у этих пользователей лично ETH не будет. Таким образом, EIP-8141 снижает барьер "каждый должен купить ETH, чтобы начать", но **ставит на то, что исчезновение этого барьера приведёт к массовому росту использования сети Ethereum**. Хороший кошелёк будущего должен скрывать сложные детали протокола (что такое газ, какой токен использовать) от пользователя, оставляя ему только решение о действии с его активами.

marsbit2 ч. назад

Опровержение тезиса об «отказе» Ethereum от ETH: Что на самом деле означает возможность оплачивать Gas без ETH?

marsbit2 ч. назад

Торговля

Спот
活动图片