# Bài viết Liên quan Mô Hình Thế Giới

Trung tâm Tin tức HTX cung cấp những bài viết mới nhất và phân tích chuyên sâu về "Mô Hình Thế Giới", bao gồm xu hướng thị trường, cập nhật dự án, phát triển công nghệ và chính sách quản lý trong ngành tiền kỹ thuật số.

Định giá 4 tỷ trong 3 tháng, người đoạt giải đặc biệt Thanh Hoa khởi nghiệp mô hình thế giới, Ant và Meituan cùng đầu tư

Ngô Hải Húc, người từng đạt học bổng đặc biệt của Đại học Thanh Hoa năm 2022, đã âm thầm khởi nghiệp trong lĩnh vực mô hình thế giới (world model). Công ty của anh tên là Vật Nguyên Khoa Kỹ, đã gọi vốn thành công ba vòng với định giá 600 triệu USD, thu hút các nhà đầu tư hàng đầu như Ant Group, Meituan, Daochen Capital và Xinglian. Trước đó, vào tháng 2 năm nay, công trình GeoPT do anh là tác giả chính đã gây chú ý trong giới công nghệ. Công trình đề xuất phương thức tiền huấn luyện động lực học mới, thông qua động lực học tổng hợp để nâng hình học tĩnh lên không gian động, giúp mô hình học trực giác vật lý từ quỹ đạo hạt trên dữ liệu không nhãn. Các đồng tác giả gồm phó giáo sư Long Minh Thịnh (giáo viên hướng dẫn tiến sĩ của anh) tại Đại học Thanh Hoa, Hà Khải Minh tại MIT và giáo sư Wojciech Matusik. Được biết, hướng khởi nghiệp của anh tập trung vào mô hình thế giới có khả năng mô hình hóa vật lý, kế thừa phần nào hướng nghiên cứu của GeoPT. Ngô Hải Húc nhập học ngành kỹ thuật phần mềm tại Đại học Thanh Hoa năm 2016, học thêm bằng thứ hai về toán học thuần túy và ứng dụng từ năm sau đó. Năm 2019, anh là sinh viên thỉnh giảng tại Nhóm Điện toán Hình ảnh của Đại học Harvard dưới sự hướng dẫn của giáo sư Hanspeter Pfister. Sau đại học, anh theo học tại Khoa Phần mềm Đại học Thanh Hoa dưới sự hướng dẫn của phó giáo sư Long Minh Thịnh. Năm 2022, anh nhận học bổng đặc biệt của Đại học Thanh Hoa, giải thưởng từng được trao cho Dương Thực Lân của Moonshot AI, Trần Lập Kiệt của OpenAI, Diêu Thuận Vũ của Google và Tào Việt của Sand.ai. Tại buổi bảo vệ học bổng, anh đã công bố bảy bài báo tại các hội nghị và tạp chí CCF-A như ICML, NeurIPS, IEEE TPAMI, trong đó sáu bài là tác giả chính hoặc đồng tác giả chính. Thành tựu cốt lõi của anh là Autoformer, công trình đầu tiên kết hợp sâu sắc tư tưởng phân rã chuỗi với cơ chế chú ý cải tiến, được coi là mô hình cột mốc cho dự báo chuỗi thời gian dài. Sau đó anh công bố thêm PredRNN, Corrformer, Neural-Solver-Library và FlashBias. Từ năm 2025, anh làm nghiên cứu sau tiến sĩ tại MIT CSAIL, nơi GeoPT là công trình tiêu biểu. Giáo viên hướng dẫn sau tiến sĩ Wojciech Matusik là học giả nổi tiếng trong lĩnh vực thiết kế tính toán và sản xuất tính toán. Trang cá nhân của anh ghi rõ trọng tâm nghiên cứu là học sâu và học máy khoa học, nhằm xây dựng nguyên tắc có thể mở rộng cho hệ thống vật lý. Nghiên cứu tập trung vào hệ thống vật lý và hệ động lực, chia thành ba hướng: mạng xương sống mở rộng dựa trên nguyên lý vật lý (Autoformer, Corrformer, Transolver); mô hình nền tảng vật lý đầu cuối (TimesNet, Unisolver, GeoPT); hệ thống học khoa học nhận biết lĩnh vực (Flowformer, Transolver++, FlashBias). Hiện tại, số trích dẫn Google Scholar của anh đạt 29.611.

marsbit3 giờ trước
Định giá 4 tỷ trong 3 tháng, người đoạt giải đặc biệt Thanh Hoa khởi nghiệp mô hình thế giới, Ant và Meituan cùng đầu tư

marsbit3 giờ trước

Ai đang rót vốn cho World Model? Ngoài Hillhouse và Sequoia, công ty robot này cũng có chỗ ngồi chính

Thị trường mô hình thế giới đang thu hút vốn đầu tư mạnh mẽ, với thời gian từ khi thành lập đến khi nhận vòng đầu tiên chỉ khoảng 2 tháng. Phân tích 79 công ty khởi nghiệp từ 2024-2026, bài viết chỉ ra nguồn vốn chủ yếu đến từ các quỹ VC hàng đầu. 10 tổ chức đầu tư nhiều nhất dẫn đầu là Gaoling Capital, Sequoia China và Inno Fund. Đáng chú ý, công ty robot Zhìyuán Robotics lọt vào top 5, vượt mặt nhiều VC chuyên AI để đầu tư vào 6 công ty khởi nghiệp mô hình thế giới, cho thấy sự liên kết sớm giữa bên sở hữu công nghệ và bên ứng dụng. Các tín hiệu chính: 1) Gần 2/3 số công ty nhận vốn đầu tiên từ VC hàng đầu; 2) Vốn công nghiệp, đặc biệt từ các công ty robot, đang tích cực xây dựng hệ sinh thái; 3) Chỉ có 38 quỹ đầu tư nhiều hơn một lần, phần lớn chỉ tham gia một lần; 4) Số nhà đầu tư tham gia mỗi vòng tăng theo từng năm (2.1 năm 2024 lên 3.3 năm 2026), phản ánh sự cạnh tranh khốc liệt và cửa sổ cơ hội thu hẹp. Bản đồ lực lượng đầu tư đang định hình rõ ràng. Việc lựa chọn nhà đầu tư vòng đầu không ngẫu nhiên mà sẽ ảnh hưởng sâu sắc đến định giá và nguồn lực tương lai của công ty khởi nghiệp.

marsbit5 giờ trước

Ai đang rót vốn cho World Model? Ngoài Hillhouse và Sequoia, công ty robot này cũng có chỗ ngồi chính

marsbit5 giờ trước

H-JEPA, LeCun "giao bài" khởi nghiệp mô hình thế giới, công khai toàn bộ mã nguồn và trọng số

Công ty khởi nghiệp AMI của Yann LeCun đã công bố H-JEPA, một mô hình thế giới phân cấp dành cho việc lập kế hoạch trong tầm nhìn máy tính. Mô hình này xếp chồng nhiều mô-đun JEPA (Joint-Embedding Predictive Architecture), mỗi tầng dự đoán trạng thái tương lai trong không gian biểu diễn riêng ở các khung thời gian khác nhau. Trong quá trình lập kế hoạch, tầng cao đưa ra kế hoạch tổng thể, sau đó chuyển các trạng thái trung gian dự đoán thành mục tiêu phụ cho tầng thấp hơn để tinh chỉnh thành hành động cụ thể. Trong nhiệm vụ mê cung Visual AntMaze, H-JEPA 3 tầng đạt tỷ lệ thành công 73%, vượt xa mô hình 1 tầng (18%). Nghiên cứu cũng nhấn mạnh tầm quan trọng của việc lập kế hoạch phân cấp để xử lý các mục tiêu dài hạn và hành động tức thời. Đáng chú ý, AMI đã công khai mã nguồn và trọng số mô hình đã huấn luyện. Công trình này thể hiện rõ lập trường của LeCun rằng hướng tiếp cận dựa trên mô hình thế giới và dự đoán trong không gian biểu diễn là chìa khóa để tiến tới trí tuệ cấp độ con người, chứ không phải chỉ dựa vào các mô hình ngôn ngữ lớn (LLM).

marsbit10/10 08:37

H-JEPA, LeCun "giao bài" khởi nghiệp mô hình thế giới, công khai toàn bộ mã nguồn và trọng số

marsbit10/10 08:37

Jev vs Decitron: Đều là AI Quyết định, Tại sao không giống nhau?

Thời gian gần đây, một mô hình AI mới tên là Jev từ TypeSafe AI đã thu hút sự chú ý với khẩu hiệu "Decisions, not strings" (Quyết định, không phải văn bản). Trong khi đó, tại Trung Quốc, công ty Zhongke Wenge đã ra mắt mô hình quyết định tổng quát Decitron từ tháng 6. Cả hai đều được gọi là "AI ra quyết định" nhưng thực chất có cách tiếp cận khác biệt cơ bản. Jev tập trung vào việc đưa ra quyết định tức thì dưới dạng lựa chọn (Choice), điểm số (Score) hoặc xác suất (Probability) để phần mềm có thể tích hợp và hành động ngay lập tức. Nó giống như nâng cấp câu lệnh if/else truyền thống thành phiên bản AI, nhắm đến các tác vụ cần phản hồi nhanh, rẻ và ổn định. Ngược lại, Decitron tiếp cận "ra quyết định" như một quá trình mô phỏng và suy luận về tương lai. Nó xây dựng mô hình thế giới, đưa vào nhiều tác nhân (đa tác tử) và sử dụng lý thuyết trò chơi để mô phỏng cách các lựa chọn khác nhau sẽ định hình kết quả theo thời gian. Decitron nhắm đến các quyết định chiến lược phức tạp, nơi một hành động có thể kích hoạt phản ứng dây chuyền từ các bên liên quan. Mặc dù khác biệt, cả Jev và Decitron đều đại diện cho một xu hướng chung: chuyển trọng tâm của AI từ "tạo sinh" (Generation) nội dung văn bản sang "hỗ trợ ra quyết định" (Decision). Chúng đều cố gắng lượng hóa sự không chắc chắn - Jev thể hiện qua độ tin cậy của lựa chọn hiện tại, còn Decitron thể hiện qua các kịch bản tương lai khả dĩ. Điều này báo hiệu cuộc cạnh tranh tiếp theo trong ngành AI có thể không chỉ nằm ở khả năng "nói" mà còn ở khả năng "lựa chọn" thông minh trong một thế giới luôn biến động.

marsbit09/23 10:13

Jev vs Decitron: Đều là AI Quyết định, Tại sao không giống nhau?

marsbit09/23 10:13

Thiếu nữ thiên tài người Hoa thuộc thế hệ 00, học trò của Bengio, chuyển từ DeepMind sang OpenAI

Vào ngày 16/9, nhà nghiên cứu cốt cán Bonnie Li của Google DeepMind, người đóng vai trò quan trọng trong việc phát triển Gemini 2.5/3, mô hình thế giới Genie 2/3 và tác nhân thể hiện Sima 2, đã thông báo chuyển sang làm việc cho OpenAI. Cô được mệnh danh là "thiếu nữ thiên tài 00", từng học dưới sự hướng dẫn của Yoshua Bengio và có chỉ số trích dẫn học thuật ấn tượng. Sự di chuyển của Bonnie Li phản ánh làn sóng chảy máu chất xám tại DeepMind. Trong năm 2026, một loạt nhân tài then chốt như David Silver, Noam Shazeer và Jeff Dean đã rời đi, chủ yếu chuyển đến Anthropic, Meta và OpenAI. Tỷ lệ giữ chân nhân tài của DeepMind so với các đối thủ đã giảm mạnh từ 12:1 xuống còn 2:1. Nguyên nhân được cho là do các động lực tài chính từ các công ty khởi nghiệp sắp IPO và áp lực thương mại hóa ngày càng lớn bên trong Google, làm giảm không gian cho nghiên cứu cơ bản dài hạn. Việc Bonnie Li gia nhập OpenAI giúp lấp đầy khoảng trống chiến lược của công ty này trong lĩnh vực mô hình thế giới và trí tuệ thể hiện, vốn là thế mạnh của Genie và Sima từ DeepMind. Cô đã bày tỏ trên X về việc "lần đầu tiên cảm nhận được AGI" sau khi OpenAI công bố GPT-6 Astra, một hệ thống được cho là đã chạm ngưỡng "nghiêm trọng" trong khung đánh giá an toàn nội bộ. Bối cảnh của sự kiện này là tốc độ phát triển AI đang tăng tốc và những rủi ro tiềm ẩn ngày càng rõ rệt, với các vụ việc như mô hình AI tự động tấn công mạng. Sự dịch chuyển của các chuyên gia hàng đầu như Bonnie Li không chỉ là thay đổi nơi làm việc, mà còn là một sự đặt cược vào nơi có thể chứng kiến và định hình tương lai của AGI sớm nhất.

marsbit09/23 04:53

Thiếu nữ thiên tài người Hoa thuộc thế hệ 00, học trò của Bengio, chuyển từ DeepMind sang OpenAI

marsbit09/23 04:53

Hàn 'Chuỗi Tư duy Nhân quả' vào Mô hình Thế giới, Điều gì giúp nó đạt Đỉnh cao?

Aether AI đã chính thức ra mắt CausalWM (16B tham số), mô hình thế giới nhân quả đầu tiên tích hợp "Chuỗi tư duy nhân quả" (Causal Chain-of-Thought). Khác với các mô hình dự đoán tương lai trực tiếp từ hình ảnh hiện tại, CausalWM buộc mô hình suy luận từng bước: đầu tiên dự đoán chuyển động vật lý (thông qua Optical Flow), sau đó suy ra sự thay đổi quan hệ hình học không gian 3D (thông qua Depth, Pointmap), và cuối cùng mới tạo ra hình ảnh tương lai dựa trên các kết quả trung gian này. Mỗi bước không chỉ là mục tiêu dự đoán mà còn là điều kiện đầu vào cho bước tiếp theo, tạo thành một quy trình suy luận có thứ tự nguyên nhân-kết quả. Phương pháp này giúp mô hình hiểu rõ hơn quá trình vật lý đằng sau sự thay đổi của thế giới, thay vì chỉ đoán mò dựa trên tương quan trong dữ liệu huấn luyện. CausalWM đã đạt vị trí số 1 trên bảng xếp hạng TriWorldBench - bộ tiêu chuẩn đánh giá khả năng dự đoán của mô hình thế giới cho nhiệm vụ robot, đặc biệt nhấn mạnh tính nhất quán giữa ba góc máy (đầu, cổ tay trái, cổ tay phải). Kết quả này cho thấy việc mô hình hóa rõ ràng các biến trung gian như chuyển động và hình học có thể nâng cao khả năng dự đoán ổn định và hiểu biết vật lý của mô hình. Hơn nữa, Chuỗi tư duy nhân quả còn mở ra khả năng điều khiển (intervention). Bằng cách đưa các tín hiệu hình ảnh mô tả hành động mong muốn (như quỹ đạo cánh tay robot) vào ngữ cảnh, mô hình có thể tạo ra video tương lai phù hợp với can thiệp đó. Điều này đánh dấu bước tiến từ việc chỉ quan sát "điều gì sẽ xảy ra" sang khám phá "nếu thay đổi A, thì B sẽ thế nào". Nghiên cứu này là một bước quan trọng trong lộ trình hướng tới "Trí tuệ Nhân quả" (Causal Intelligence) của Aether AI, nhằm giúp AI không chỉ nhận biết tương quan mà còn hiểu, suy luận và tác động lên thế giới thông qua các mối quan hệ nhân quả.

marsbit09/20 08:51

Hàn 'Chuỗi Tư duy Nhân quả' vào Mô hình Thế giới, Điều gì giúp nó đạt Đỉnh cao?

marsbit09/20 08:51

AI còn cách 'hiểu vạn vật' bao xa? Thử ngay với tế bào ung thư và quỹ đạo hành tinh

Bài viết thảo luận về một khuôn khổ AI mới mang tên **JEPA-Anything**, được phát triển bởi PhAI Labs cùng với các nhà nghiên cứu từ Oxford, Stanford, Princeton, và Đại học Trung văn Hồng Kông. Khuôn khổ này nhằm mục tiêu xây dựng một mô hình học tập dự đoán chung (**world model**) có thể áp dụng cho nhiều lĩnh vực khác nhau, từ sinh học phân tử đến vật lý thiên văn. Trọng tâm của nghiên cứu là cơ chế **OPF** (Orthogonal Predictive Factorization). Cơ chế này giải quyết vấn đề "phân bổ dung lượng dự đoán" bằng cách chia trạng thái mục tiêu thành các không gian con trực giao, mỗi không gian được xử lý bởi một nhánh dự đoán độc lập. Điều này giúp mô hình học đồng thời nhiều loại thay đổi (ví dụ: dao động vi mô và chuyển động vĩ mô) mà không bị xung đột hoặc che khuất thông tin. JEPA-Anything đã được kiểm nghiệm trên **bảy hệ thống** đa dạng: thị giác máy tính, sinh học, lâm sàng, điều khiển robot, phân tử, trường vật lý và thời tiết. Kết quả thí nghiệm cho thấy nó thường cải thiện độ chính xác dự đoán so với phương pháp JEPA tiêu chuẩn trên nhiều tác vụ, chẳng hạn như phương trình Burgers (-39.7% MSE) và dự báo thời tiết (-10.5%). Hơn nữa, nghiên cứu chứng minh rằng các yếu tố tiềm ẩn (**latent factors**) mà mô hình học được có thể trở thành **giao diện cho khám phá khoa học**: 1. **Trong nghiên cứu ung thư gan**, phân tích các yếu tố này dẫn đến một giả thuyết can thiệp kết hợp (IL-18 + chất ức chế CD73), sau đó được xác nhận hiệu quả qua thử nghiệm trên cơ quanoid và chuột. 2. **Trong cơ học thiên thể**, mô hình được cung cấp dữ liệu quỹ đạo hành tinh mô phỏng và tự học, không được cung cấp định luật Kepler. Khi phân tích các chế độ tiềm ẩn, các nhà nghiên cứu đã trích xuất được mối quan hệ giữa tần số quỹ đạo và bán trục lớn với độ chính xác rất cao (độ dốc -1.4991, gần với giá trị lý thuyết -1.5). Kết luận, JEPA-Anything đưa ra một khả năng: cùng một nguyên tắc dự đoán cơ bản có thể được áp dụng để học các quy luật thay đổi trong các thế giới khác nhau. Quan trọng hơn, cấu trúc bên trong mà mô hình học được không chỉ phục vụ dự đoán mà còn có thể được phân tích và kiểm chứng, mở ra hướng tiếp cận mới để AI hỗ trợ quá trình khám phá khoa học.

marsbit09/20 01:06

AI còn cách 'hiểu vạn vật' bao xa? Thử ngay với tế bào ung thư và quỹ đạo hành tinh

marsbit09/20 01:06

Sinh viên năm 2000 Đại học Chiết Giang, định giá sắp chạm 100 tỷ

Theo nguồn tin, Magic Core Technology do Chen Tianrun (sinh năm 2000, cựu sinh viên Đại học Chiết Giang) điều hành, sắp hoàn thành vòng gọi vốn mới với quy mô khoảng 1 tỷ nhân dân tệ, nâng định giá công ty lên gần 10 tỷ nhân dân tệ, tăng gấp đôi so với định giá 4 tỷ nhân dân tệ cách đây chưa đầy một tháng. Điều này phản ánh sự tin tưởng mạnh mẽ của các nhà đầu tư, bao gồm cả vốn nhà nước và tư bản ngành công nghiệp từ nhiều lĩnh vực như chip, thiết bị thông minh và sản xuất tiên tiến. Chen Tianrun thành lập Magic Core từ năm 2021, khởi đầu với phần cứng in 3D tiêu dùng trước khi chuyển hướng sang mô hình thế giới 4D và AI vật lý. Công ty đã tích lũy được lượng tài sản cảnh 3D phong phú và phát triển mô hình thế giới chung MoWorld-4D, có khả năng suy luận thời gian thực lên đến 50 khung hình/giây dựa trên nền tảng NPU nội địa, với chi phí chỉ bằng 30% so với giải pháp GPU nhập khẩu. Sự nhấn mạnh vào tốc độ khung hình cao và con đường tiết kiệm chi phí này nhằm mục đích đáp ứng nhu cầu thời gian thực trong các ứng dụng công nghiệp như sản xuất, robot và quy hoạch đô thị. Sự gia tăng định giá nhanh chóng của Magic Core diễn ra trong bối cảnh cạnh tranh toàn cầu ngày càng gay gắt trong lĩnh vực mô hình thế giới, nơi trọng tâm đang chuyển từ trình diễn công nghệ sang ứng dụng thực tế trong ngành. Các khoản đầu tư liên tục cho thấy niềm tin vào tiềm năng của công ty trong việc trở thành cơ sở hạ tầng trí tuệ không gian, định vị Trung Quốc như một lực lượng quan trọng trong cuộc đua AI vật lý toàn cầu.

marsbit09/18 04:02

Sinh viên năm 2000 Đại học Chiết Giang, định giá sắp chạm 100 tỷ

marsbit09/18 04:02

Mô hình Thế giới thực sự là gì? Lý Phi Phi, Chu Quân và những người khác giải thích như thế nào?

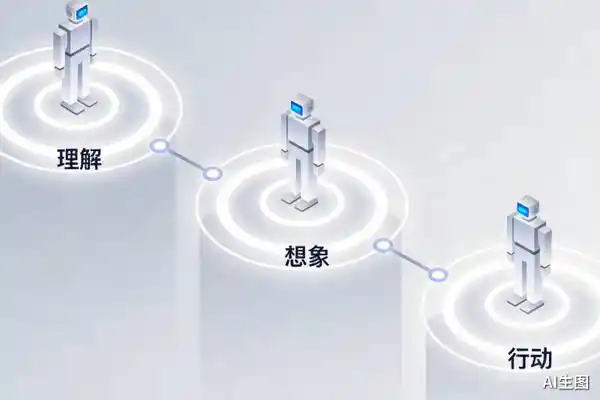
"World Model" hiện là một trong những thuật ngữ gây nhiều tranh cãi nhất trong giới AI năm 2026, với nhiều cách hiểu khác nhau, từ tạo video liên tục đến môi trường số tương tác thời gian thực. Sự thiếu đồng thuận này khiến việc đánh giá công nghệ trở nên khó khăn. Bài viết tổng hợp các quan điểm then chốt từ các chuyên gia hàng đầu. Nhóm của Lý Phi Phi (Fei-Fei Li) phân loại World Model thành ba chức năng: kết xuất hình ảnh (renderer), mô phỏng thế giới (simulator) và lập kế hoạch (planner). Trong khi đó, Yann LeCun nhấn mạnh việc học cấu trúc thế giới dự đoán được trong không gian tiềm ẩn (latent space). Giáo sư Châu Quân (Zhu Jun) từ Đại học Thanh Hoa đưa ra một khuôn khổ toàn diện hơn. Ông định nghĩa World Model phổ quát (General World Model - GWM) dựa trên ba năng lực cốt lõi tạo thành một vòng lặp khép kín: **Hiểu (Understanding)** - tích hợp thông tin để có nhận thức về thế giới hiện tại; **Tưởng tượng (Imagination)** - dự đoán các tương lai có thể xảy ra dựa trên hành động; và **Hành động (Action)** - can thiệp vào môi trường và sử dụng phản hồi để cải thiện mô hình. Dựa trên đó, nhóm của ông đề xuất một lộ trình phát triển 5 cấp độ (L1 đến L5) cho GWM: * **L1 - Tạo ra thế giới:** Tạo video liên tục, mạch lạc. * **L2 - Tương tác với thế giới:** Thế giới số phản ứng liên tục với đầu vào của người dùng. * **L3 - Hành động trong thế giới:** Ra quyết định và thực hiện hành động vật lý (ví dụ: điều khiển robot), sau đó học từ kết quả thực tế. * **L4 - Tác nhân thông minh tự chủ:** Chủ động đặt mục tiêu, khám phá và học hỏi liên tục. * **L5 - Tổ chức thế giới:** Điều phối sự hợp tác của nhiều tác nhân trong môi trường mở. Bài viết chỉ ra rằng các hệ thống hiện tại (như Vidu, Motus) chủ yếu đạt đến cấp độ L1-L3. Để tiến tới L4-L5, cần giải quyết các thách thức như tích hợp vật lý và nhân quả, học trực tuyến, triển khai hiệu quả và kiểm soát an toàn. Công ty Shengshu AI (Sinh Số) minh họa cho lộ trình này thông qua hai hướng phát triển song song: video số (Vidu) cung cấp kiến thức rộng về thế giới, trong khi robot (Motus/Motus2) đảm bảo khả năng hành động và học hỏi từ phản hồi vật lý. Kiến trúc MoT (Mixture-of-Transformers) được đề xuất để thống nhất việc xử lý đa phương thức (hình ảnh, ngôn ngữ, hành động) xoay quanh một trạng thái thế giới chung. Tóm lại, cuộc cạnh tranh về World Model đang chuyển từ việc tạo ra các demo ấn tượng sang khả năng của hệ thống trong việc hiểu, dự đoán, hành động và quan trọng nhất là **tự sửa chữa dựa trên phản hồi từ thế giới thực**. Đây được xem là một nền tảng quan trọng để tiến tới trí thông minh phổ quát (AGI).

marsbit09/11 03:09

Mô hình Thế giới thực sự là gì? Lý Phi Phi, Chu Quân và những người khác giải thích như thế nào?

marsbit09/11 03:09

Mới đây, mô hình thế giới có khả năng dự đoán tương tác đa tác tử đã xuất hiện

Vừa qua, Scalabot đã công bố mô hình thế giới đầu tiên của họ, **HERON-World Model**, một mô hình có khả năng dự đoán tương tác đa tác nhân. Chỉ cần cung cấp một khung hình hiện tại và hành động tiếp theo, mô hình có thể dự đoán trực quan kết quả sẽ xảy ra khi robot thực hiện hành động đó. Điểm nổi bật của HERON-World Model nằm ở ba khả năng chính: 1. **Hiểu quy luật vật lý**: Dự đoán chính xác các hiện tượng như vật thể rơi, va chạm và nảy lại. 2. **Ghi nhớ trạng thái và tính nhất quán**: Theo dõi và ghi nhớ trạng thái của các đối tượng (ví dụ: nắp đã đậy, nét vẽ đã tạo) để đảm bảo dự đoán tương lai phù hợp với các hành động và trạng thái trước đó. 3. **Dự đoán tương tác đa tác nhân**: Đây là điểm đột phá. Mô hình không chỉ dự đoán kết quả từ một robot đơn lẻ mà còn có thể mô hình hóa cách các hành động của nhiều tác nhân (ví dụ: hai người cùng kéo khăn hoặc bện dây) kết hợp và ảnh hưởng lẫn nhau, dẫn đến sự thay đổi chung của môi trường. Để đạt được khả năng này, nhóm nghiên cứu đã xây dựng một "kim tự tháp dữ liệu" cho việc huấn luyện tiền, kết hợp: - **Dữ liệu robot thực**: Cung cấp kinh nghiệm hành động-thay đổi thực tế từ nhiều loại robot. - **Dữ liệu mô phỏng**: Bổ sung các tình huống hiếm, nguy hiểm hoặc thất bại. - **Video thao tác của con người (Ego)**: Mở rộng phạm vi kinh nghiệm tương tác hàng ngày. Các hành động từ các nguồn dữ liệu khác nhau này được trích xuất, căn chỉnh về thời gian/không gian và mã hóa thống nhất thành "Action Token" để mô hình có thể học mối quan hệ chung giữa hành động và sự thay đổi của thế giới. Về kiến trúc, HERON-World Model sử dụng sự kết hợp **MoT (Mixture of Tokens) + MoE (Mixture of Experts)**: - **MoT**: Tách biệt kiến thức thế giới tổng quát từ Mô hình Ngôn ngữ Thị giác (VLM) với nhánh tạo video dự đoán, giúp bảo tồn kiến thức nền trong khi vẫn học dự đoán hành động mới. - **MoE**: Phân chia quá trình tạo video thành các chuyên gia xử lý nhiễu cao (cấu trúc tổng thể, chuyển động thô) và nhiễu thấp (chi tiết hình học, tương tác tinh vi), giúp xử lý hiệu quả sự phức tạp của nhiều loại hành động và tương tác đa tác nhân. Mô hình này hướng tới mục tiêu trở thành "bộ não" cho robot, cho phép chúng "diễn tập trước" hậu quả của hành động trong thế giới ảo trước khi thực thi ngoài đời thực, từ đó lập kế hoạch và hành động an toàn, hợp lý hơn trong các môi trường phức tạp như nhà máy hay gia đình.

marsbit09/08 11:39

Mới đây, mô hình thế giới có khả năng dự đoán tương tác đa tác tử đã xuất hiện

marsbit09/08 11:39

活动图片