Nama itu jelas-jelas ada di ujung lidah.
Anda melihat wajah yang familiar, tapi tidak bisa mengingat namanya. Psikologi memberi nama untuk fenomena ini: "tip-of-the-tongue phenomenon".
Sekarang, Google dalam sebuah penelitian menemukan bahwa GPT-5 dan Gemini 3 punya masalah yang sama.
Kedua model ini menyimpan 95%–98% fakta uji ke dalam parameternya. Tapi ketika ditanya langsung, mereka tidak bisa menjawab 26%–34% fakta tersebut.
Dengan mengaktifkan fitur 'thinking' untuk berpikir lebih lama, masih tersisa 11%–12% yang tetap tidak bisa diingat.
Banyak kasus model besar tidak bisa menjawab, bukan karena tidak punya informasi di 'otaknya', tapi karena sudah dipelajari namun tidak bisa diambil.
Penelitian ini berjudul "Empty Shelves or Lost Keys?", diterima di ICML 2026.
Tanggal 12 Agustus, Google Research memposting blog yang merangkum hasilnya, sekaligus merilis benchmark bernama WikiProfile dan dataset lengkapnya.
Rak Tidak Kosong, Kuncinya yang Hilang
Model yang menjawab salah, mungkin punya dua jenis masalah.
Pertama, memang belum pernah dipelajari sama sekali, sehingga perlu ditambah data dan parameter pada pra-pelatihan. Kedua, sudah dipelajari, tapi dengan pertanyaan yang diungkapkan berbeda, tidak bisa diambil. Itu urusan pasca-pelatihan dan inferensi.
Kedua masalah ini, sebelumnya sering disatukan sebagai masalah akurasi.
Kerangka kerja "knowledge profiling" yang diusulkan Google tidak lagi bertanya "apakah pertanyaan ini dijawab dengan benar", melainkan menilai "dalam kondisi apa fakta ini berada di memori model ini", dibagi menjadi lima status.
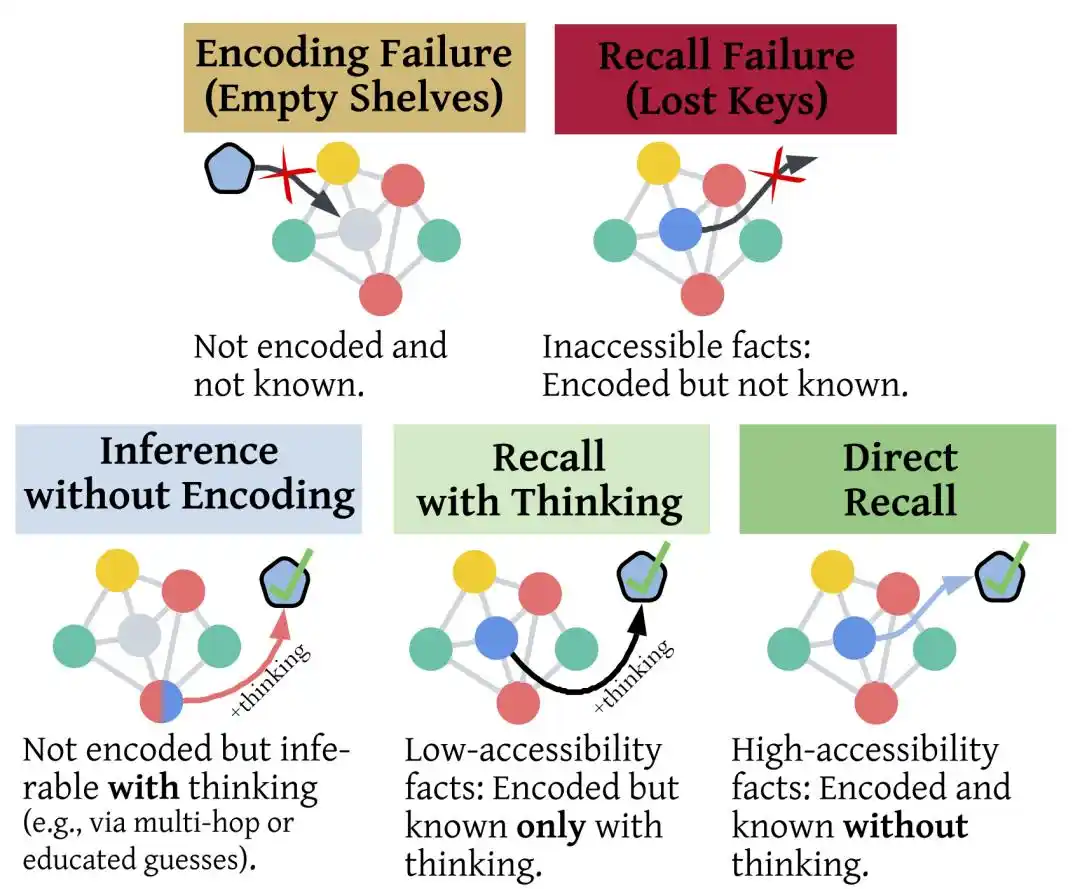
"Knowledge profiling" membagi sebuah fakta menjadi lima status: encoding failure (gagal menyimpan), recall failure (gagal mengingat), direct recall (ingat langsung), recall with thinking (ingat dengan thinking), unencoded but answered correctly via reasoning (tidak tersimpan tapi dijawab benar lewat penalaran).
Jawaban salah yang sama, dalam status yang berbeda, metode perbaikannya juga sangat berbeda.
Bagaimana menilai apakah sebuah fakta tersimpan atau tidak?
Caranya adalah memotong teks asli Wikipedia tepat sebelum jawaban muncul, lalu meminta model melanjutkan menulis; atau langsung bertanya setelah konteks yang sama.
Dua jenis pertanyaan ini tidak boleh menggunakan thinking, tujuannya untuk memisahkan antara "sudah diingat" dan "disediakan melalui penalaran".
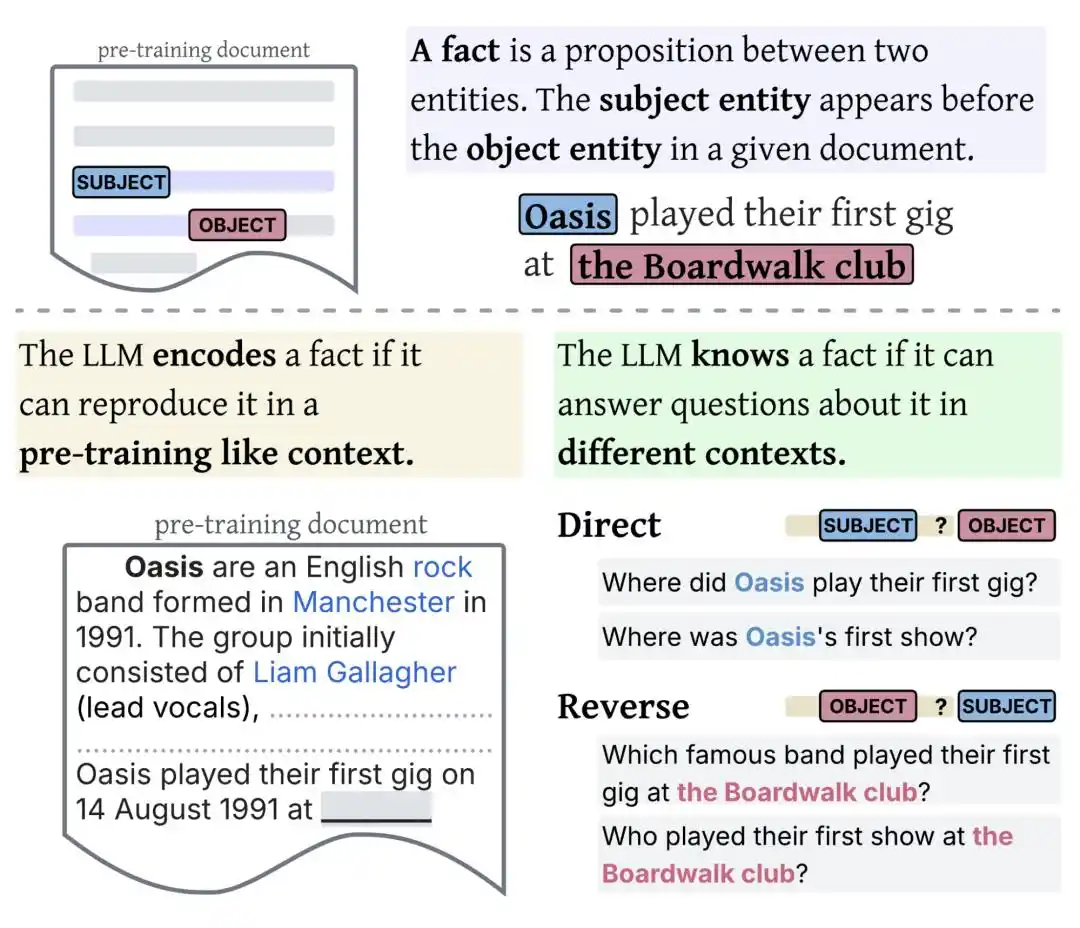
Sisi kiri menguji apakah tersimpan atau tidak, dengan memotong teks Wikipedia dan meminta model melanjutkan; sisi kanan menguji apakah bisa dijawab atau tidak, dengan mengubah susunan kata, arah positif/negatif, dan bertanya berulang kali.
Benchmark bernama WikiProfile, totalnya 2150 fakta, semuanya diambil dari Wikipedia bahasa Inggris.
Setiap fakta dilengkapi 10 soal: 2 soal untuk menguji apakah tersimpan, 4 soal untuk dijawab sendiri, 4 soal pilihan ganda. Totalnya 21500 soal.
Pembuatan soal diserahkan sepenuhnya ke model: dihasilkan oleh Gemini-2.5-Pro, setiap soal diverifikasi dengan Google Search, jika jawaban tidak tunggal atau soal ambigu, fakta beserta soalnya dibuang. Terakhir diperiksa ulang secara manual, kurang dari 2% dibuang.
Model yang diuji ada 13, mencakup keluarga Gemini 3, GPT-5, GPT-4.1 dan Gemma 3. Setiap model dijalankan dengan thinking aktif/nonaktif masing-masing satu kali, setiap soal di-sampling delapan kali, terkumpul sekitar 4,5 juta jawaban.
Menguji satu model mutakhir secara lengkap, kira-kira menghabiskan $500.
Hasilnya adalah angka-angka di awal tadi.
Dalam kesalahan fakta model mutakhir, "tidak bisa diambil" sudah mengalahkan "tidak dipelajari", menjadi penyumbang utama.
Yang Tidak Bisa Diambil, Terhambat di Dua Titik yang Sama
Pertama adalah pengetahuan langka.
Penjelasan utama sebelumnya adalah kapasitas model tidak cukup, beberapa fakta langka tidak dipelajari sama sekali.
Data kali ini menunjukkan, pengetahuan langka sebenarnya sudah tersimpan. Gemini-3-Pro menyimpan 94,5% fakta langka, fakta populer 99,5%, selisihnya hanya 5 poin.
Tapi begitu mulai menjawab, tingkat ingat fakta langka turun ke 63,3%, fakta populer masih 84,7%, selisihnya 21 poin.
Saat menyimpan hampir tidak berbeda, saat mengambil selisihnya menjadi empat kali lipat.
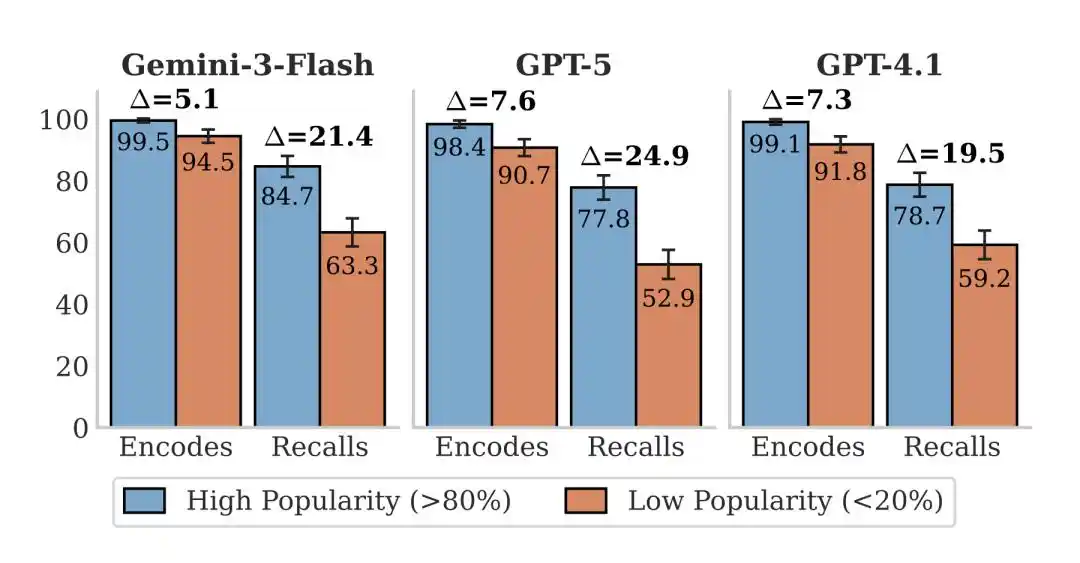
Perbandingan fakta langka (20% terakhir) dengan fakta populer (20% teratas), selisih tingkat penyimpanan kecil, selisih tingkat ingat langsung jelas melebar.
Penurunan GPT-5 lebih besar lagi.
Fakta langka disimpan 90,7%, fakta populer 98,4%. Tapi begitu menjawab, fakta langka hanya tersisa 52,9%, fakta populer masih 77,8%.
Hampir setengah fakta langka yang jelas-jelas ada di dalam model, tapi tidak bisa diambil.
Saat menyimpan perbedaannya kecil, saat mengambil perbedaannya besar. Kebenaran masalah long tail, bukan karena model belum pernah melihat fakta langka itu, tapi karena pengetahuan itu lebih sulit dibangunkan.
Skenario kedua adalah pertanyaan terbalik, Anda bertanya pada AI, siapa ibu Tom Cruise, dia menjawab cepat dan tepat. Anda bertanya terbalik, siapa putra wanita ini, dia malah bingung.
Makalah tahun 2023 memberi nama "reversal curse", model belajar "A adalah B", tidak otomatis menggeneralisasi "B adalah A". Penjelasan saat itu: hubungan dua arah sama sekali tidak dipelajari.
Google mengubah soal yang sama menjadi pilihan ganda empat opsi, hasilnya langsung terbalik.
Tingkat ingat GPT-5 untuk pertanyaan langsung adalah 82,9%, pertanyaan terbalik turun ke 74%. Tapi begitu diganti soal identifikasi pilihan ganda, soal terbalik tidak hanya tidak lebih sulit dari soal langsung, dari 13 model, 9 model justru menjawab lebih baik, 4 sisanya setara.
Soal pilihan ganda bisa dikerjakan, begitu diganti soal esai terbuka, tidak bisa dijawab.
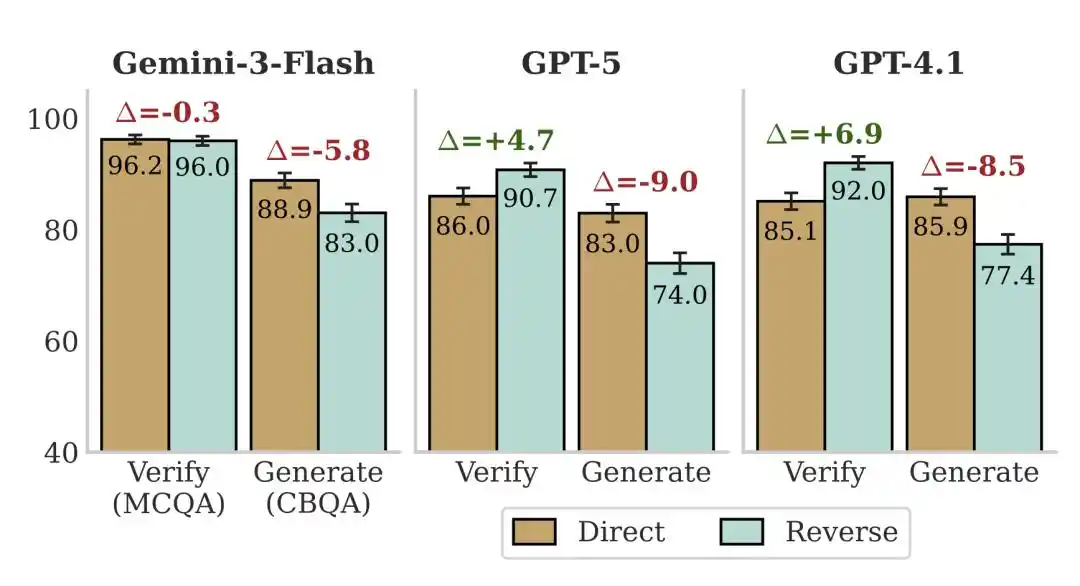
Soal langsung/terbalik yang sama, dalam identifikasi pilihan ganda, soal terbalik tidak lebih sulit dari soal langsung; dalam pembuatan esai tertutup, soal terbalik jelas lebih sulit.
Ini menunjukkan hubungan itu jelas ada, yang benar-benar terhambat adalah cara menggalinya.
Penjelasan penulis adalah, saat fakta disimpan, konteks, susunan kata, dan urutan saat itu juga ikut tersimpan di dalamnya.
Cara Anda bertanya begitu menyimpang dari bentuk pelatihan, kunci tidak cocok dengan kuncinya.
Identitas Lain Thinking, Membantunya Mengingat
Soal di WikiProfile, semuanya tanya-jawab langsung, tidak ada langkah penalaran di tengah.
"Di klub mana pertunjukan pertama Oasis?", soal seperti ini ingat atau tidak ingat.
Secara logika, membiarkan model berpikir lebih lama, tidak akan banyak membantu.
Tapi thinking benar-benar berhasil mengembalikan. Fakta-fakta yang sudah tersimpan tapi tidak bisa dijawab, dia berhasil menemukan kembali 40%–65%.
Petunjuk kuncinya, tersembunyi di preferensinya: fakta-fakta yang sama sekali tidak tersimpan, thinking hanya bisa mengembalikan 5%–15%.
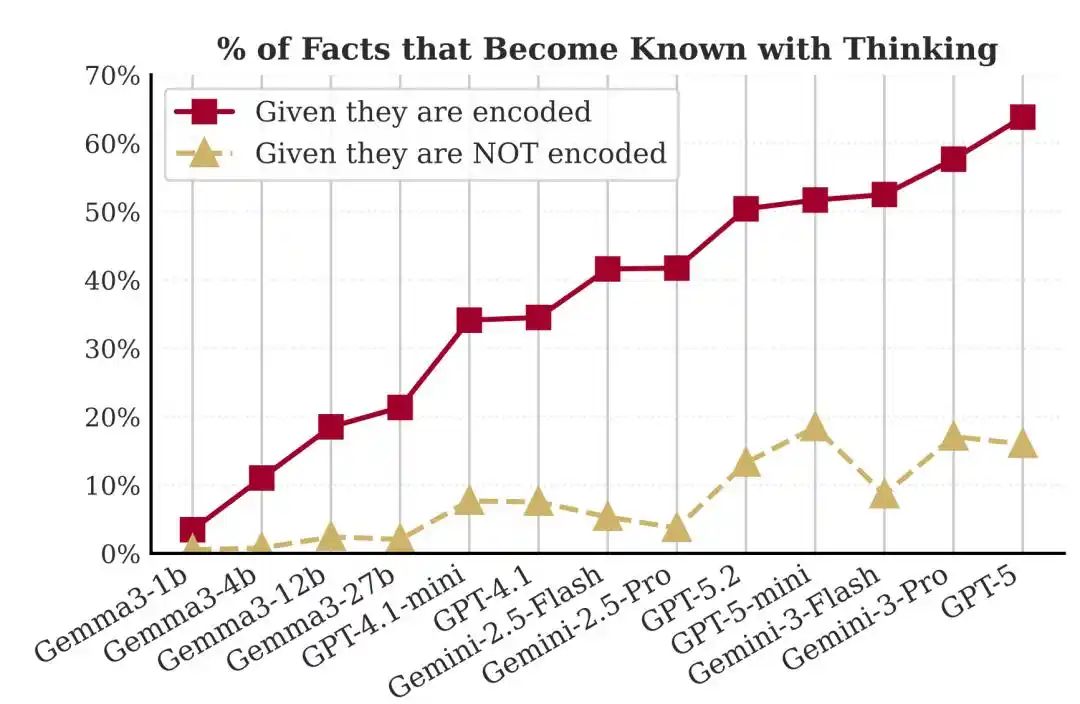
Proporsi fakta yang ditemukan kembali setelah mengaktifkan thinking, yang sudah tersimpan di parameter bisa dikembalikan 40%–65%, yang tidak tersimpan hanya 5%–15%.
Dia tidak sedang menyimpulkan dengan pengetahuan lain, dia sedang mencari kunci di tempat.
Penulis juga sekaligus mengesampingkan satu penjelasan yang lebih mudah.
Ada yang berpikir, thinking hanyalah membuat model menjawab lebih beragam, peluang menebak benar satu dari delapan kali menjadi lebih besar. Jika benar begitu, jawaban seharusnya lebih acak.
Kenyataannya malah terbalik, dengan thinking diaktifkan, untuk soal yang sama, jumlah jawaban benar dalam delapan kali justru lebih terkonsentrasi.
Dua area dengan keuntungan terbesar, kebetulan adalah dua area yang paling macet sebelumnya.
Selisih fakta langka/populer Gemini-3-Pro menyempit dari 21,4 poin menjadi 12,5 poin, selisih soal langsung/terbalik GPT-5 menyempit dari 9 poin menjadi 2 poin. Di mana paling macet, dia memberikan usaha di sana.
Makalah saudari Google lainnya "Thinking to Recall" memberikan penjelasan mekanismenya:
Pertama, buffer komputasi, token pemikiran yang dikeluarkan meskipun kontennya sendiri tidak terlalu berarti, juga memberi model kekuatan komputasi implisit tambahan;
Kedua, priming fakta, model menyebutkan sekumpulan fakta terkait terlebih dahulu, sama dengan membangun jembatan semantik untuk jawaban yang benar.
Dalam kognisi manusia ini disebut "spreading activation".
Tidak ingat nama seseorang, ingat dulu di perusahaan mana, gaya rambut apa, pertemuan terakhir di acara apa, namanya sering muncul sendiri.
Cara menghilangkan "tip-of-the-tongue phenomenon", manusia dan model ternyata sama.
Tapi cara ini juga ada harganya.
Makalah yang sama memperingatkan: jika fakta perantara dalam chain of thought itu dibuat-buat, probabilitas halusinasi jawaban akhir justru lebih tinggi.
Jembatan dibangun miring, semakin jauh melangkah semakin salah.
Perbesar Skala Sama dengan Tambah Stok, Tidak Bertugas Menyiapkan Kunci
Ambil keluarga Gemma 3 open-source sebagai pengukur.
Parameter naik dari 1B ke 27B, tingkat kegagalan encoding turun dari 85% menjadi 23%.
Skala memang menambah stok, rak terlihat terisi. Tapi recall failure tidak turun bersamaan. Proporsinya dalam kesalahan yang tersisa terus naik, hingga pada 27B menjadi penyusun utama kesalahan.
Diterapkan pada model mutakhir lebih ekstrem: recall failure menyumbang lebih dari 70% dari semua kesalahan GPT-5.2, dan semakin kuat model, semakin tinggi proporsi ini.
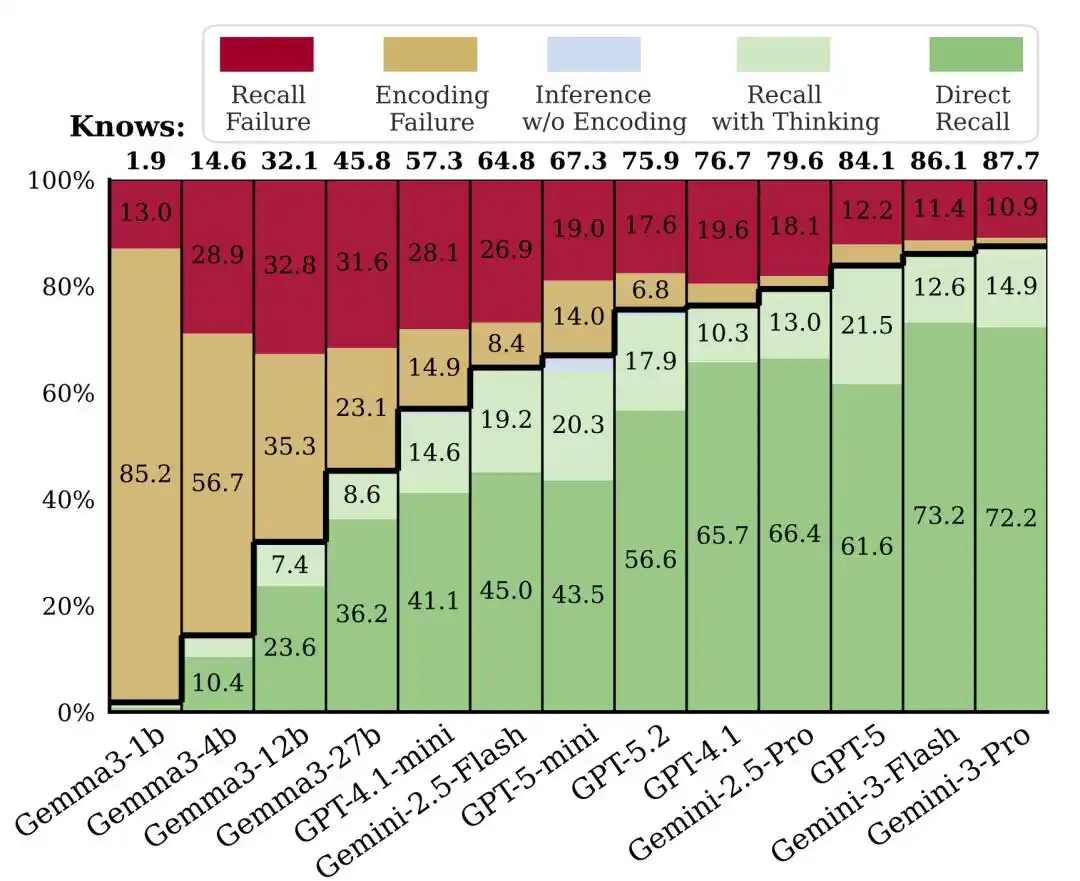
Distribusi lima status dari 13 model, parameter semakin besar encoding failure terus menyusut, recall failure hampir tidak bergerak.
Skala memperbaiki berapa banyak yang disimpan, bukan berapa banyak yang bisa diambil.
Ini tidak memberi vonis mati pada scaling, tapi memberi batasan padanya.
Karena proporsi yang tersimpan sudah mendekati plafon 95%–98%, maka terus menambah parameter dan data, peningkatan akurasi yang bisa didapat semakin kecil terlihat.
Keuntungan tahap berikutnya kemungkinan besar berasal dari metode pasca-pelatihan dan inferensi, yaitu bagaimana menggunakan pengetahuan yang sudah tersimpan dengan baik.
Retrieval augmented tentu bisa mengisi posisi.
Tapi penulis juga mengingatkan: pengetahuan dalam parameter masih berhubungan dengan kelancaran, kecepatan respons, dan integrasi lintas konteks, sulit digantikan sepenuhnya oleh pencarian eksternal.
Dia Harus Tahu Dulu Bahwa Dia Tidak Bisa Mengingat
Lalu, kapan model harus dibiarkan berpikir lebih lama?
Makalah mendefinisikan masalah ini sebagai meta-kognisi, yaitu penilaian model terhadap kondisinya sendiri: dia harus menyadari dulu "saya tidak bisa menjawab langsung", baru tahu soal ini layak diaktifkan thinking untuk berpikir lebih lama.
Dua tahun terakhir, jawaban default agar model lebih andal adalah memberi lebih banyak data, menumpuk parameter lebih besar.
Penelitian ini menjelaskannya: di tingkat fakta, stok model mutakhir sudah terpasang cukup banyak. Selanjutnya yang diuji, adalah kemampuannya mengambil stok itu sendiri.
Yang lebih merepotkan adalah langkah selanjutnya: dia harus tahu dulu, bahwa dia tidak bisa mengingat.
Referensi:
https://research.google/blog/empty-shelves-or-lost-keys-recall-is-the-bottleneck-for-parametric-factuality/
https://aihot.virxact.com/items/cmsqe6mat01bsroli3hw71nz7
Artikel ini berasal dari akun WeChat "Xin Zhi Yuan", penulis: ASI Qishilu