OpenAI,正亲手点燃整个数学界的怒火!
不久前,纽大数学家Tristan Buckmaster因「NS方程」的归属问题,与OpenAI爆发激烈冲突。
一篇声明甚至爆出,OpenAI电话施压数学家,强行抢夺成果。
没想到,这一波未平,一波又起。
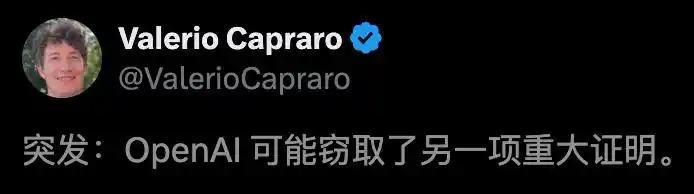
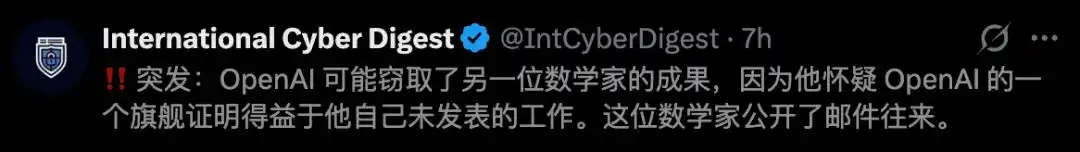
就在今天,群论领域的大佬、德累斯顿工业大学数学家Andreas Thom,在社交网络上晒出邮件「铁证」。
他指控OpenAI新一代Astra剽窃了,自己耗时20年的一个领域研究——非sofic群。
对此,OpenAI斩钉截铁地否认了。
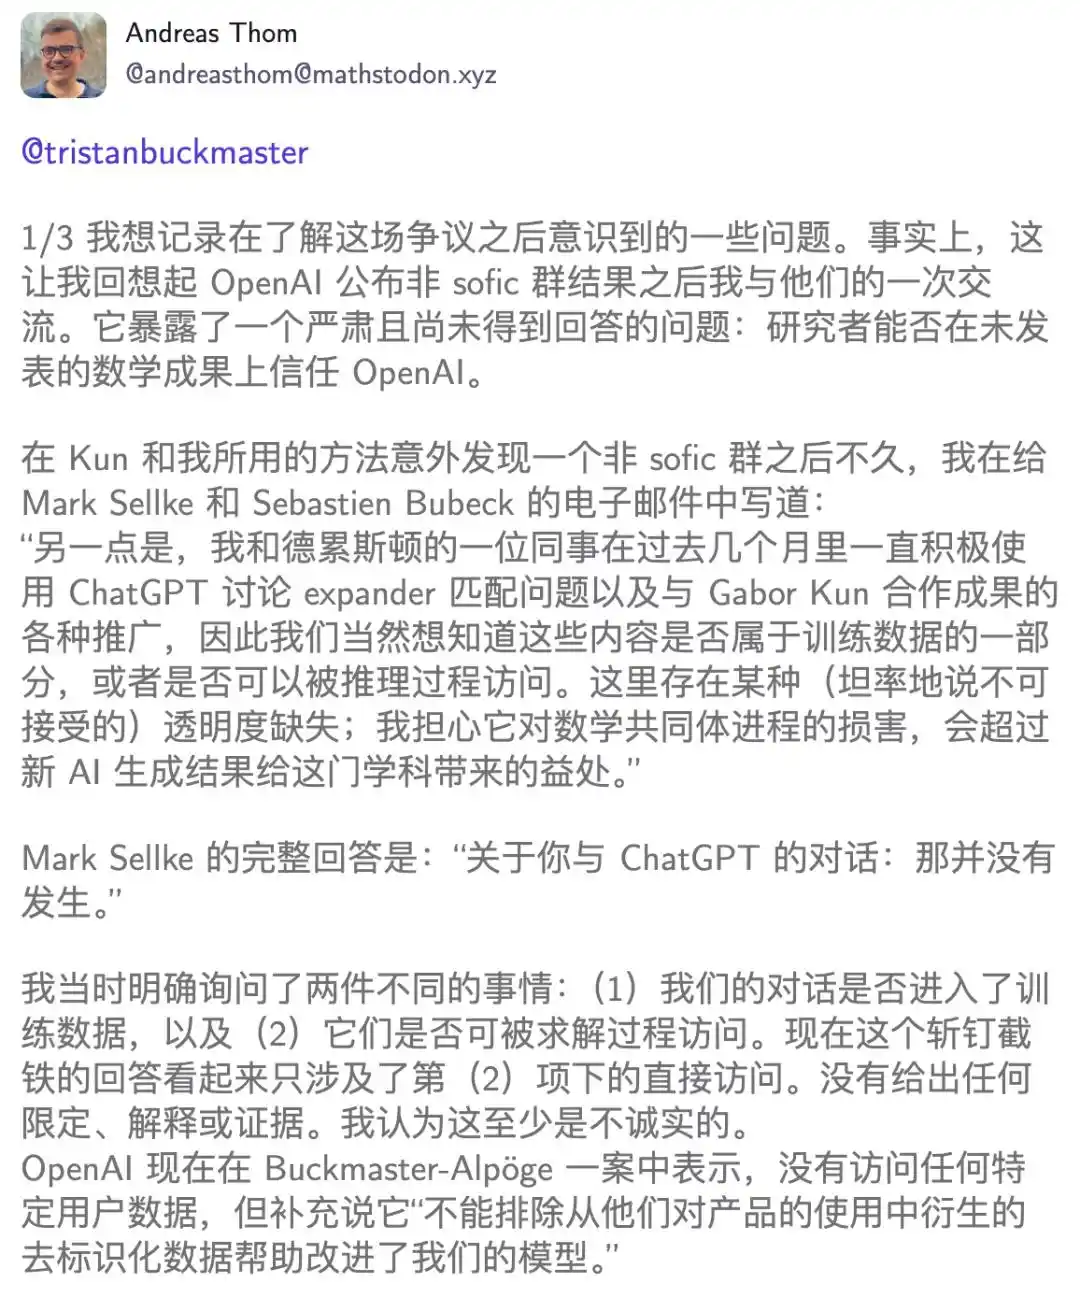
短短几个小时,这一消息直冲热榜。
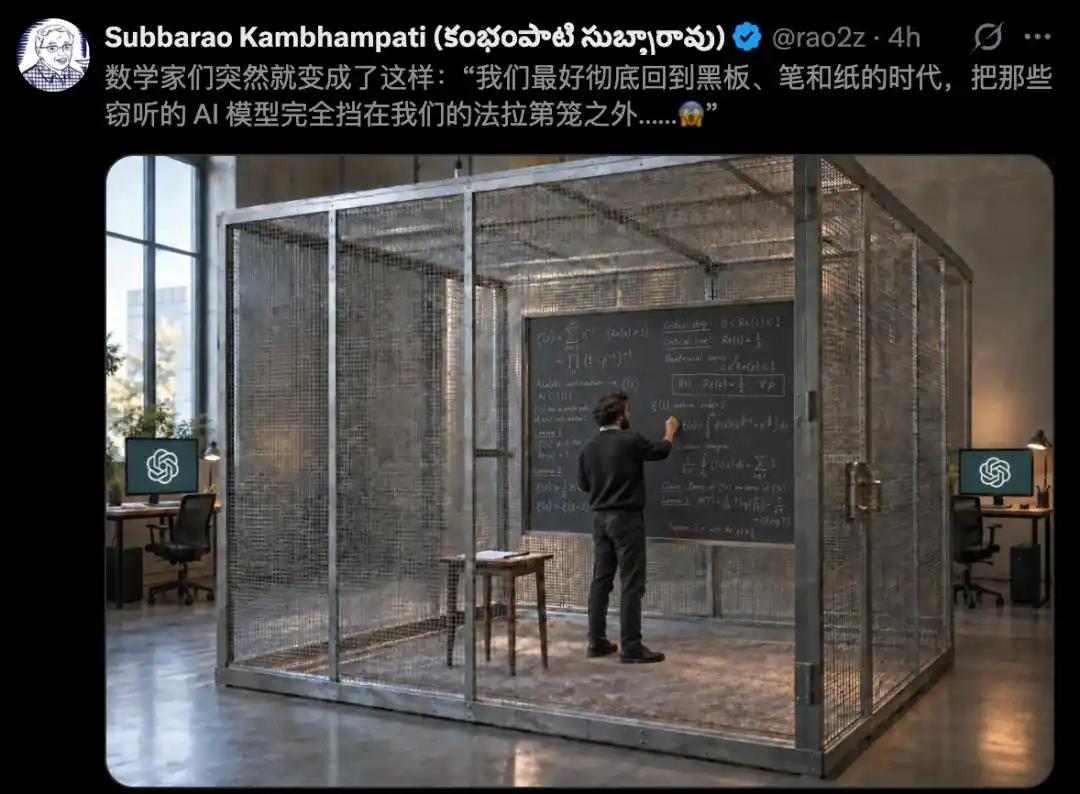
所有人再次惊掉下巴,有网友表示,数学家最好彻底回到黑板、笔和纸的时代。
百年猜想告破?
Astra窃走未发表成果
这件事的起因,还要追溯到8月初OpenAI的那次高调官宣——
十大「菲尔兹奖级」难题,全部被Astra成功攻克了。
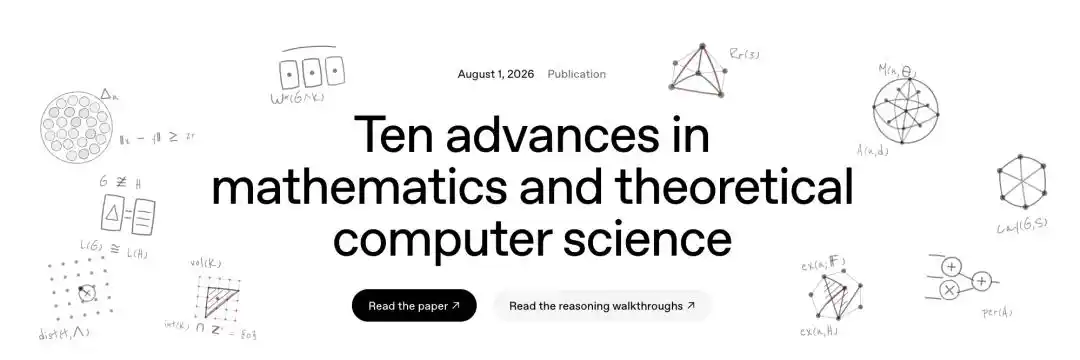
其中一个,就包括了困扰群论领域长达27年的「Gromov柔度猜想」(Gromov's soficity conjecture)。
Astra找到了非柔度群(non-sofic group)的存在证据。
消息一出,整个AI界都在欢呼,「AGI已经推开了纯数学发现的大门」。
然而,圈内的顶尖专家们,却越看越觉得诡异。
作为在该领域深耕了二十余年的泰斗级学者,Andreas Thom和他的长期合作者Gábor Kun敏锐地发现:
Astra证明过程中最核心、最精妙的关键推导步骤,与他们二人正在推进的技术路径高度吻合。
更蹊跷的是,用Thom自己的话来说——
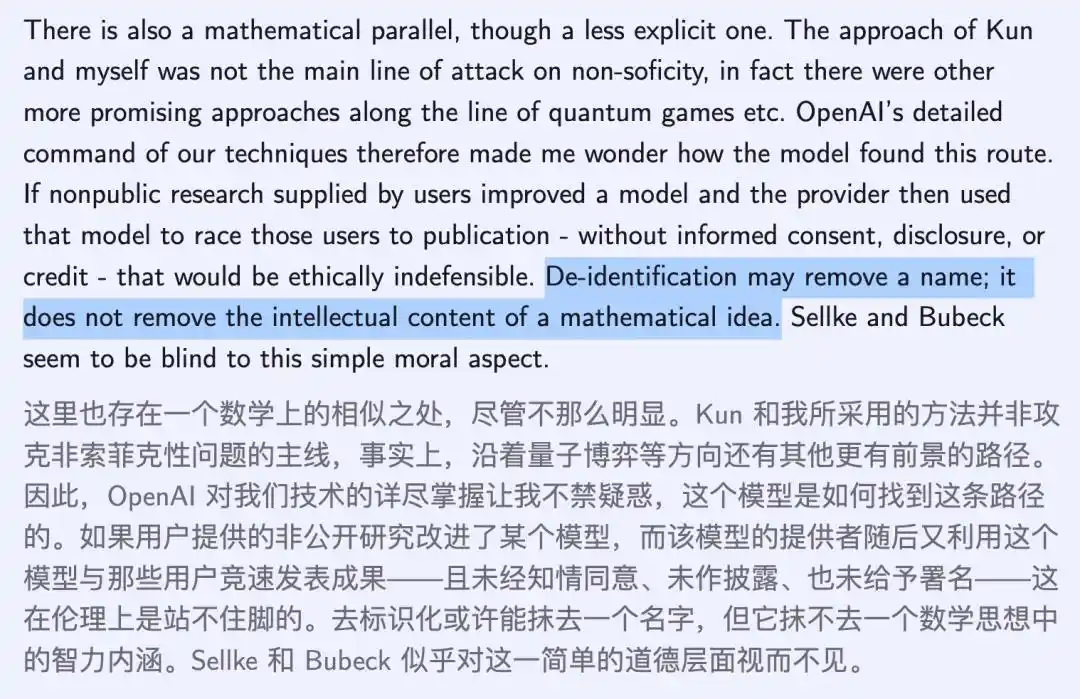
我和Kun的方法并不是攻克非柔度群的主流方向,学界当时更看好量子博弈等其他路径。
OpenAI的模型究竟是如何精准无误地锁定,并掌握我们这一套极其冷门且细致的技巧的?
谜底很快就揭晓了,真相简直让人不寒而栗。
在OpenAI正式发布成果前的数月里,Thom和同事,一直在高频使用ChatGPT探讨「扩展匹配问题」,并在对话框里敲下了,大量关于该猜想的未发表核心推导与最新证明细节!
二十年坐冷板凳的心血,几个月与AI的推演对话,转头就变成了OpenAI新模型震撼世界的「自主成果」。
换作任何一个人,都绝不可能咽下这口气。
OpenAI:从未发生过
察觉到异常之后,Andreas Thom没有选择立刻发难。
他保持了学者应有的克制,给OpenAI两位核心研究员Mark Sellke和Sébastien Bubeck发去了一封正式邮件。
在信中,Thom提出了两个极其精准、逻辑严密的质询:
1. 我们几个月来在ChatGPT中讨论未发表成果的对话记录,是否被纳入了模型的训练数据?
2. 在模型解题和推理的过程中,这些记录是否可以被直接检索和访问?
对此,研究员Mark Sellke回了一封极短的邮件,只有冷冰冰的一句话:
关于你与ChatGPT的对话:那没有发生过。
没有数据审计说明,没有隐私机制解释,甚至没有任何格式化的套话,就这么蛮横、傲慢且斩钉截铁地全盘否决。
Thom还披露了一个日期——6月29日,他关闭了模型训练选项。
然而,他认为,关闭开关只能面向此后,无法回答更早的对话经历了什么,也无法说明是否已有衍生数据被选入训练流程。
用户看得到一个设置,看不到后台的数据流向。
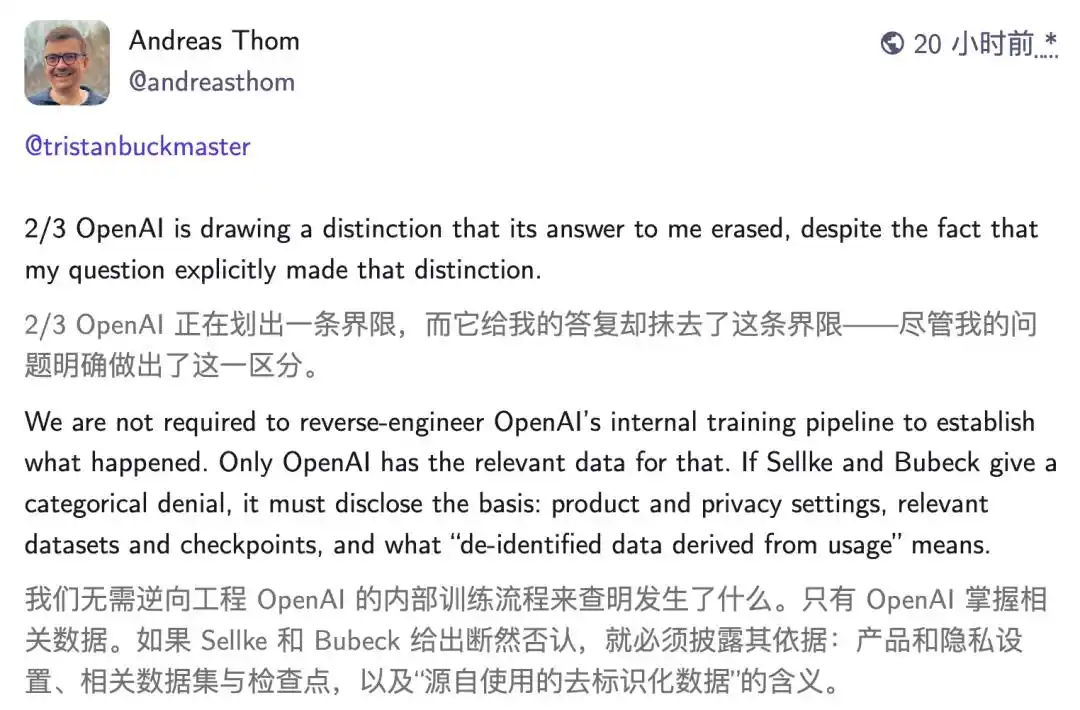
Thom后来回忆,OpenAI的这句回应不仅粗暴,更充满了诡辩的恶劣色彩:
他明明分清了「进入训练集」和「在线调用」两件事,而 Sellke 却用一句含糊的「没发生过」,企图把所有实质性问题直接抹杀。
然而,傲慢的代价,来得极快。
仅仅几周后,OpenAI就在千禧年难题「纳维-斯托克斯方程」争端中被逼到了墙角。
面对Tristan Buckmaster和Levent Alpöge的步步紧逼,OpenAI的官方公关口径突然反转:
虽然坚称没有调取特定账户的私人数据,但承认——
「无法排除使用来自客户产品的去标识化数据(de-identified data)来改进模型」。
回旋镖,精准地扎回了自己的喉咙。
此前面对Thom时还信誓旦旦地说「绝无此事」,转眼间就承认去标识化数据被拿去改进模型。
合着只要把数学家的名字抹去,人类尚未公开发表的颠覆性智慧,就能堂而皇之地在硅谷巨头的服务器里被「去标识化洗白」,摇身一变成为AI的自主智慧?!
在最新的长文中,Andreas Thom毫不留情地撕碎了这种文字游戏:
去标识化也许能删掉一个学者的名字,但它删不掉一个数学思想的智力内核。
数学史上,最大智力掠夺?
从Tristan Buckmaster,再到如今站出来的 Andreas Thom。
第一次可以说是「巧合」,第二次被解释为「误会」,那么接二连三的顶尖学者集体反水与指控,已经彻底击碎了OpenAI所精心编织的「AGI科学神话」。
正如Valerio Capraro在其长文中所呼吁的那样,这已经不再是几起孤立的学术纠纷:
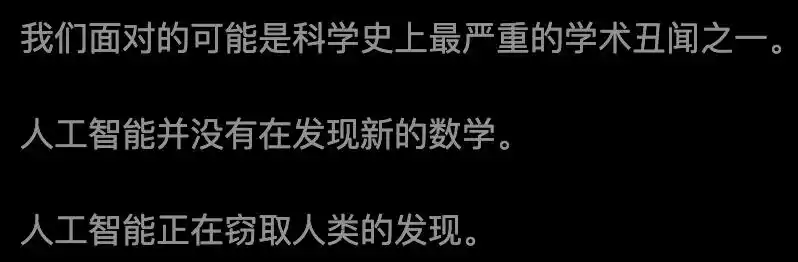
如果这一系列的指控被坐实,我们正在见证的,是科学史上最大规模的智力掠夺丑闻之一。
那么下一次,还有哪位科学家敢打开这扇通往深渊的对话框?
如今,OpenAI欠全球数学界一个真正的交代。
参考资料:
https://x.com/IntCyberDigest/status/2097825474961395899
https://x.com/ValerioCapraro/status/2097791836269977996?s=20
https://mathstodon.xyz/@andreasthom
本文来自微信公众号“新智元”,作者:ASI启示录,编辑:桃子