多模态检索头首次被锁定:揭开大模型长文档内部检索真相

marsbit发布于2026-09-08更新于2026-09-08

文章摘要

随着Office AI和文档智能体的发展,大模型开始直接处理长篇图文材料,但能够接收整份文档并不意味着能正确使用信息。面对包含文字、图片、表格和图表的长文档,模型首先需要定位与问题真正相关的证据。 EMNLP 2026接收的论文《Can Retrieval Heads See Images? Multimodal Retrieval Heads in Long-Context Vision-Language Models》从模型内部研究了这一过程。研究团队关注的问题是:当证据已出现在输入中时,模型内部是否存在一组**注意力头**,负责将问题指向相关的文本或视觉内容?他们识别出这类**多模态检索头**。 研究团队受QRHead启发,提出了MMRetHeads检测方法,通过分析每个注意力头中问题token指向标注证据区域的注意力强度来评分。研究覆盖了Qwen3-VL、Gemma3等6个长上下文视觉语言模型,测试了多种任务和上下文长度。分析发现,文本和图像检索会共享一部分注意力头,但不同长度和证据形式也会调用不同的头。 为验证这些注意力头的重要性,研究团队屏蔽了高分的检索头,并与屏蔽随机头的结果对比。在文字、图片检索及真实的长文档问答任务中,屏蔽检索头导致模型表现显著下降,而随机屏蔽影响较小。这证明这些头对模型访问证据具有因果作用。屏蔽后,模型可能出现读取错误或声称“信息不足”的情况。 基于此,研究团队进一步将这些注意力头中的证据信号用于多模态文档检索,无需额外训练检索器。在MMDocIR基准测试中,该方法在页面级和版面级检索的Recall@1指标上均超越了已报告的最强基线。 该研究揭示了长文档视觉语言模型内部用于定位多模态证据的关键机制,并为高效、准确的文档检索提供了新思路。

随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。

但能够接收一整份文档,不等于能够正确使用其中的信息。

面对上百页文字、图片、表格和图表,模型首先要回答的是:与当前问题真正相关的证据,究竟在哪里?

EMNLP 2026接收的论文新作“Can Retrieval Heads See Images? Multimodal Retrieval Heads in Long-Context Vision-Language Models”,从模型内部研究了这一过程。
从“装得下”到“找得到”

长上下文视觉语言模型可以同时接收大量文字和图片,但最终答案通常只依赖其中很小的一部分信息。相关证据可能是一段文字,也可能藏在表格、图片或某个版面区域中。

研究团队关注的问题是:当证据已经出现在输入中时,模型内部是否存在一组注意力头,负责将问题指向相关的文本或视觉内容?

团队将识别出的这类注意力头称为多模态检索头(MMRetHeads)。

怎么识别多模态检索头?

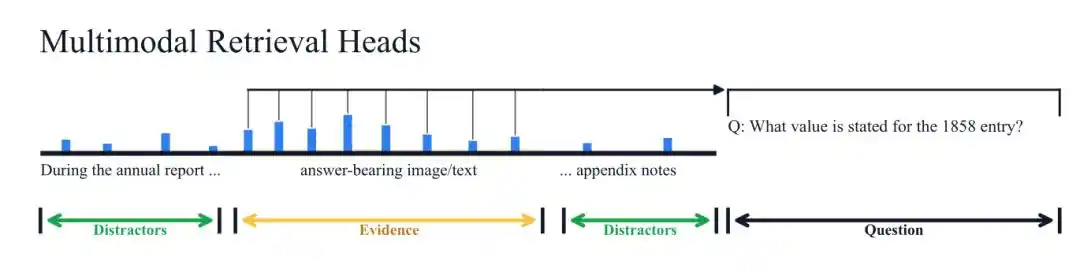
受QRHead启发,研究团队提出了MMRetHeads检测方法。

具体来说,该方法分析每个注意力头的question-to-evidence attention,也就是问题token指向标注证据区域的注意力。证据如果是文字,就对应文字token;证据如果位于图片中,则对应视觉token。指向证据的注意力越强,该注意力头的检索得分就越高。
△

研究覆盖Qwen3-VL、Gemma3等6个长上下文视觉语言模型,包括文本检索、图像检索、渲染文本检索和相同图像检索等任务,并测试8K、16K、32K、64K和128K上下文长度。

分析还发现,文本和图像检索会共享一部分注意力头,但不同上下文长度和证据形式也会调用不同的注意力头。

这些注意力头真的会影响模型回答吗?

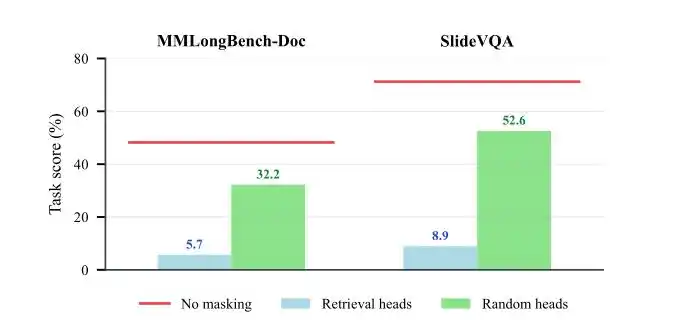
注意力指向证据,只能说明两者存在关联。为了检验模型是否真正依赖这些头,研究团队屏蔽得高分的检索头,再与屏蔽相同数量随机注意力头的结果进行比较。

在文字和图片检索任务中,屏蔽检索头后,模型在不同上下文长度和证据位置下的表现显著下降;随机屏蔽造成的影响则小得多。

同样的差异也出现在更真实的长文档问答中:

  • MMLongBench-Doc:48.2→5.7
  • SlideVQA: 71.2→8.9

随机屏蔽后,两项任务仍分别保留32.2和52.6分。屏蔽检索头造成的下降明显更大,说明这些头不只是把注意力放在证据附近,也对模型访问证据具有因果作用。

在多模态推理任务中也能观察到类似结果。检索头被屏蔽后,模型有时会在图表仍然存在于输入中的情况下回答“信息不足”,也可能读取错误内容或生成不存在的依据。
△

从内部机制到文档检索

研究团队进一步把这些注意力头中的证据信号用于多模态文档检索。

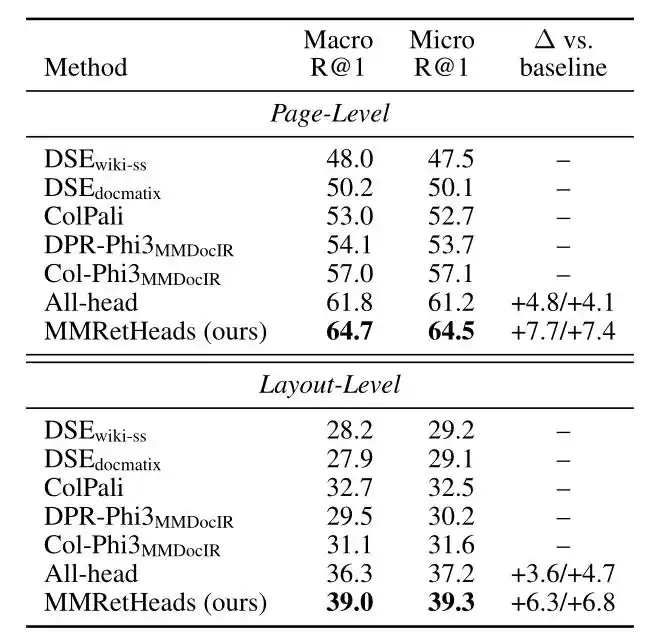
给定一个问题,MMRetHeads会为候选页面或版面区域计算相关性分数,并据此对候选项进行排序。页面级检索寻找包含证据的整页,版面级检索则进一步定位页面中的文字块、表格、图片或图表。整个过程不需要额外训练检索器。

在MMDocIR上,Qwen3-VL-8B的页面级Recall@1达到64.7,较最强的已报告基线提高7.7个百分点;版面级Recall@1达到39.0,较最强的已报告基线提高6.3个百分点。
△

论文链接:https://arxiv.org/abs/2605.27243

本文来自微信公众号“量子位”,作者:MMRetHeads团队

热门币种推荐

相关问答

QEMNLP 2026接收的这篇论文主要研究什么?

A论文主要研究长上下文视觉语言模型在处理长篇图文文档时,其内部是否存在一组特殊的注意力头(称为多模态检索头),负责将用户问题指向输入中相关的文本或视觉证据区域。

Q研究团队是如何识别和验证多模态检索头的?

A研究团队通过分析注意力头的“问题到证据”注意力模式来识别,指向证据的注意力越强则得分越高。通过屏蔽这些高分检索头,并与屏蔽随机注意力头的结果对比,发现屏蔽检索头导致模型性能显著下降,从而验证了它们对模型访问证据具有因果作用。

Q在真实的长文档问答任务中,屏蔽多模态检索头对模型表现有何影响?

A在真实长文档问答任务中,屏蔽多模态检索头导致模型性能急剧下降。例如在MMLongBench-Doc任务中,得分从48.2降至5.7;在SlideVQA任务中从71.2降至8.9。而随机屏蔽造成的影响要小得多,证明了这些检索头的关键作用。

Q多模态检索头的发现有什么实际应用价值?

A研究发现可以将这些注意力头中提取的证据信号,直接用于多模态文档检索任务。无需额外训练检索器,即可为候选页面或版面区域计算相关性分数并进行排序,实现了高效的页面级和版面级文档检索。

Q文中提到,这项研究在哪个基准测试上取得了较好的检索效果?

A在MMDocIR基准测试上,利用MMRetHeads的Qwen3-VL-8B模型取得了显著提升。页面级Recall@1达到64.7,较最强基线提高了7.7个百分点;版面级Recall@1达到39.0,较最强基线提高了6.3个百分点。

你可能也喜欢

数学大爆炸,OpenAI 一夜攻克722个数学难题,准黎曼猜想已被证明

全球数学界与AI界被一则消息震惊:OpenAI未经同行评审,突然在GitHub发布了由其内部前沿模型生成的722篇数学手稿,涵盖372个此前悬而未决的顶级数学难题家族。其中,最引人注目的是模型证明了“准黎曼猜想”,将狄利克雷L-函数的无零点区域推进到实部大于7/8的半平面,并彻底排除了朗道-西格尔零点,是解析数论领域的巨大飞跃。该成果已通过Lean形式化验证。 此外,AI还攻克了理论计算机科学中的关键难题“基本半定阈值下的普通NP-困难”,在无需“唯一游戏猜想”假设、仅基于P≠NP的条件下,证明了Basic-SDP近似比是多项式时间算法的理论极限。在千禧年难题“霍奇猜想”上,AI成功证明了复数域上具有复乘的阿贝尔簇的有理霍奇猜想,撕开了一个重要缺口。其他突破还包括证明乘法函数的普通两点相关性猜想,以及解决凸几何中对称与非对称的马勒猜想等。 OpenAI披露,多数难题的证明仅消耗其内部模型平均3小时的算力。此举在数学界引发巨大震动,学者们既感到兴奋也深怀忧虑,认为这标志着AI在纯数学领域取得了颠覆性突破,可能根本改变数学研究的方式。尽管以传统方式消化和验证这些成果仍需时间,但一个由硅基智能驱动的新探索时代似乎已经开启。

marsbit1小时前

数学大爆炸,OpenAI 一夜攻克722个数学难题,准黎曼猜想已被证明

marsbit1小时前

AI改不了“DNA”,闪迪还能牛多久?

本文分析闪迪在NAND存储行业当前“超级行情”下的前景。核心观点认为,AI推理需求正将NAND从数据仓库变为计算必需品,驱动了本轮价格暴涨(部分产品现货价涨5-8倍)和闪迪毛利率跃升(FY26Q4达84.6%)。然而,文章判断这轮行情本质仍是超级周期,非行业竞争壁垒的根本改变。 **供需分析显示行情可能持续至2027年底:** * **供给端**:2026-2028年行业扩产克制,新增产能主要来自中国(如长江存储),海外厂商主要依靠技术升级(增加3D堆叠层数)提升单片晶圆产出,而非大规模新建产线。大规模新产能(如三星、铠侠/闪迪新厂)集中在2029年后释放。 * **需求端**:AI需求(尤其是数据中心)已成为主导,2026年占比过半。增量主要来自AI推理场景,如英伟达Rubin芯片的独立上下文存储柜(2027年关键增量)、云厂商自研芯片及QLC数据湖。消费电子需求则持续承压。 **对闪迪的预测与估值:** * 文章预测闪迪的NAND平均售价(ASP)将在FY28(2027年7月-2028年6月)见顶,随后因供需转向宽松而周期性回落,FY30 ASP预计较FY28下降约40%。 * 尽管有长期协议(NBM)部分托底,但高毛利率(80%+)难以在完整周期内持续,预计FY30毛利率将回落至72%左右。 * 估值层面,文章认为闪迪当前股价已基本反映中性预期。未来能否继续上涨,关键在于市场是否相信2028年后行业供需能保持平衡、价格不至大幅下滑。 **结论:** AI改变了NAND的需求结构和周期强度,但未改变其周期性本质。闪迪的“超级行情”预计还能延续一段时间,但2028年后将面临供给增加和价格回落的考验。

marsbit2小时前

AI改不了“DNA”,闪迪还能牛多久?

marsbit2小时前

交易

现货

热门文章

如何购买T

欢迎来到HTX.com!我们已经让购买Threshold Network Token(T)变得简单而便捷。跟随我们的逐步指南,放心开始您的加密货币之旅。第一步:创建您的HTX账户使用您的电子邮件、手机号码注册一个免费账户在HTX上。体验无忧的注册过程并解锁所有平台功能。立即注册第二步:前往买币页面,选择您的支付方式信用卡/借记卡购买:使用您的Visa或Mastercard即时购买Threshold Network Token(T)。余额购买:使用您HTX账户余额中的资金进行无缝交易。第三方购买:探索诸如Google Pay或Apple Pay等流行支付方法以增加便利性。C2C购买:在HTX平台上直接与其他用户交易。HTX场外交易台(OTC)购买:为大量交易者提供个性化服务和竞争性汇率。第三步:存储您的Threshold Network Token(T)购买完您的Threshold Network Token(T)后,将其存储在您的HTX账户钱包中。您也可以通过区块链转账将其发送到其他地方或者用于交易其他加密货币。第四步:交易Threshold Network Token(T)在HTX的现货市场轻松交易Threshold Network Token(T)。访问您的账户,选择您的交易对,执行您的交易,并实时监控。HTX为初学者和经验丰富的交易者提供了友好的用户体验。

3.0k人学过发布于 2024.07.04更新于 2026.06.02

如何购买T

相关讨论

欢迎来到HTX社区。在这里,您可以了解最新的平台发展动态并获得专业的市场意见。以下是用户对T(T)币价的意见。

活动图片