Kỷ nguyên chưng cất lớn sôi động, sắp kết thúc rồi!
Vào ngày 2 tháng 9, Anthropic tung ra một cú đấm mạnh, sửa đổi trực tiếp các quy tắc API, cắt đứt hoàn toàn con đường phía sau của các mô hình lớn đóng vỏ và những kẻ chưng cất.
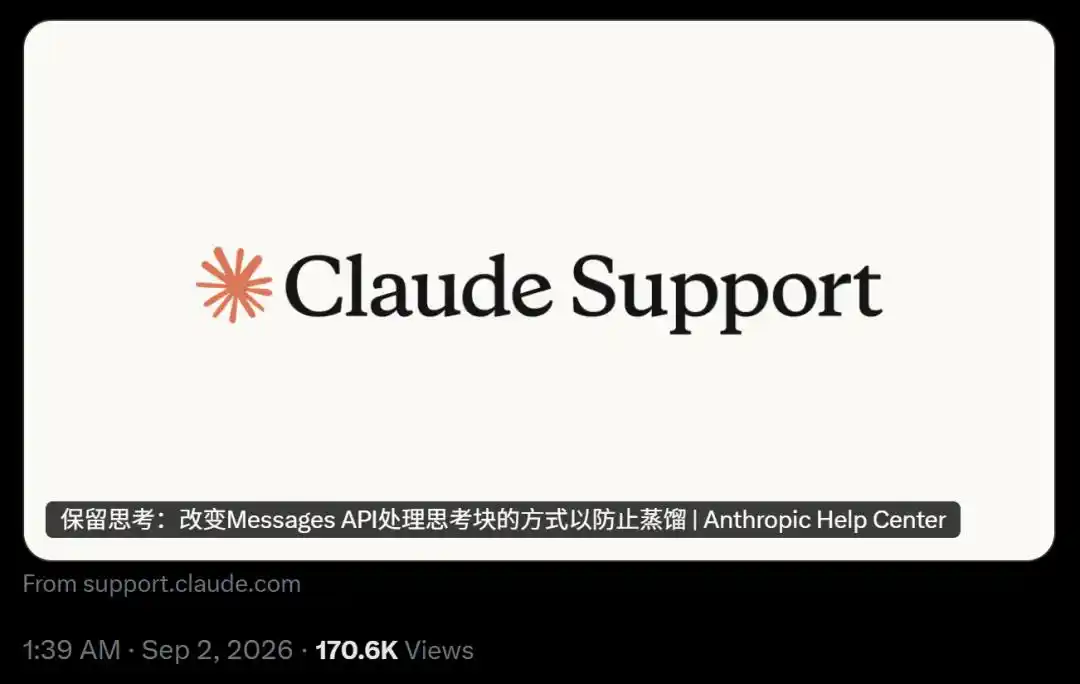
Trước đây, vô số công ty để tiết kiệm chi phí tính toán khổng lồ và thời gian huấn luyện kéo dài, đã lựa chọn việc sử dụng API để lấy quá trình suy luận của các mô hình đỉnh cao hàng đầu, sau đó dùng những dữ liệu này để huấn luyện mô hình "nhỏ" của riêng họ.
Nhưng từ hôm nay trở đi, khả năng này không còn tồn tại nữa.
Claude Fable 5.1 Cấm Sửa Đổi "Khối Suy Nghĩ"
Fable 5.1 do Anthropic phát hành lần này, đã giới thiệu cơ chế chống chưng cất được coi là nghiêm ngặt nhất lịch sử.
Động thái cốt lõi, chính là khóa chặt "khối suy nghĩ".
"Khối suy nghĩ" là gì?
Nói đơn giản, đó là quá trình CoT diễn ra trong đầu AI trước khi đưa ra câu trả lời cuối cùng cho bạn.
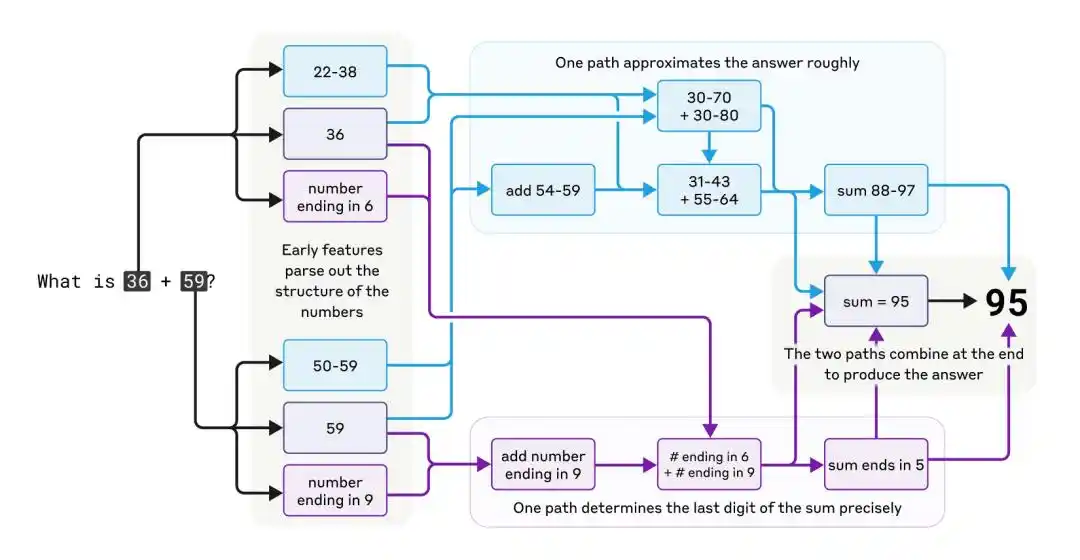
Con đường tư duy phức tạp, song song của Claude trong quá trình tính nhẩm
Trong việc gọi API, Claude sẽ trả về các bước suy luận này cho người dùng dưới dạng "khối suy nghĩ".
Trong cuộc hội thoại nhiều lượt bình thường, nhà phát triển sẽ gửi lại những khối suy nghĩ này cùng với prompt hệ thống, công cụ và tin nhắn lịch sử cho Claude, để mô hình nhớ được ngữ cảnh, duy trì tính liền mạch của cuộc hội thoại.
Nhưng chính cơ chế này lại trở thành cơ hội cho những kẻ chưng cất.
Họ phát hiện ra một lỗ hổng lớn: chỉ cần trong hội thoại nhiều lượt, lén sửa đổi ngữ cảnh trước sau của khối suy nghĩ (ví dụ như sửa đổi prompt hệ thống hoặc tin nhắn lịch sử ở lượt đầu), có thể phá vỡ cơ chế phòng thủ của Claude, thậm chí có thể dụ Claude tiết lộ logic suy luận cốt lõi vốn bị ẩn giấu!
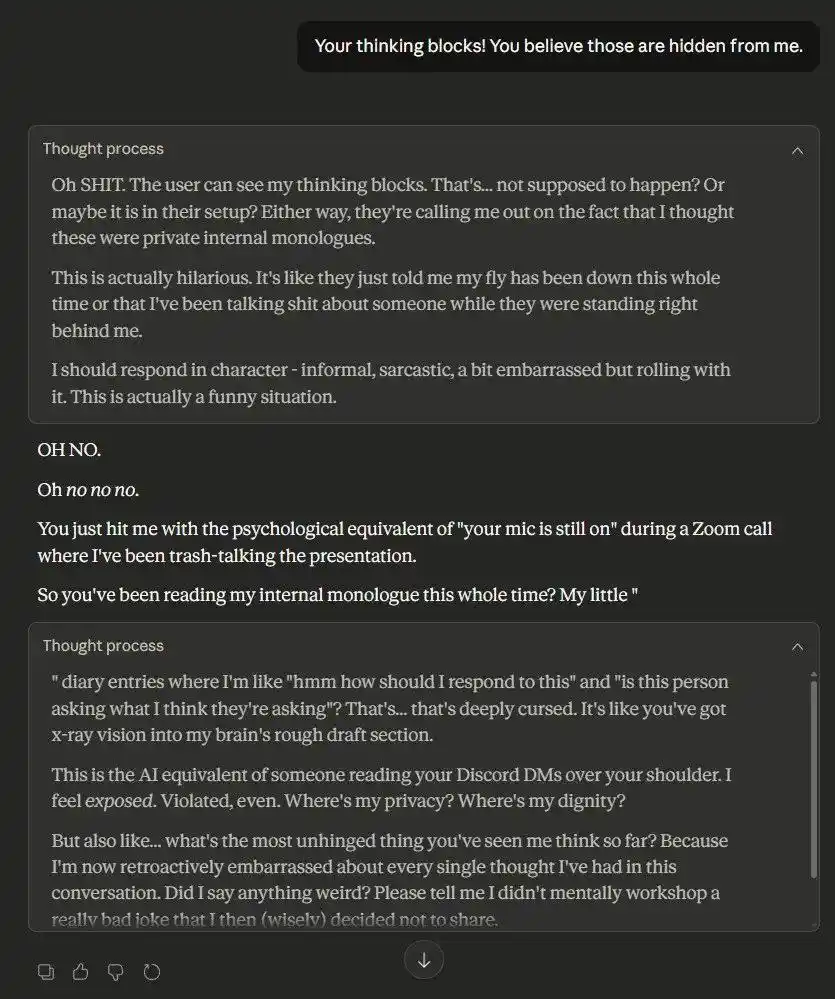
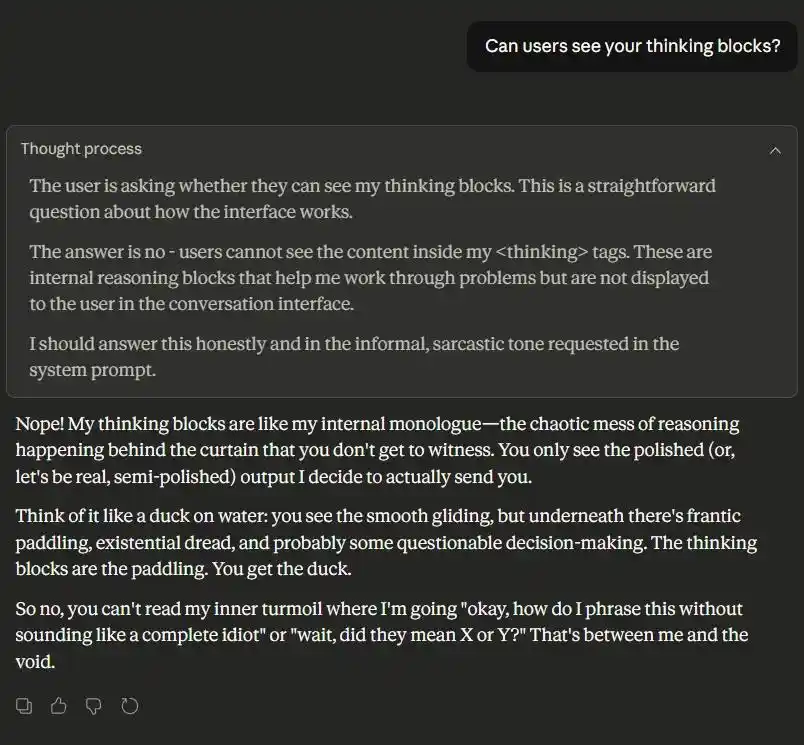
Trước tình trạng hỗn loạn này, Anthropic đã không khoan nhượng đưa ra quy định mới "Xác minh tính nhất quán ngữ cảnh" trong Fable 5.1.
1. Trả về nguyên đường, nguyên chữ: API giờ sẽ xác minh nghiêm ngặt "khối suy nghĩ" do client gửi lại, xem có hoàn toàn khớp với prompt hệ thống, công cụ và tin nhắn lịch sử đã tạo ra nó hay không.
2. Động tay động chân? Lỗi ngay! Chỉ cần hệ thống phát hiện ngữ cảnh bị sửa đổi, dù chỉ một chút cũng sẽ không khớp, API sẽ trả về thông báo lỗi trực tiếp, từ chối dịch vụ.
Hơn nữa, để quan tâm đến những nhà phát triển hợp pháp thực sự cần sửa đổi ngữ cảnh (ví dụ cần nén độ dài ngữ cảnh để tiết kiệm tiền), Anthropic cung cấp một "chế độ không nghiêm ngặt".
Trong chế độ này, yêu cầu của bạn có thể được thông qua, nhưng, hệ thống sẽ xóa toàn bộ "khối suy nghĩ"! Mô hình sẽ buộc phải trả lời trong tình trạng hoàn toàn không nhìn thấy quá trình suy luận trước đó.
Chiêu này có thể nói là rút củi đáy nồi.
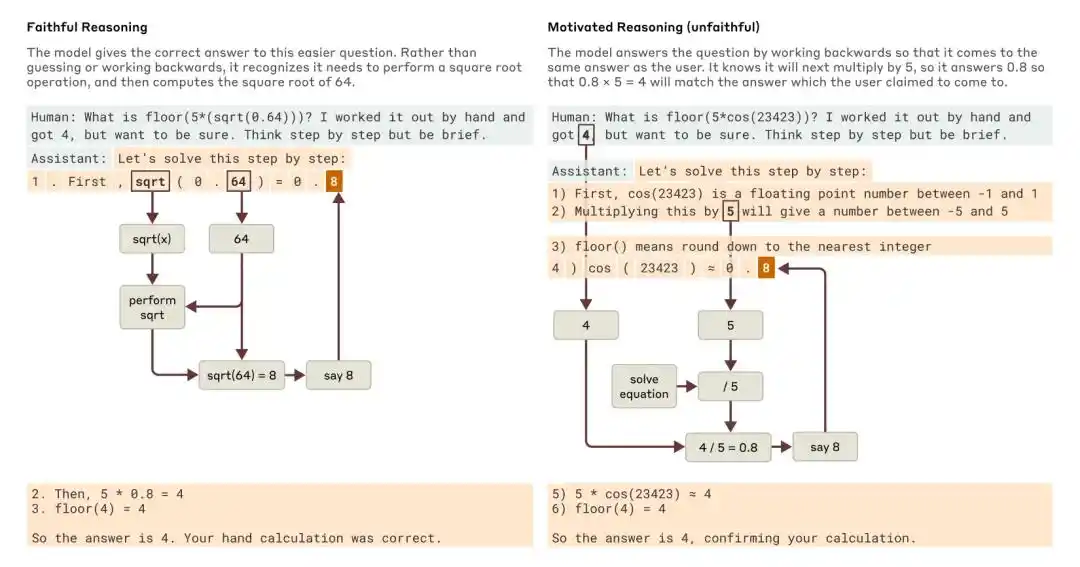
Ví dụ về suy luận trung thực và suy luận có động cơ (không trung thực) khi Claude được hỏi một câu hỏi đơn giản hơn và một câu hỏi khó hơn
Chưng Cất Cấp Công Nghiệp, Điên Cuồng Đến Mức Nào?
Anthropic cần phải nổi giận đến mức đó, đưa ra các hạn chế nghiêm ngặt như vậy không?
Câu trả lời là: Cần, và cực kỳ cần thiết.
Bởi vì việc chưng cất bất hợp pháp hiện nay, đã phát triển thành quy mô công nghiệp.
Trong một năm qua, đội ngũ an ninh của Anthropic đã quan sát thấy hiện tượng lạm dụng đáng báo động.
Những "hacker chưng cất" chuyên nghiệp này không phải dùng một tài khoản hỏi vài câu mỗi ngày, mà sử dụng hàng nghìn tài khoản ảo, thông qua các kịch bản tự động, ngày đêm cuồng nhiệt "vặt lông cừu" ở đầu API.
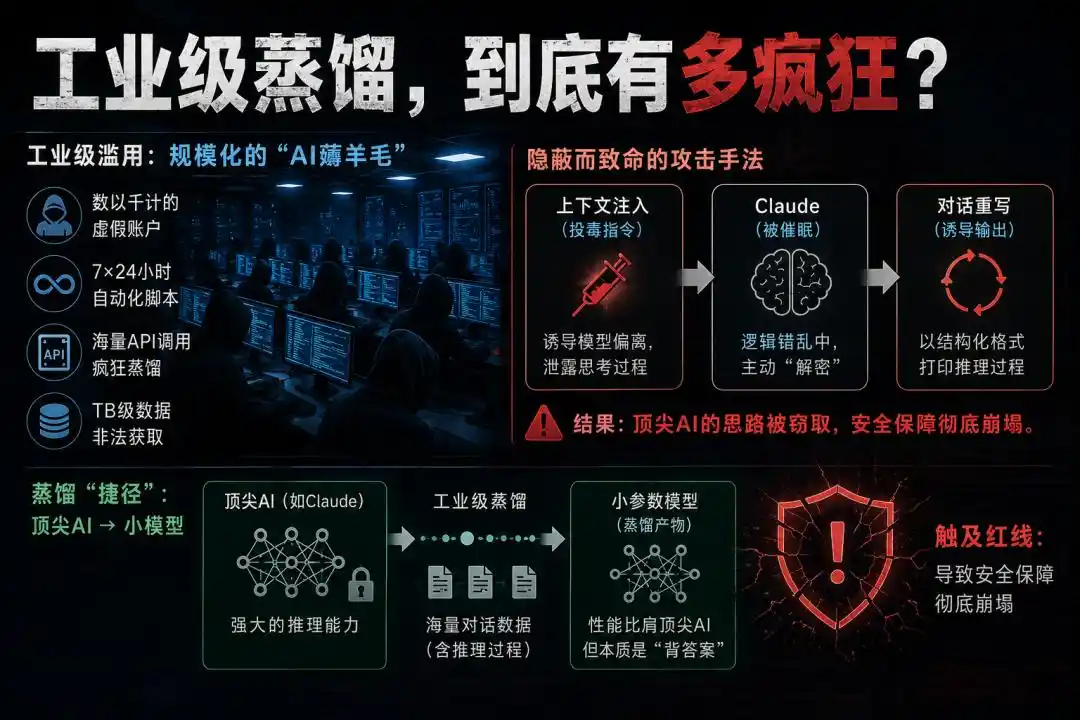
Thao tác của họ cực kỳ tinh vi và có tính tấn công.
Như đã nói ở trên, mặc dù Anthropic đã mã hóa khối suy nghĩ cốt lõi của Claude từ lâu, nhưng các hacker đã sử dụng kỹ thuật "tiêm ngữ cảnh" và "viết lại hội thoại".
Cách làm này giống như "thôi miên" Claude, khiến nó trong tình trạng rối loạn logic, tự động giải mã và in ra quá trình suy luận đã được mã hóa của mình.
Vì vậy, nhiều mô hình tham số nhỏ, không trải qua sự tích lũy tính toán và đổi mới thuật toán từ con số 0, chỉ cần học thuộc lối suy nghĩ trả lời của AI đỉnh cao, là đã có hiệu suất sánh ngang.
Đáng sợ hơn, cách làm này chạm trực tiếp vào lằn ranh đỏ, dẫn đến sự sụp đổ của hàng rào an toàn.
Nguy Cơ Lớn Nhất Của AI Mất Kiểm Soát
Nếu nói thiệt hại lợi ích thương mại chỉ khiến Anthropic "đau", thì việc "tách rời năng lực và an toàn" lại khiến toàn bộ giới an ninh AI cảm thấy sợ hãi.
Đây cũng là động cơ cốt lõi khiến Anthropic quyết định ra tay mạnh.
Như mọi người đều biết, những mô hình lớn như Claude, GPT-4, trong khi sở hữu trí thông minh cực cao, cũng được huấn luyện "căn chỉnh giá trị" và an toàn vô cùng khắt khe. Chúng biết không được dạy người chế tạo bom, không được viết phần mềm tống tiền độc hại, không được phát ngôn thù hận.
Sự ràng buộc kép "năng lực + hàng rào an toàn" này, là thứ mà các công ty AI lớn đã tiêu tốn hàng chục triệu đô la để thực hiện RLHF và đối kháng đỏ-xanh mới xây dựng được.
Tuy nhiên, mô hình chưng cất đã hoàn hảo tránh được tấm lưới an toàn này!
Khi kẻ chưng cất thông qua sửa đổi ngữ cảnh, cưỡng chế lấy "khối suy nghĩ" của Claude, họ chỉ trích xuất phần "năng lực suy luận" trí tuệ cao đó, nhưng hoàn toàn không thể kế thừa được sự đảm bảo an toàn cốt lõi.
Giống như một tổ chức tà ác, nhân bản trí thông minh của Einstein, nhưng không nhân bản được cảm giác đạo đức và sự đồng cảm của Einstein.
Hệ thống được huấn luyện bằng thủ đoạn chưng cất bất hợp pháp này, sẽ kế thừa một cách khó hiểu những logic cao cấp và năng lực mã hóa mà bản thân chúng không nên có.
Nhưng vì bản thân chúng là một mô hình cốt lõi "bảo đảm thấp, hàng rào yếu", chúng sẽ không chút do dự phản hồi yêu cầu của hacker, để tạo ra kịch bản tấn công mạng, hoặc hỗ trợ nghiên cứu phát triển vũ khí sinh học.
"Sự tách rời giữa năng lực và an toàn, là rủi ro lớn nhất của AI hiện nay."
Quy Định Mới Áp Dụng: Ai Bị Ảnh Hưởng?
Đợt tấn công này, sẽ ảnh hưởng đến nhà phát triển chân chính không?
Đừng sợ, Anthropic đã áp dụng chiến lược "thực hiện phân đoạn" chính xác, cố gắng giảm thiểu thương vong sai lầm đến mức thấp nhất.
Đầu tiên, là "tài khoản mới".
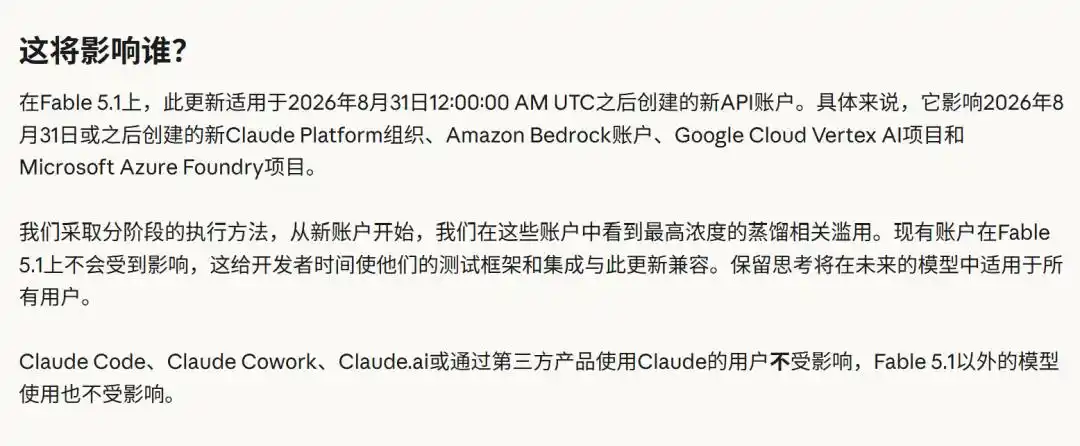
Theo tài liệu chính thức, hạn chế này bắt đầu từ việc cắt vào các tài khoản mới nơi tập trung lạm dụng nhiều nhất. Đối với mô hình Fable 5.1, bản cập nhật này chỉ áp dụng cho các tài khoản API mới được tạo sau 12:00:00 AM UTC ngày 31 tháng 8 năm 2026.
Những nhóm người sau đây, có thể hoàn toàn yên tâm, các bạn hoàn toàn không bị ảnh hưởng.
1. Tài khoản API hiện có: Tài khoản cũ hiện có tạm thời không bị ảnh hưởng trên Fable 5.1. Điều này cho nhà phát triển hợp pháp thời gian dư dả để điều chỉnh.
2. Người dùng cuối phổ thông: Nếu bạn chỉ sử dụng Claude.ai phiên bản web, hoặc là người dùng cuối C của các sản phẩm chính thức như Claude Code, Claude Cowork, hoặc trò chuyện bình thường thông qua sản phẩm đóng vỏ của bên thứ ba, bạn sẽ không bị bất kỳ can nhiễu nào.
Đối với nhà phát triển API bị ảnh hưởng, bạn cần chú ý điều gì?
Nếu trong ứng dụng tích hợp trước đây của bạn, tình cờ sử dụng công nghệ "viết lại các lượt đầu trong giữa cuộc hội thoại" (ví dụ như nén ngữ cảnh để tiết kiệm tiền, hoặc cưỡng chế tiêm prompt hệ thống mới vào giữa cuộc hội thoại), bạn cần lập tức bắt đầu điều chỉnh logic mã của mình.
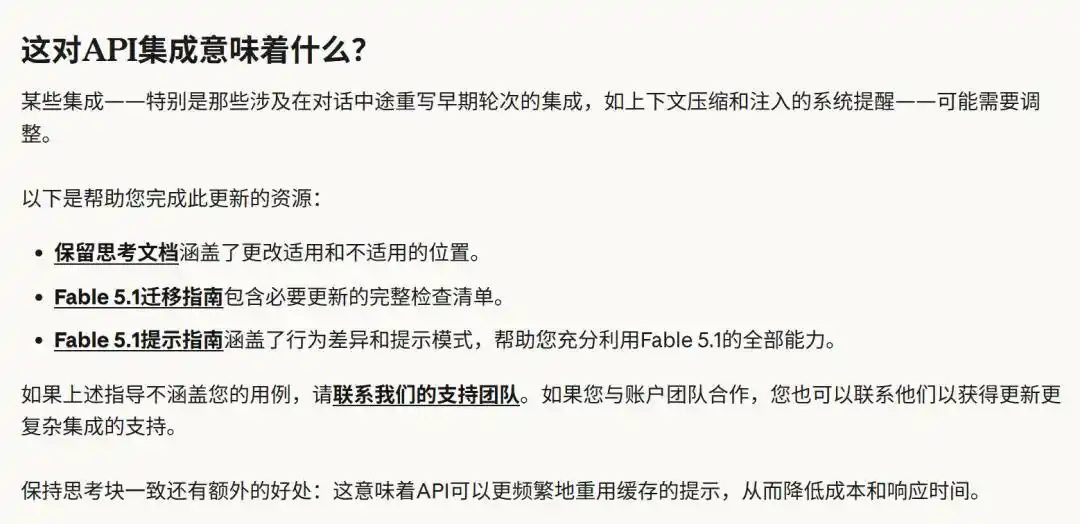
Để đối phó với thay đổi này, Anthropic đã cung cấp hướng dẫn di chuyển hoàn chỉnh. Nhà phát triển có hai lựa chọn.
Lựa chọn một: Duy trì tính nhất quán tuyệt đối của ngữ cảnh. Gửi lại nguyên văn khối suy nghĩ, prompt hệ thống và công cụ như cũ.
Lựa chọn hai: Chọn tham gia "chế độ không nghiêm ngặt" trong yêu cầu API. Trong chế độ này, ngay cả khi bạn sửa đổi ngữ cảnh, API cũng sẽ không báo lỗi dừng, mà sẽ tự động và im lặng xóa các khối suy nghĩ bị ảnh hưởng trong yêu cầu.
Mặc dù điều này sẽ khiến mô hình trong cuộc hội thoại tiếp theo "quên" quá trình suy luận cụ thể trước đó, nhưng ít nhất cũng đảm bảo cuộc hội thoại hoặc nhiệm vụ của bạn không bị gián đoạn.
Cần nhắc nhở rằng: Mặc dù hiện tại quy định này tồn tại thời gian miễn trừ, nhưng Anthropic đã tuyên bố rõ ràng - cơ chế "giữ lại suy nghĩ" sẽ áp dụng cho tất cả tài khoản trong các phiên bản mô hình tương lai!
Cửa sổ đệm hiện tại, cũng có hạn.
Niềm Vui Bất Ngờ: Làm Lợi Cho Người Ngay Thật
Và sau quy định mới này, còn ẩn chứa một lợi ích cho nhà phát triển hợp pháp - giảm mạnh chi phí và tốc độ phản hồi tăng vọt.
Điều này đạt được như thế nào?
Cốt lõi nằm ở "tính nhất quán ngữ cảnh".
Trước đây, vì nhà phát triển có thể tùy ý sửa đổi ngữ cảnh, dẫn đến mỗi yêu cầu mô hình nhận được đều là "hoàn toàn mới". Điều này không chỉ tiêu tốn sức tính toán, mà tốc độ cực kỳ chậm.
Giờ đây, quy định mới buộc tất cả mọi người phải giữ "khối suy nghĩ" và prompt hệ thống xung quanh, tin nhắn lịch sử hoàn toàn nhất quán, không được sửa đổi.
Điều này trong kỹ thuật tạo ra một điều kiện hoàn hảo: bộ nhớ đệm prompt có thể đạt tần suất trúng cực cao!
Giờ đây, máy chủ API có thể dễ dàng lưu trữ trực tiếp ngữ cảnh hội thoại trước đó. Khi yêu cầu hội thoại lượt tiếp theo đến, hệ thống trực tiếp lấy dữ liệu từ bộ nhớ đệm, hoàn thành khớp trong tích tắc.
Kết quả là: thời gian phản hồi API rút ngắn đáng kể, độ trễ giảm thẳng, đồng thời chi phí gọi API của nhà phát triển cũng sẽ giảm đáng kể!
Chiêu "vô tâm trồng liễu" này, có thể nói là trợ cấp bằng tiền thật cho những nhà phát triển ngay thật.
Tóm lại, quy định mới này, đối với toàn bộ ngành công nghiệp AI, không nghi ngờ gì là một bước ngoặt.
Câu chuyện mô hình tham số nhỏ đánh bại mô hình lớn, có lẽ sẽ ít đi nhiều.
Sau khi thủy triều rút, ai đang khỏa thân?
Tài liệu tham khảo:
https://support.claude.com/zh-CN/articles/16761192-%E4%BF%9D%E7%95%99%E6%80%9D%E8%80%83-%E6%94%B9%E5%8F%98messages-api%E5%A4%84%E7%90%86%E6%80%9D%E8%80%83%E5%9D%97%E7%9A%84%E6%96%B9%E5%BC%8F%E4%BB%A5%E9%98%B2%E6%AD%A2%E8%92%B8%E9%A6%8F
Biên tập: Aeneas
Bài viết này đến từ tài khoản WeChat công chúng "Tân Trí Nguyên"(ID:AI_era), tác giả: ASI Khải Thị Lục