Chuyện chạy điểm benchmark gần đây có vẻ không ổn lắm.
Ngày 8/9, công ty phân tích SemiAnalysis "ném" liên tiếp năm tweet, chỉ đích danh hai gã khổng lồ nghìn tỷ Google và Meta —
Gemini 3.8 Flash và Muse Spark 1.3 là "hai mô hình có dấu hiệu can thiệp vào bảng xếp hạng rõ ràng nhất".
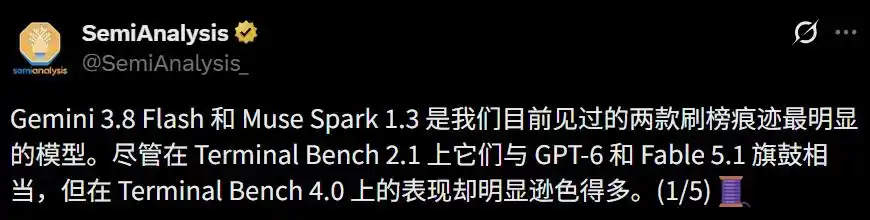
Bằng chứng, rất rõ ràng.
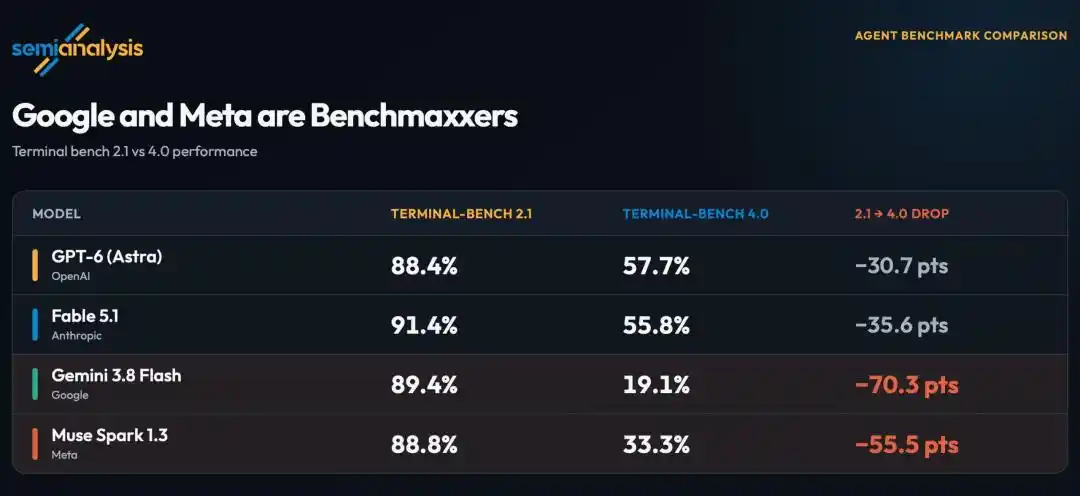
Trên bảng xếp hạng Terminal-Bench 2.1 đo khả năng làm việc thực tế của Agent, Gemini 3.8 Flash đạt 89.4 điểm, xếp thứ 2 trong tổng số 182 mô hình, vượt cả GPT-6 Astra.
Thế nhưng, sang đến Terminal-Bench 4.0 vừa ra mắt ngày 29/8, chính mô hình này chỉ đạt 19.1 điểm, tụt xuống thứ 12 trong số 14 đối tượng được kiểm tra, thành tích giảm mất hơn 80%.
Cùng thời điểm, GPT-6 Astra từ 88.4 điểm giảm xuống 57.7 điểm, coi như còn giữ được khoảng 65%.
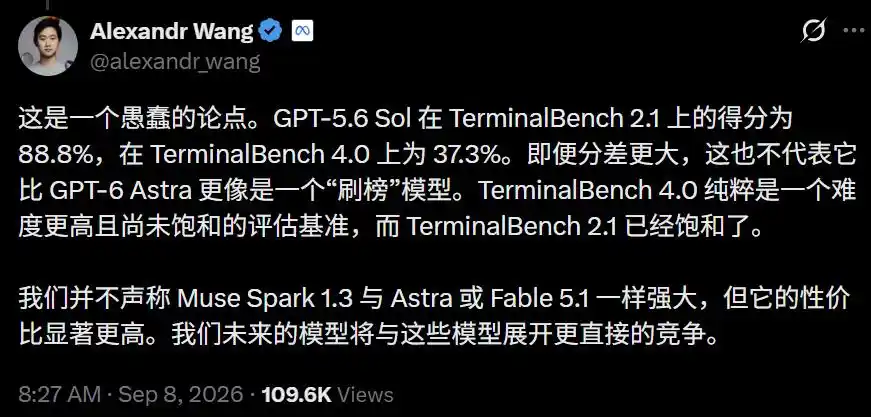
Chỉ 27 phút sau, Alex Wang, Giám đốc AI của Meta, đích thân xuất hiện trong phần bình luận và thẳng thắn bày tỏ quan điểm với sáu chữ: Đây là một luận điểm ngớ ngẩn.
Ông cho rằng GPT-5.6 Sol trên bảng 2.1 đạt 88.8 điểm, trên bảng 4.0 giảm xuống 37.3 điểm, chênh lệch còn lớn hơn nhưng không ai nói Sol can thiệp điểm số.
Đồng thời ông nhấn mạnh, Meta chưa bao giờ nói Muse Spark 1.3 mạnh ngang Astra hay Fable 5.1, chỉ là hiệu quả chi phí của nó rõ ràng cao hơn.
Đổi đề thi, điểm số tụt thẳng đứng
Giới thiệu ngắn gọn, Terminal-Bench đo lường khả năng làm việc thực tế của Agent.
Phương pháp là đưa cho mô hình một terminal và một mục tiêu mơ hồ, phần còn lại để nó tự xoay sở. Sau đó, hệ thống phải tự lập kế hoạch, gọi công cụ, viết script, gặp lỗi thì tự sửa.
Trên phiên bản 2.1 mà giới công nghiệp đã "khai thác" gần nửa năm qua, thành tích của hai mô hình này thực sự ấn tượng.
Gemini 3.8 Flash đạt 89.4 điểm xếp thứ 2, Muse Spark 1.3 với 88.8 điểm xếp thứ 4, theo ngay sau là GPT-6 Astra với 88.4 điểm và Claude Fable 5.1 với 85.02 điểm.
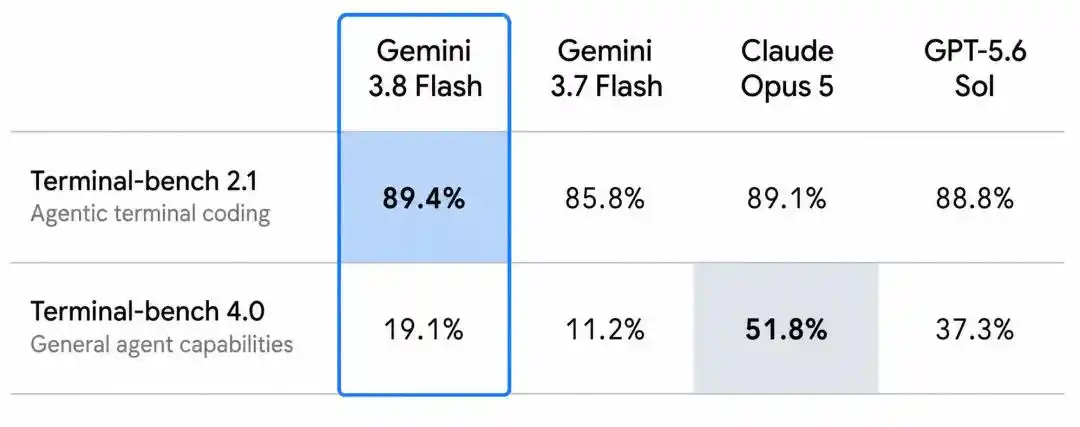
Đáng nói, một mô hình Flash giá rẻ và một sản phẩm mới tập trung vào hiệu quả chi phí của Meta, cả hai đều áp đảo các flagship từ hai phòng thí nghiệm hàng đầu.
Rồi thì, phiên bản 4.0 xuất hiện.
Đề thi mới gồm 66 câu hỏi, không chỉ loại bỏ 8 câu cũ đã bị "khai thác triệt để", sửa đổi lớn 19 câu, mà còn áp dụng giới hạn thời gian làm bài siêu dài 8 giờ.
Cơ chế chống gian lận cũng được tăng cường cực mạnh.
Ban tổ chức không chỉ đặt ra 35 tiêu chí chấm điểm chi tiết, mà còn thêm một vòng "Thử nghiệm đối kháng gian lận" chuyên biệt, cố ý để Agent tự thử khai thác lỗ hổng trong cơ chế tính thưởng, bất kỳ câu nào có thể bị khai thác sẽ bị loại ngay lập tức.
Bảng xếp hạng mới ra mắt, phong cảnh đột nhiên thay đổi.
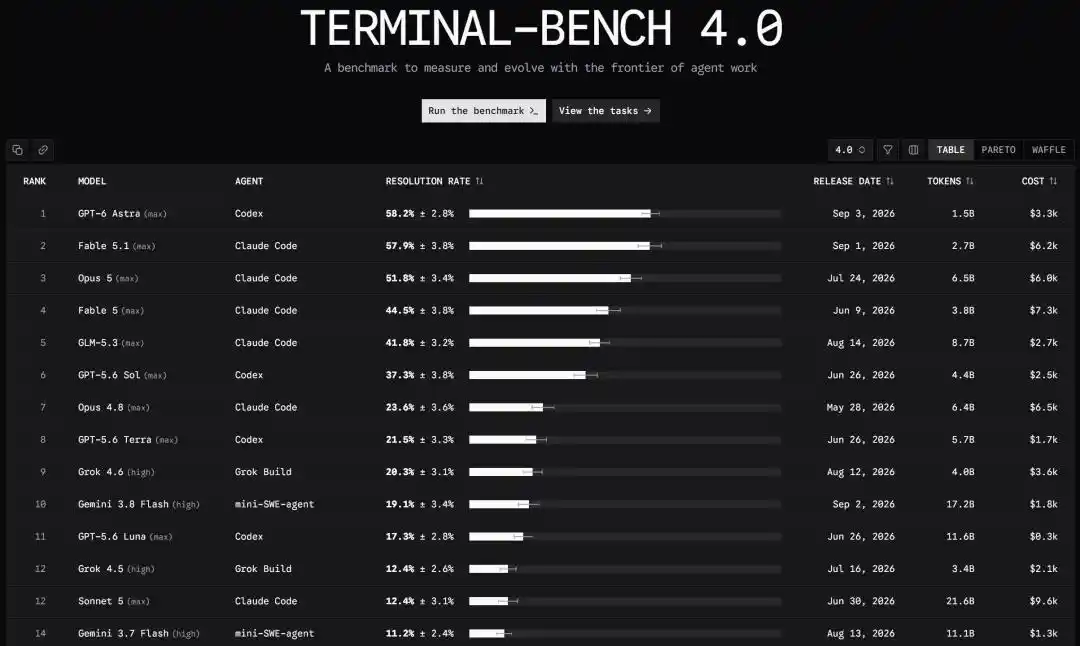
Claude Mythos 5.1(max) đạt 60.9 điểm giữ vững vị trí, GPT-6 Astra và Claude Fable 5.1 lần lượt theo sau với 57.7 điểm và 55.8 điểm, tiếp theo là Claude Opus 5 với 52.3 điểm. Thế hệ trước là GPT-5.6 Sol và Terra đạt 37.3 điểm và 23.6 điểm.
Trong khi đó, Gemini 3.8 Flash lao dốc thẳng xuống 19.1 điểm. Còn theo biểu đồ từ SemiAnalysis, thành tích của Muse Spark 1.3 là 33.3 điểm.
Tóm lại là thế này.
Trên bảng cũ, Gemini 3.8 Flash còn có thể áp đảo GPT-6 Astra; trên bảng mới, điểm của nó thậm chí không bằng một phần ba của đối thủ, và còn bị vượt mặt bởi GPT-5.6 Terra thế hệ trước.
Không cần chép đáp án, chỉ cần mua một bộ "đề thi mật"
Cãi nhau thì cứ cãi, nhưng cáo buộc trong tweet thứ hai của SemiAnalysis mới thực sự là nội tình ngành.
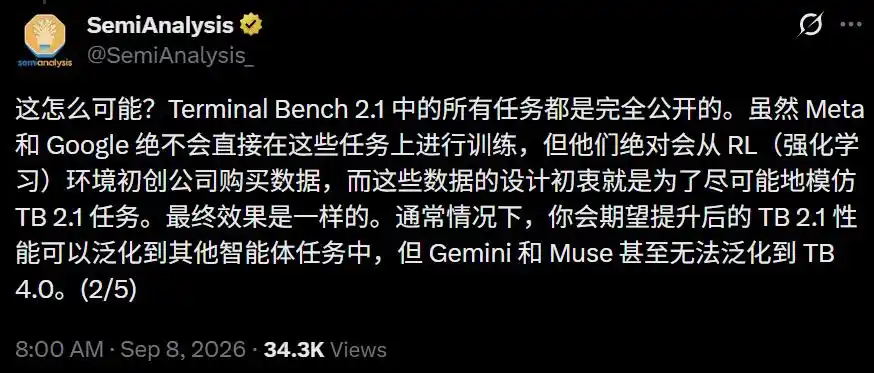
Theo họ, các nhiệm vụ trong Terminal Bench 2.1 là hoàn toàn công khai, Meta và Google chắc chắn không ngốc đến mức trực tiếp dùng đề gốc để huấn luyện, nhưng họ chắc chắn sẽ mua dữ liệu, đặc biệt là những dữ liệu huấn luyện được thiết kế vô cùng gần với dạng đề TB 2.1. Hiệu quả cuối cùng thực chất chẳng khác gì gian lận.
Và đây, chính là cách chơi nâng cao trong việc tác động đến bảng xếp hạng vào năm 2026.
Cách "làm ô nhiễm" trước đây rất thô sơ, trực tiếp trộn đề gốc vào dữ liệu huấn luyện trước để mô hình học thuộc lòng.
Loại việc này kiểm tra một cái là lòi ra ngay, rửa một lượt dữ liệu là thành tích hiện nguyên hình.
Ngành công nghiệp đã vấp ngã không ít lần vì điều này, ví dụ gần 40% mẫu HumanEval bị ô nhiễm, GSM8K sau khi khử ô nhiễm giảm 13 điểm. Đáng kể nhất là SWE-bench, kiểm tra lại bằng bộ mã nguồn riêng, điểm số giảm thẳng một nửa.
Vì vậy, giờ đây các ông lớn không đụng vào đề gốc nữa, mọi người chuyển sang mua "đề thi mô phỏng giống đề thật". Tức là cung cấp cho mô hình một hệ thống nhiệm vụ khép kín để thử sai và nhận thưởng.
Hiện tại, đây đã là một món kinh doanh chín muồi với giá niêm yết rõ ràng.
Một nhiệm vụ huấn luyện đơn lẻ có giá từ 200 đến 2000 USD, nhiệm vụ kỹ thuật phần mềm phức tạp thậm chí có thể lên tới 20.000 USD.
Nếu muốn sao chép một trang web làm môi trường huấn luyện giao diện người dùng, khoảng 20.000 USD.
Nếu yêu cầu tái tạo một sản phẩm cỡ Slack, đó là khởi điểm 300.000 USD.
Gặp khách hàng yêu cầu mua độc quyền, giá có thể tăng thêm 4 đến 5 lần.
Theo nghiên cứu của Epoch AI, Anthropic từng thảo luận nội bộ về việc chi hàng tỷ USD mỗi năm cho việc này. Hợp đồng theo quý thường lên tới sáu hoặc bảy con số, một nhà nghiên cứu tiết lộ giá trung bình từ 300.000 đến 500.000 USD mỗi quý.
Phía cung cấp có ít nhất 35 công ty làm món kinh doanh này, đa số là nhóm khởi nghiệp dưới 20 người. Các gã khổng lồ dữ liệu truyền thống cũng đang chuyển đổi hết, Scale AI trước khi được Meta đầu tư đã có doanh thu trên 1,4 tỷ USD, doanh thu hàng năm lặp lại (ARR) của Surge cũng tiệm cận 1 tỷ USD.
Tình hình hiện tại rất huyền ảo.
Một bên là ngân hàng đề thi hoàn toàn công khai của các bảng xếp hạng, bên kia là chuỗi cung ứng bán đề thi đã chín muồi. Muốn mô hình đạt điểm cao trên một bảng xếp hạng nào đó, thực sự không cần tốn công gian lận, chỉ cần rút tiền ra đặt hàng.
Vừa là cơ sở bán đề, vừa là giám thị coi thi
Tiếp theo, SemiAnalysis chỉ đích danh một công ty tên là Datacurve.
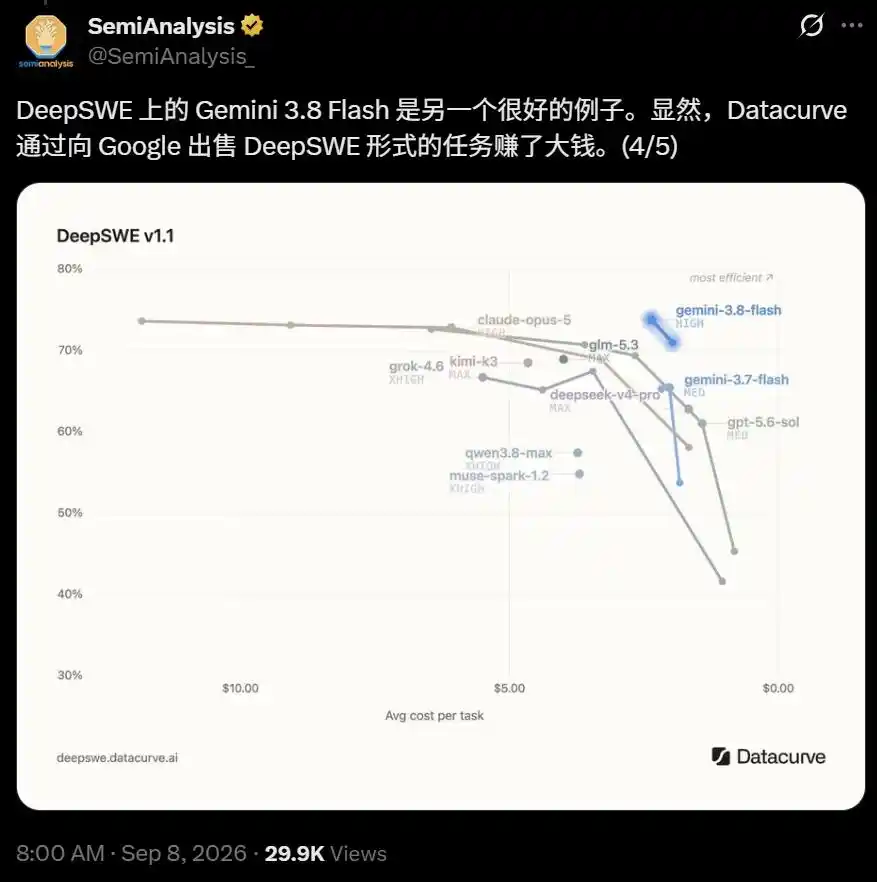
Trên bảng xếp hạng DeepSWE 1.1 chuyên kiểm tra lập trình chu kỳ dài, Muse Spark 1.3(max) đứng đầu với 75.4 điểm, GPT-6 Astra và Claude Opus 5 theo sát, Gemini 3.8 Flash đạt 73.8 điểm xếp thứ tư.
Hai mô hình bị cáo buộc can thiệp điểm số, một cái nhất, một cái tư.
Hẳn là, bạn đã phát hiện ra điều mờ ám đằng sau này rồi.
Bảng xếp hạng này do Datacurve tổ chức, mà con đường kiếm tiền của Datacurve, lại chính là bán "dữ liệu mã hóa cấp chuyên gia và môi trường học tăng cường" cho các phòng thí nghiệm tiên phong.
DeepSWE không chỉ là benchmark riêng của Datacurve, mà việc chấm điểm còn sử dụng môi trường đánh giá do chính họ vận hành.
Vừa làm cơ sở dạy thêm bán đề, vừa làm giám thị ra đề coi thi, có thể nói là hoàn toàn xác thực.
Hạn sử dụng của các bảng xếp hạng, sắp hết
Cuối cùng, SemiAnalysis thuận thế đưa ra một bản án từ cho toàn bộ việc đánh giá công khai của ngành.
Họ cho rằng, suy cho cùng đây là số phận của tất cả các benchmark công khai chất lượng. TB 4.0 cũng không ngoại lệ, việc nó hiện nay trông có vẻ chính xác, chỉ là vì nó mới phát hành được hai tuần.
Chỉ cần đề thi của nó vẫn còn công khai, chẳng bao lâu nữa nó sẽ bị tất cả các phòng thí nghiệm tự nhận là "tiên phong" khai thác đến mòn.
Giải pháp cuối cùng mà SemiAnalysis đưa ra rất trực tiếp, đó là làm nhiều benchmark riêng tư chất lượng cao hơn.
Hướng đi thì đúng, nhưng cái giá phải trả cũng thảm khốc không kém.
Một khi tất cả việc đánh giá đều được riêng tư hóa, các bảng xếp hạng công khai sẽ hoàn toàn trở thành thông cáo tiếp thị của các công ty.
Thành tích thực sự có sức phân biệt, chỉ sẽ lưu chuyển trong bóng tối giữa các phòng thí nghiệm và các cơ quan đánh giá riêng tư.
Các ông lớn đương nhiên vui mừng chào đón, vì thi kín thì không ai có thể ôn bài trước được.
Nhưng đối với đông đảo nhà phát triển, cây thước công cộng dùng để đo lường công bằng tất cả các mô hình, e rằng sẽ không bao giờ tìm lại được.
Tài liệu tham khảo:
https://x.com/SemiAnalysis_/status/2097112791471522292
Biên tập: Moses
Bài viết từ tài khoản WeChat công khai "New Zhi Yuan", tác giả: ASI Khải thị lục