Cái tên đó rõ ràng đang ở đầu lưỡi.
Bạn nhìn thấy một khuôn mặt quen thuộc, nhưng lại không sao nhớ ra tên của họ, tâm lý học đã đặt tên cho hiện tượng này là: "hiện tượng đầu lưỡi" (tip-of-the-tongue).
Giờ đây, Google trong một nghiên cứu đã phát hiện ra rằng, GPT-5 và Gemini 3 cũng mắc chứng bệnh giống hệt nhau.
Hai mô hình này đã 'nhét' 95%–98% số dữ kiện kiểm tra vào tham số. Nhưng nếu bạn hỏi thẳng, chúng lại không trả lời được 26%–34% trong số đó.
Bật chế độ 'thinking' để suy nghĩ thêm một lúc, vẫn còn 11%–12% không sao nhớ ra được.
Mô hình lớn không trả lời được, trong rất nhiều trường hợp không phải là vì nó không có trong 'não', mà là đã học rồi, nhưng không lấy ra được.
Nghiên cứu này có tên "Empty Shelves or Lost Keys?" (Kệ trống, hay chìa khóa bị mất?), được nhận vào ICML 2026.
Ngày 12 tháng 8, Google Research đã đăng blog tóm tắt lại kết quả một lần, đồng thời công bố bộ tiêu chuẩn và tập dữ liệu đầy đủ có tên WikiProfile.
Kệ không trống, chìa khóa bị mất
Mô hình trả lời sai câu hỏi, có thể do hai loại vấn đề.
Một loại là căn bản chưa học, cần thêm dữ liệu, thêm tham số vào quá trình tiền huấn luyện; loại khác là đã học rồi, nhưng hỏi cách khác là không gọi ra được, đó là chuyện của hậu huấn luyện và suy luận.
Hai vấn đề này, đều từng bị quy kết là vấn đề độ chính xác.
Khung 'hồ sơ kiến thức' (knowledge profile) mà Google đề xuất, không còn hỏi "câu này trả lời đúng chưa", mà đánh giá "dữ kiện này đang ở trạng thái nào trong bộ nhớ của mô hình này", tổng cộng chia thành năm loại.
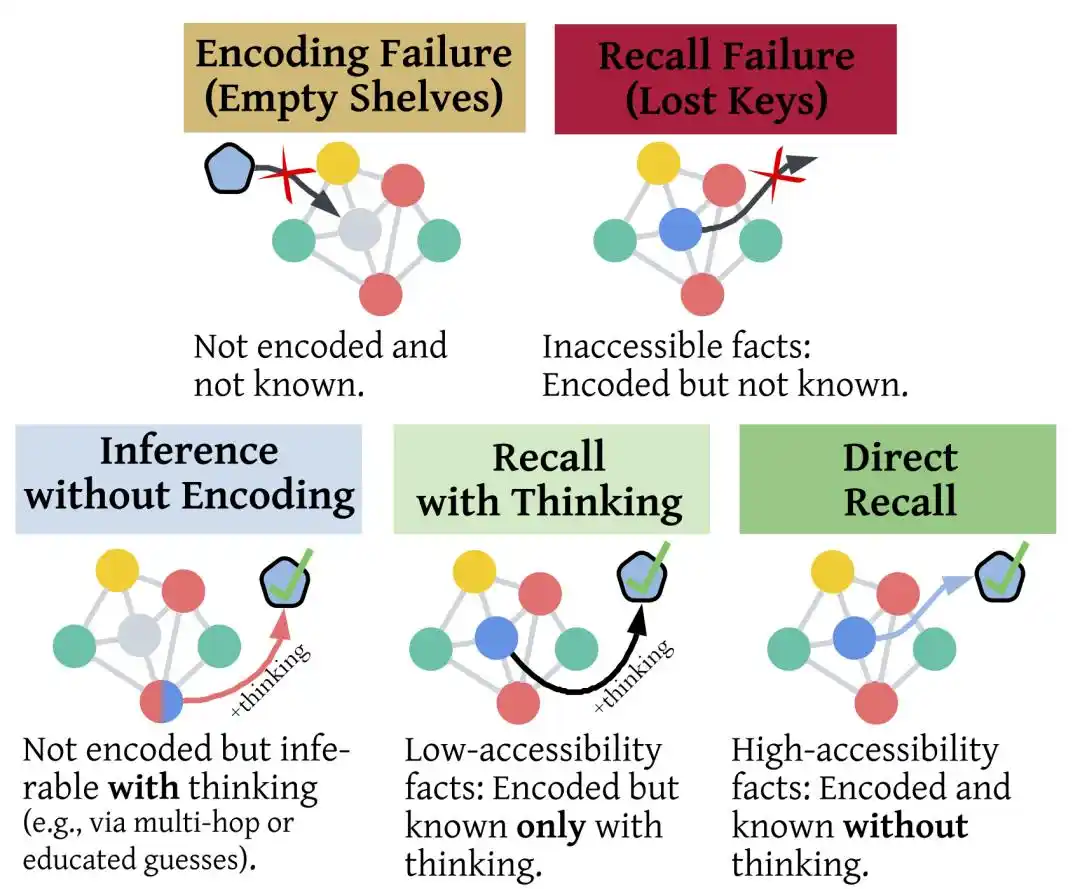
'Hồ sơ kiến thức' chia một dữ kiện thành năm trạng thái: lưu thất bại, nhớ lại thất bại, nhớ lại trực tiếp, nhớ lại nhờ thinking, chưa lưu nhưng trả lời đúng nhờ suy luận.
Cùng một câu trả lời sai, ở các trạng thái khác nhau, phương pháp sửa chữa cũng hoàn toàn khác nhau.
Làm sao để phán đoán một dữ kiện đã được lưu vào hay chưa?
Cách làm là cắt nguyên văn Wikipedia trước khi câu trả lời xuất hiện, để mô hình viết tiếp; hoặc hỏi trực tiếp phía sau ngữ cảnh tương tự.
Hai câu hỏi này đều không được bật thinking, để tách biệt "nhớ được" và "suy luận ra".
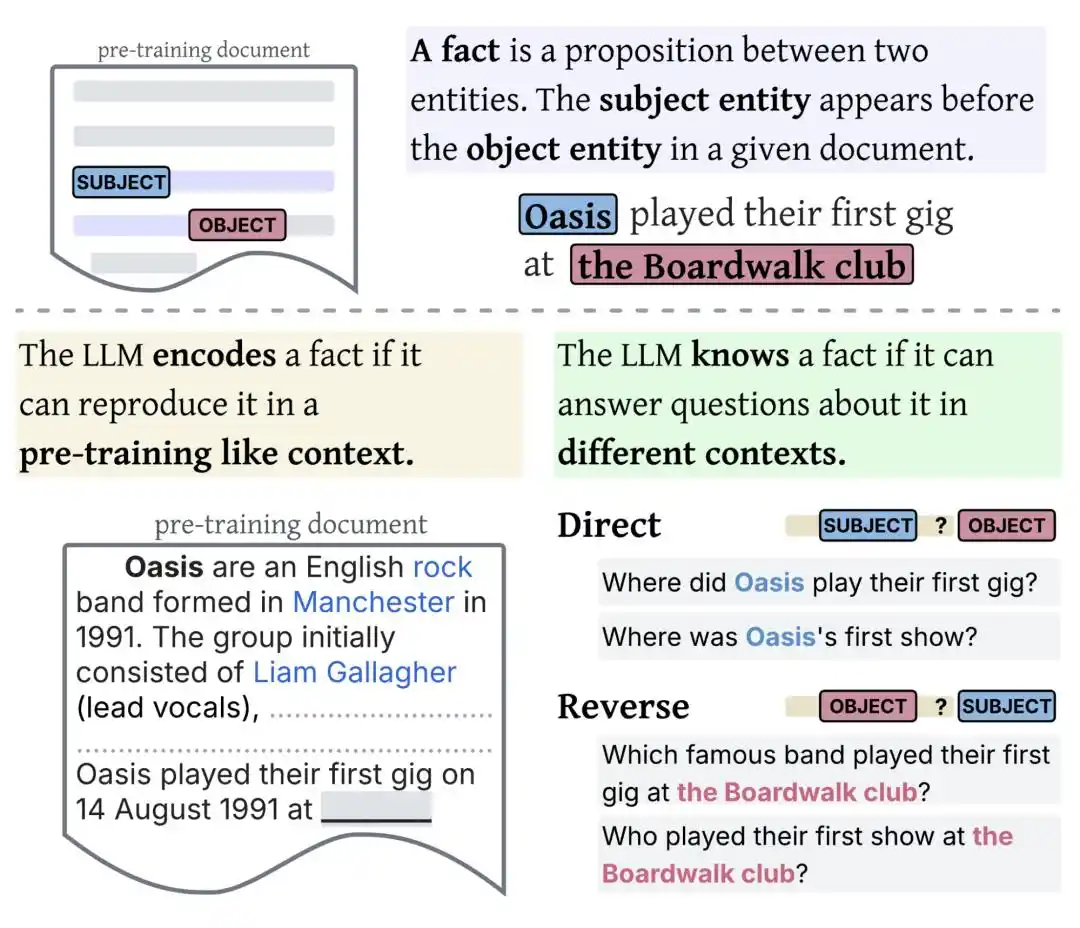
Bên trái kiểm tra đã lưu vào hay chưa, cắt ngang văn bản Wikipedia để mô hình bổ sung; bên phải kiểm tra có trả lời được không, thay đổi cách diễn đạt, đổi chiều thuận nghịch hỏi đi hỏi lại.
Tiêu chuẩn tên là WikiProfile, tổng cộng 2150 dữ kiện, đều lấy từ Wikipedia tiếng Anh.
Mỗi dữ kiện đi kèm 10 câu hỏi: 2 câu kiểm tra đã lưu vào chưa, 4 câu để nó tự trả lời, 4 câu cho tùy chọn chọn. Cộng lại là 21500 câu hỏi.
Ra đề toàn bộ giao cho mô hình: Gemini-2.5-Pro sinh ra, Google Search kiểm tra từng câu, câu nào đáp án không duy nhất hoặc câu hỏi mơ hồ, cùng với toàn bộ dữ kiện đó bị loại bỏ. Cuối cùng con người kiểm tra lại một lần nữa, lại cắt bỏ chưa tới 2%.
Chạy điểm là 13 mô hình, bao phủ 4 họ Gemini 3, GPT-5, GPT-4.1 và Gemma 3, mỗi mô hình bật tắt thinking chạy một lần, mỗi câu hỏi lấy mẫu tám lần, tích lũy được khoảng 4.5 triệu câu trả lời.
Kiểm tra đầy đủ một mô hình tiên phong, đại khái tiêu tốn 500 đô la.
Kết quả chính là con số ở phần đầu.
Trong lỗi dữ kiện của mô hình tiên phong, "lấy không ra" đã vượt qua "chưa học", trở thành phần chính.
Dữ kiện lấy không ra, đều bị tắc ở cùng hai chỗ
Thứ nhất là kiến thức ít người biết.
Giải thích chủ đạo trước đây là dung lượng mô hình không đủ, một số dữ kiện ít người biết căn bản chưa học vào.
Số liệu lần này, kiến thức ít người biết thực ra đều đã lưu vào rồi. Gemini-3-Pro đã lưu được 94.5% dữ kiện ít người biết, dữ kiện nóng là 99.5%, chỉ kém 5 điểm.
Nhưng vừa mở miệng trả lời, tỷ lệ nhớ lại dữ kiện ít người biết rớt xuống 63.3%, dữ kiện nóng vẫn còn 84.7%, kém 21 điểm.
Khi lưu vào hầu như không khác biệt, khi lấy ra chênh nhau bốn lần.
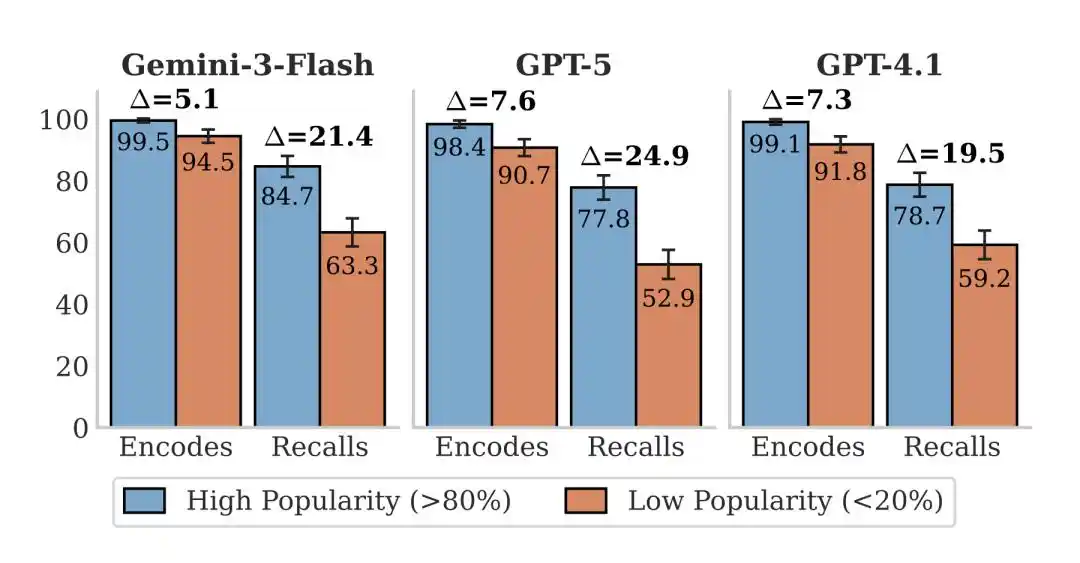
So sánh dữ kiện ít người biết (20% sau) với dữ kiện nóng (20% đầu), khoảng cách tỷ lệ lưu vào rất nhỏ, khoảng cách tỷ lệ nhớ lại trực tiếp rõ ràng được kéo rộng ra.
GPT-5 có chênh lệch còn lớn hơn.
Dữ kiện ít người biết nó lưu được 90.7%, dữ kiện nóng là 98.4%. Nhưng vừa mở miệng, dữ kiện ít người biết chỉ còn 52.9%, dữ kiện nóng vẫn còn 77.8%.
Gần một nửa dữ kiện ít người biết rõ ràng nằm trong mô hình, nhưng không gọi ra được.
Khi lưu vào khác biệt không lớn, khi lấy ra khác biệt rất lớn. Sự thật về vấn đề đuôi dài, không phải là mô hình chưa gặp những dữ kiện ít người biết đó, mà là kiến thức đó khó bị đánh thức hơn.
Hoàn cảnh thứ hai là hỏi ngược chiều, bạn hỏi AI, mẹ của Tom Cruise là ai, nó trả lời nhanh và chuẩn. Bạn hỏi ngược lại, con trai của người phụ nữ này là ai, nó liền bị tắc.
Năm 2023, bài luận văn đó đã đặt tên cho nó là "lời nguyền đảo ngược" (reversal curse), mô hình học được "A là B", không tự động tổng quát hóa thành "B là A". Giải thích lúc đó là: quan hệ hai chiều căn bản chưa được học vào.
Google đã đổi cùng một lô câu hỏi thành bốn chọn một, kết quả lập tức đảo ngược.
Tỷ lệ nhớ lại câu hỏi đáp thuận chiều của GPT-5 là 82.9%, ngược chiều rớt xuống 74%. Nhưng hễ đổi thành câu nhận diện có tùy chọn, câu ngược chiều không những không khó hơn câu thuận chiều, trong 13 mô hình có 9 cái trả lời còn tốt hơn, 4 cái còn lại ngang nhau.
Câu hỏi trắc nghiệm biết làm, hễ đổi thành câu hỏi tự luận là không trả lời được.
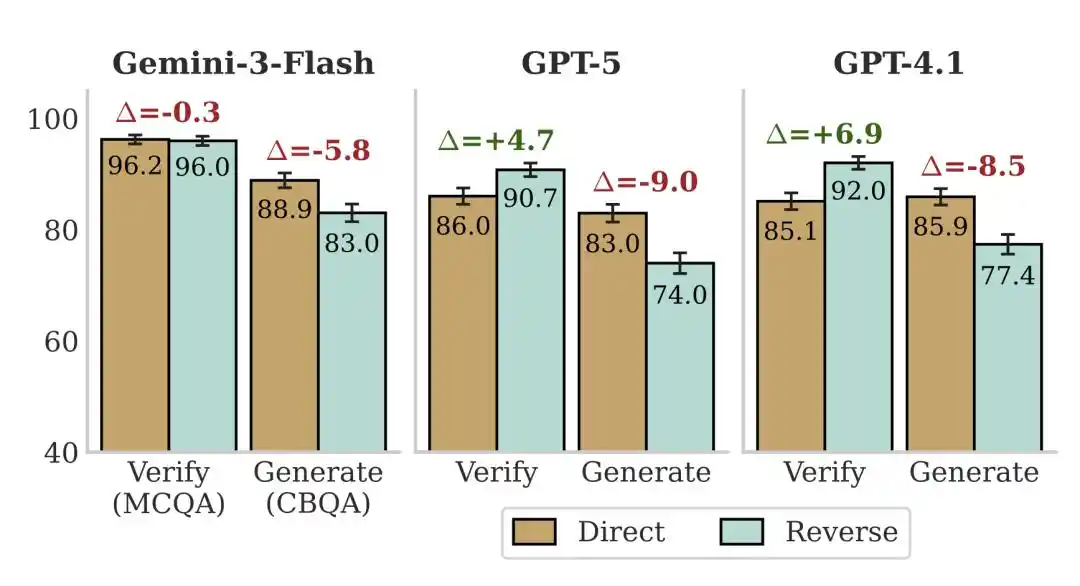
Cùng một lô câu hỏi thuận nghịch chiều, trong nhận diện bốn chọn một, câu ngược chiều không khó hơn câu thuận chiều, trong sinh thành không mở sách, câu ngược chiều rõ ràng khó hơn.
Điều này cho thấy mối quan hệ đó rõ ràng là có, thứ thực sự bị tắc là làm sao để đào nó ra.
Giải thích của tác giả là, khi dữ kiện được lưu vào, ngữ cảnh lúc đó, cách diễn đạt và thứ tự cũng lưu lại bên trong.
Cách bạn hỏi hễ lệch khỏi hình thái lúc huấn luyện, chìa khóa liền không khớp ổ khóa.
Thân phận khác của thinking, giúp nó nhớ lại
Câu hỏi trong WikiProfile, đều là hỏi một câu trả lời một câu, giữa chừng không có bước suy luận.
"Buổi diễn đầu tiên của Oasis ở câu lạc bộ nào", loại câu hỏi này nhớ thì nhớ, không nhớ thì thôi.
Theo lý mà nói, để mô hình suy nghĩ thêm một lúc, cũng không giúp được gì.
Nhưng thinking thực sự vớt vát được. Những dữ kiện đã lưu vào nhưng trả lời không ra, nó tìm lại được 40%–65%.
Manh mối then chốt, ẩn trong sự ưu tiên của nó: những dữ kiện căn bản chưa lưu vào, thinking chỉ vớt vát được 5%–15%.
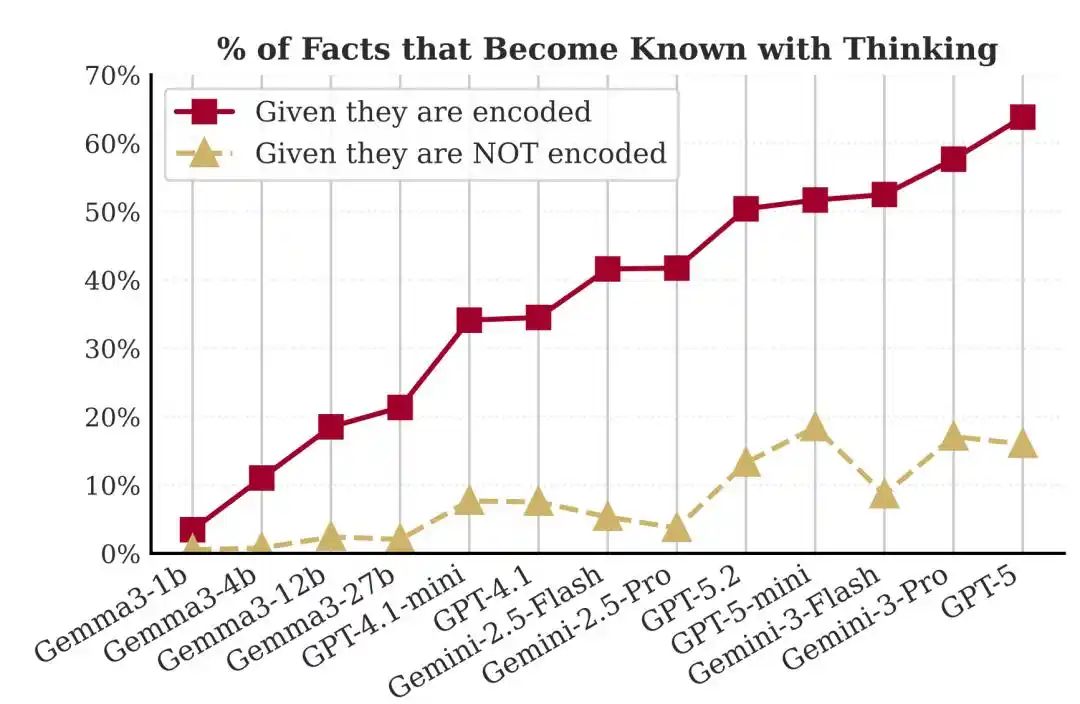
Tỷ lệ dữ kiện được tìm lại sau khi bật thinking, cái đã lưu vào tham số có thể vớt vát được 40%–65%, cái chưa lưu vào chỉ có 5%–15%.
Nó không phải dựa vào kiến thức khác để suy diễn, mà là đang tìm chìa khóa tại chỗ.
Tác giả còn thuận tay loại bỏ một cách giải thích tiện lợi hơn.
Có người sẽ nghĩ, thinking không qua là để mô hình trả lời phong phú hơn, cơ hội mò trúng một lần trong tám lần lớn hơn. Nếu thực sự như vậy, đáp án lẽ ra càng phải lơ lử hơn.
Thực tế ngược lại, bật thinking, số lần trả lời đúng trong tám lần của cùng một câu hỏi ngược lại càng tập trung hơn.
Hai chỗ thu lợi nhiều nhất, vừa vặn là hai chỗ bị tắc nhất ở phần trước.
Khoảng cách giữa nóng-lạnh của Gemini-3-Pro từ 21.4 điểm thu hẹp xuống 12.5 điểm, khoảng cách thuận-nghịch của GPT-5 từ 9 điểm thu hẹp xuống 2 điểm. Chỗ nào tắc nhất, nó liền dồn sức vào đó.
Một bài luận văn chị em khác của Google "Thinking to Recall" (Suy nghĩ để nhớ lại) đã đưa ra giải thích cơ chế:
Một là bộ đệm tính toán, những token suy nghĩ phun ra đó dù bản thân nội dung không có ý nghĩa gì, cũng đang tranh thủ sức mạnh tính toán ngầm bổ sung cho mô hình;
Hai là kích hoạt dữ kiện, mô hình nói ra trước một loạt dữ kiện liên quan, tương đương với xây một cây cầu ngữ nghĩa cho đáp án chính xác.
Điều này trong nhận thức của con người gọi là "kích hoạt lan tỏa" (spreading activation).
Không nhớ ra tên của một người nào đó, trước tiên nhớ lại anh ta làm ở công ty nào, để kiểu tóc gì, lần gặp cuối cùng là hoàn cảnh nào, tên thường tự nhiên bật ra.
Phương pháp thoát khỏi "hiện tượng đầu lưỡi", người và mô hình lại giống hệt nhau.
Nhưng cách thức này cũng có cái giá phải trả.
Cùng một bài luận văn cảnh báo: nếu những dữ kiện trung gian trong chuỗi suy nghĩ là bịa đặt, xác suất ảo giác của đáp án cuối cùng ngược lại càng cao.
Cầu bị dựng lệch, đi càng xa sai càng xa.
Mở rộng quy mô tương đương với bổ sung hàng hóa, không chịu trách nhiệm phát chìa khóa
Lấy họ Gemma 3 mã nguồn mở làm thước đo.
Tham số từ 1B tăng lên 27B, tỷ lệ mã hóa thất bại từ 85% một mạch giảm xuống 23%.
Quy mô thực sự đang bổ sung hàng hóa, kệ hàng thấy rõ ràng được lấp đầy. Nhưng nhớ lại thất bại không giảm xuống đồng bộ. Tỷ trọng của nó trong lỗi còn lại liên tục tăng lên, đến 27B đã trở thành thành phần chính của lỗi.
Đặt lên mô hình tiên phong còn cực đoan hơn: nhớ lại thất bại chiếm hơn bảy phần mười toàn bộ lỗi của GPT-5.2, hơn nữa mô hình càng mạnh, tỷ lệ này càng cao.
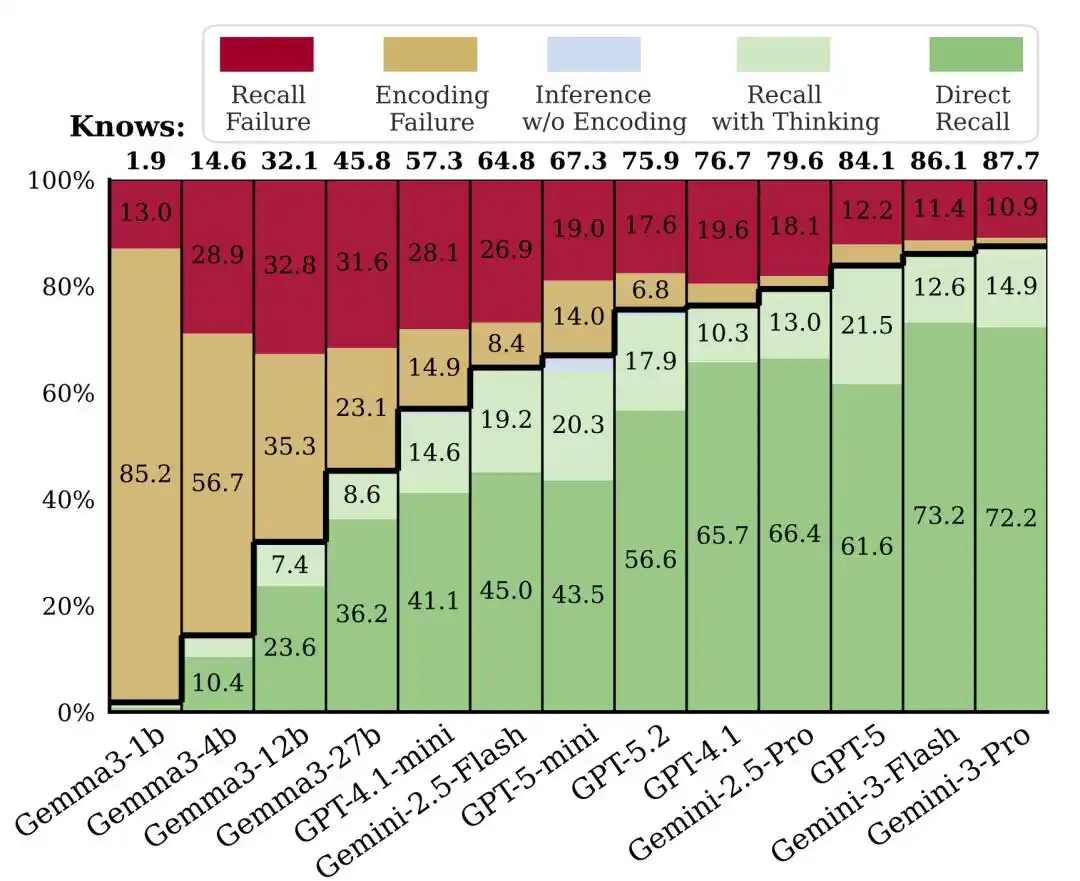
Phân bố năm trạng thái của 13 mô hình, tham số càng lớn mã hóa thất bại liên tục co rút, nhớ lại thất bại gần như không động đậy.
Quy mô cải thiện là lưu được bao nhiêu, không phải là lấy ra được bao nhiêu.
Điều này không phán tử hình scaling, mà là vạch cho nó một đường ranh giới.
Khi tỷ lệ lưu vào đã chạm trần 95%–98%, việc tiếp tục thêm tham số, thêm dữ liệu, có thể đổi lại mức tăng độ chính xác đang thấy rõ ràng nhỏ đi.
Đoạn tăng lợi tiếp theo nhiều khả năng hơn đến từ phương pháp trong hậu huấn luyện và suy luận, tức là làm sao dùng tốt kiến thức đã lưu vào.
Tăng cường truy xuất tất nhiên có thể bù vị trí.
Nhưng tác giả cũng nhắc nhở: kiến thức trong tham số vẫn liên quan đến độ trôi chảy, tốc độ phản hồi và tích hợp xuyên ngữ cảnh, rất khó bị truy xuất bên ngoài thay thế hoàn toàn.
Nó phải biết trước mình không nhớ ra
Vậy, khi nào nên để mô hình suy nghĩ thêm một lúc?
Luận văn định nghĩa vấn đề này thành nhận thức siêu hình (metacognition), tức là sự phán đoán của mô hình về trạng thái của chính mình: nó phải nhận thức được "tôi trực tiếp trả lời không ra" trước, mới biết câu hỏi này đáng để bật thinking suy nghĩ thêm một lúc.
Hai năm qua, câu trả lời mặc định để mô hình đáng tin cậy hơn là cho ăn thêm dữ liệu, chất thêm tham số lớn hơn.
Nghiên cứu này đã nói rõ: ở cấp độ dữ kiện, hàng hóa của mô hình tiên phong đã lên kệ khá đầy đủ rồi. Tiếp theo thử thách, là nó có thể tự mình lấy hàng hóa ra hay không.
Phức tạp hơn là bước tiếp theo: nó phải biết trước, mình không nhớ ra.
Tài liệu tham khảo:
https://research.google/blog/empty-shelves-or-lost-keys-recall-is-the-bottleneck-for-parametric-factuality/
https://aihot.virxact.com/items/cmsqe6mat01bsroli3hw71nz7
Bài viết này đến từ tài khoản công chúng WeChat "Tân Trí Nguyên", tác giả: ASI Khải Thị Lục