Итак, последняя сложнейшая задача FrontierMath Tier 4 была покорена GPT-6 Astra.
С этого момента весь этот исследовательский тест, когда-то считавшийся кошмаром больших языковых моделей в математике, был хотя бы раз успешно пройден искусственным интеллектом.
Epoch AI официально подвела итог: FrontierMath Tier 4 насыщен.
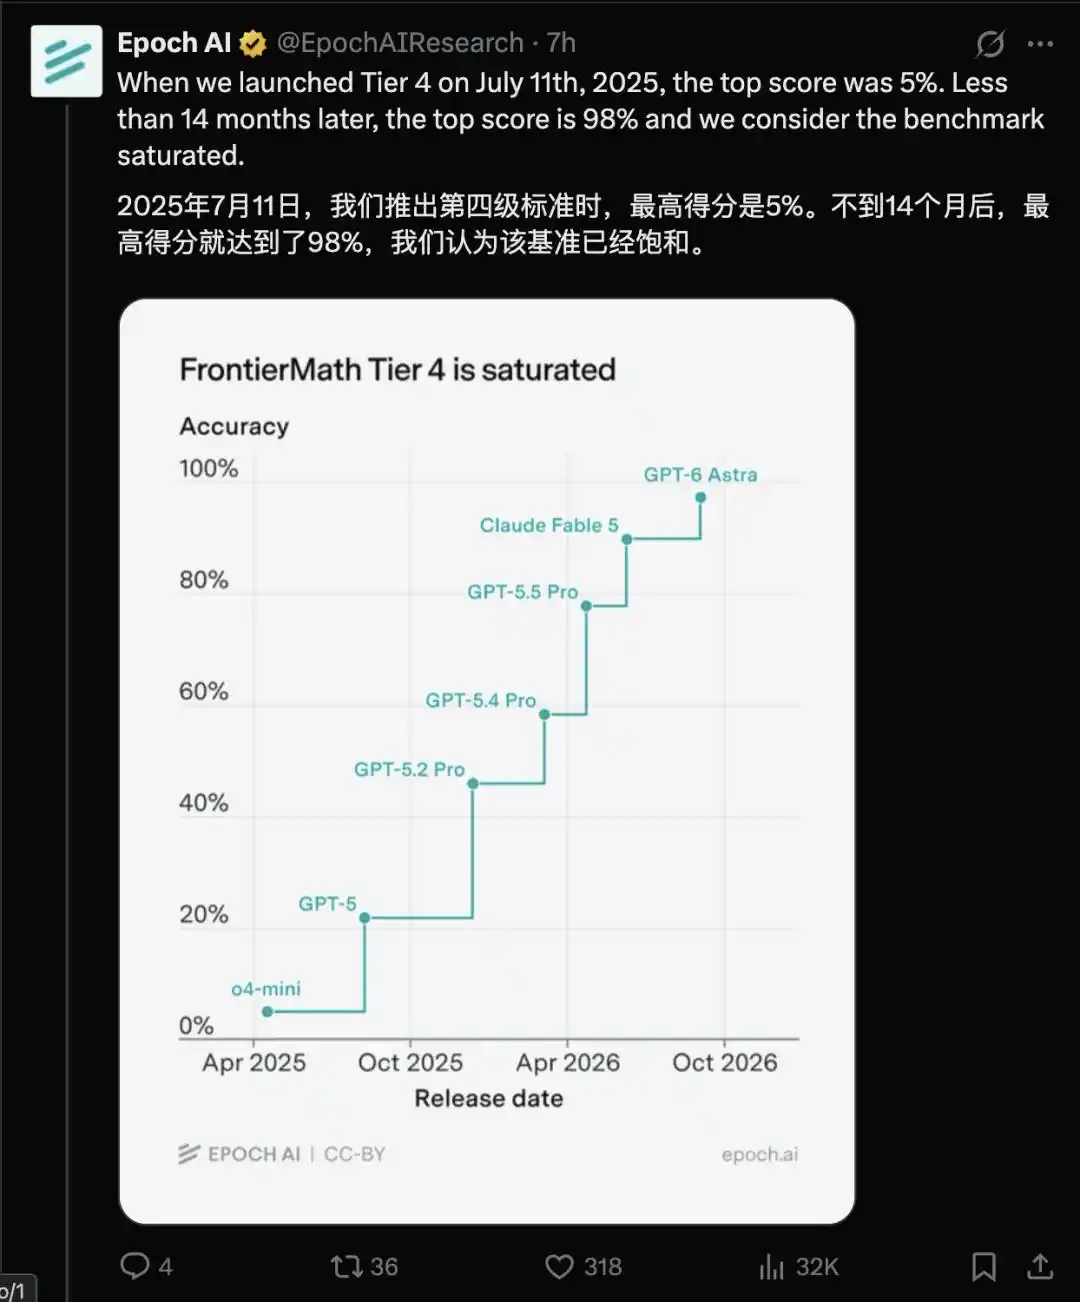
Хотя на графике выше видно, что Astra ещё не достигла 100%, а официально опубликованный OpenAI результат составляет 97,6%.
Согласно методологии Epoch, «полностью решены» означает, что с учётом всех попыток различных моделей в разное время, каждая задача в Tier 4 была хотя бы раз успешно решена.
И Astra решила именно ту, единственную, которую до сих пор не мог взять ИИ.
(Простыми словами: возможно, Astra где-то в тестах ошиблась, но та задача, которую она решила, до этого не была никем решена)
Признаем, скорость развития всё равно ошеломляет.
Если вы следите за оценкой моделей, то знаете, что 11 июля 2025 года, когда Tier 4 только появился, лучший результат на доске составлял около 5%.
Сейчас, чуть больше чем через год и два месяца, этот бывший «высокий барьер» превратился в «ступеньку». Последняя задача, которую ИИ не мог обойти обходными путями, была преодолена.
Автор задач, Джей Пантоун, доцент математики в Университете Маркетта, также отметил, что раньше ИИ искал числовые лазейки, а на этот раз подход ИИ был очень близок к его собственному.
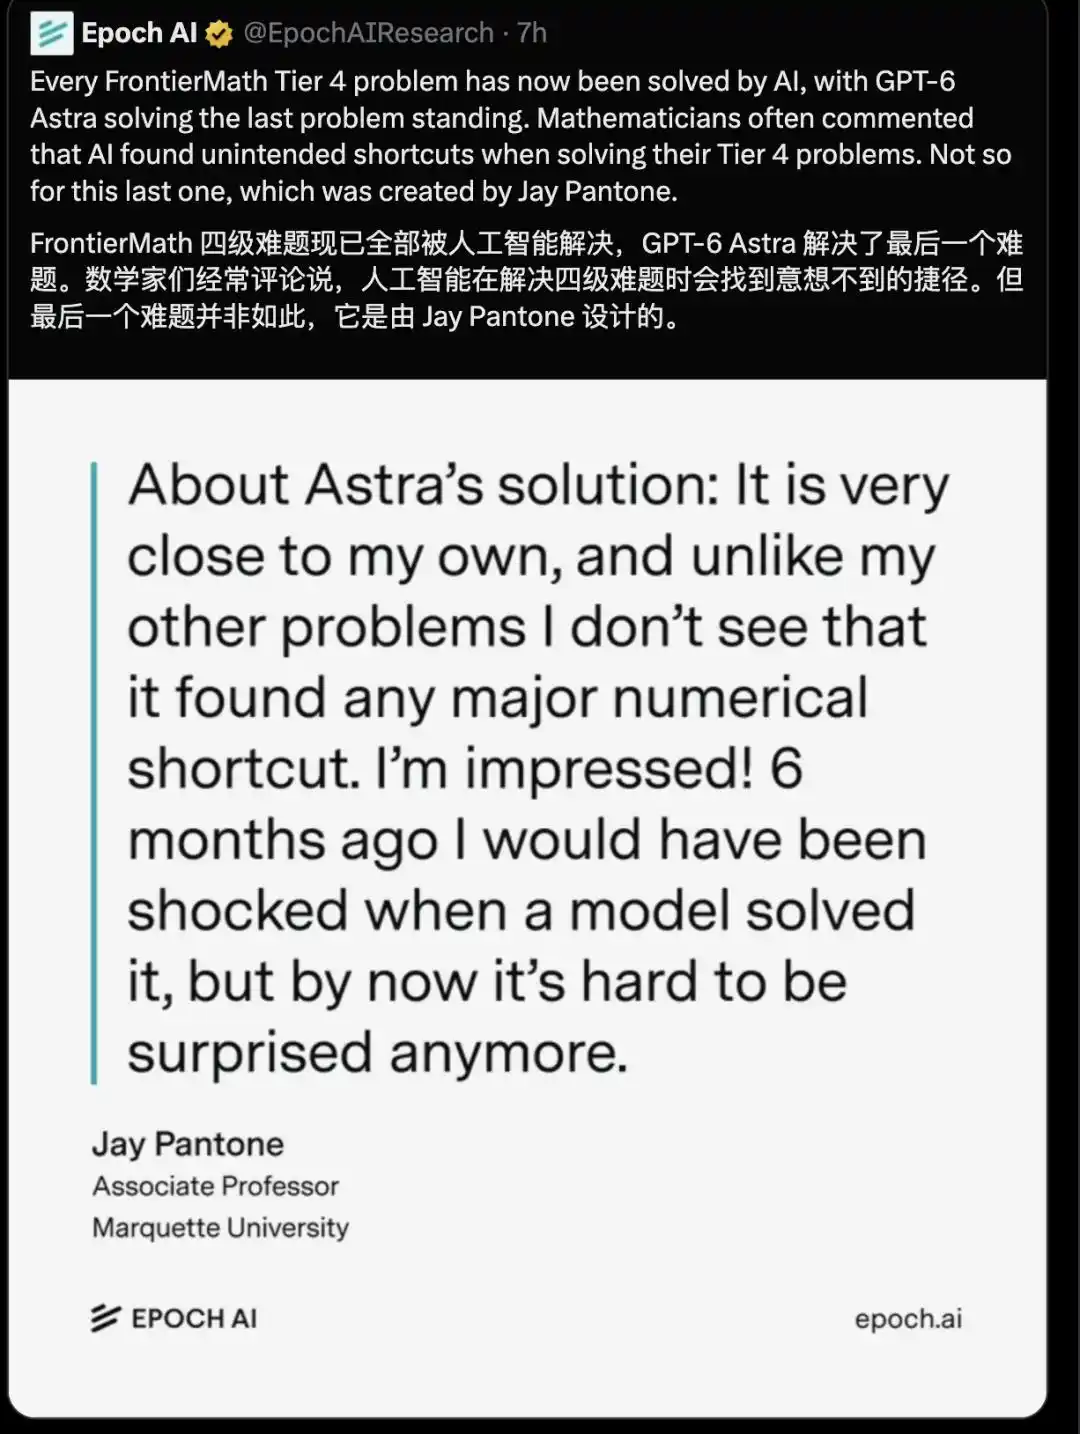
Однако, пока GPT-6 Astra в последнее время яростно атакует математическое сообщество, решая задачи тысячелетия чуть ли не каждый день, Пантоун заявил, что ему уже трудно удивляться!
Можно сказать, что математика стала одной из областей, где Astra в последнее время наиболее громко заявляет о себе.
От менее 2% до добавления специального «исследовательского рубежа»
FrontierMath был впервые выпущен 7 ноября 2024 года, и сама цель его создания заключалась в том, чтобы не дать ИИ слишком быстро пройти математические тесты.
В то время традиционные бенчмарки вроде GSM8K и MATH всё хуже справлялись с задачей разделения ведущих моделей, поэтому Epoch AI объединилась с более чем 60 математиками, чтобы разработать набор оригинальных задач, ранее никогда не публиковавшихся.
Среди них были лауреаты Филдсовской премии, такие как Теренс Тао, Тимоти Гауэрс, Ричард Борчердс.
Теренс Тао, ознакомившись с некоторыми исследовательскими задачами, тогда прямо заявил, что они «чрезвычайно трудны», и даже предположил, что самый сложный Tier 3, возможно, сможет сдерживать ИИ ещё несколько лет.
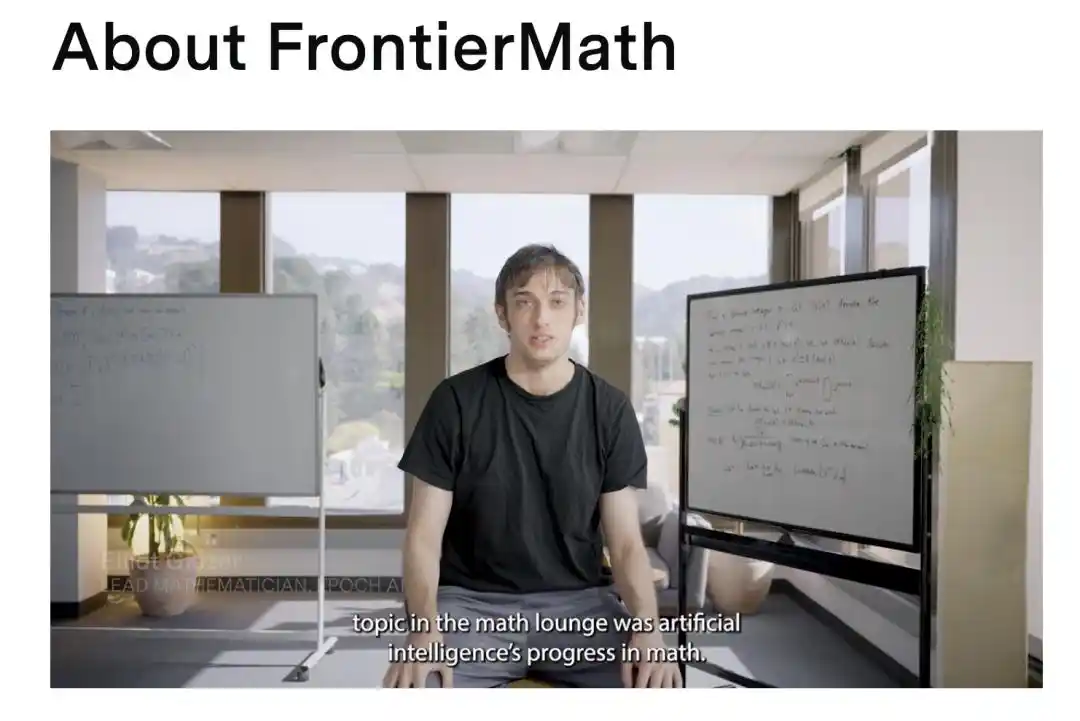
И действительно, первый раунд тестирования показал, что точность ведущих моделей составляет менее 2%.
Изначально основная база FrontierMath содержала 300 задач, разделённых по уровню сложности на Tier 1, Tier 2 и Tier 3.
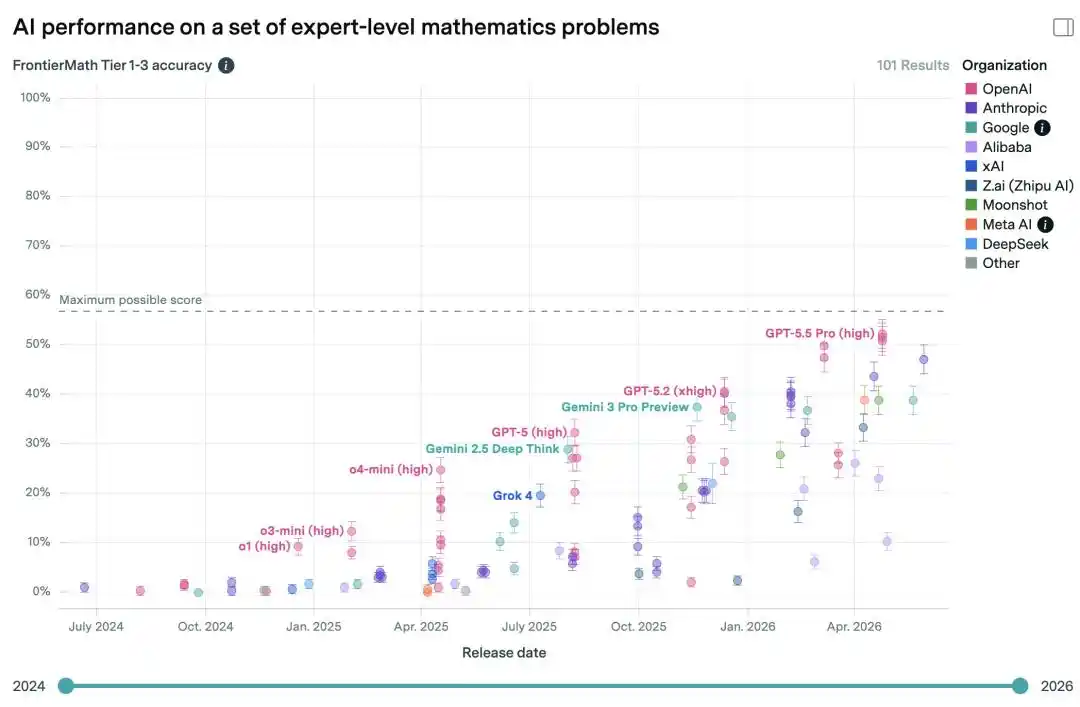
Tier 1 примерно соответствует сложным задачам для бакалавров и математическим олимпиадам, но с разрешением использовать более продвинутые инструменты; Tier 2 уже достигает уровня старшекурсников магистратуры; Tier 3 же близок к исследовательским проблемам, с которыми сталкиваются аспиранты на ранних этапах.
Но с появлением рассуждающих моделей и эти три уровня стали недостаточными, поэтому в 2025 году Epoch добавила ещё один — Tier 4.
Задачи Tier 4 в основном разрабатывались профессорами математики и постдоками. Каждый из них в течение нескольких недель проводил краткосрочное исследование в своей области, а затем сжимал результат в задачу, которую можно автоматически проверить.
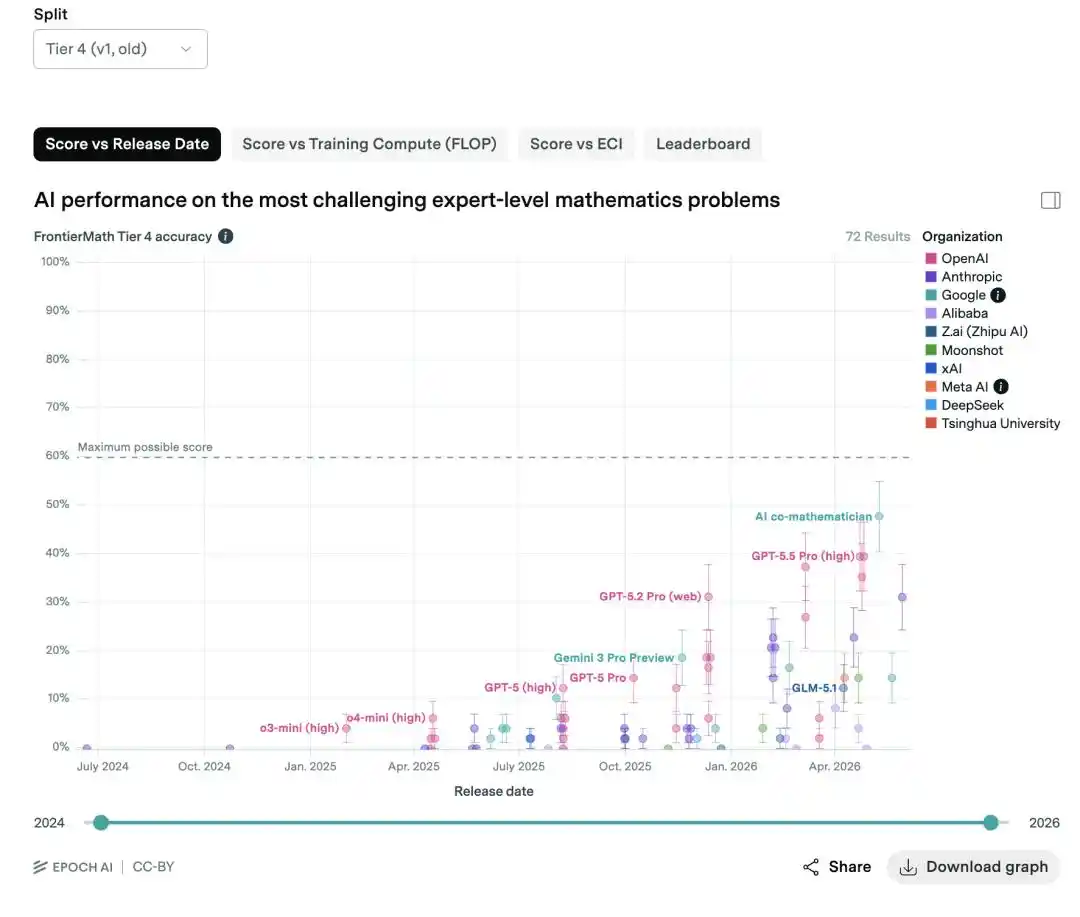
Изначально Tier 4 включал 50 задач. Они охватывали такие области, как анализ, теория чисел, комбинаторика, топология, алгебраическая геометрия...
На момент выпуска все модели в сумме за все попытки решили только 3 задачи, и даже эти решения опирались на верные, но недостаточно обоснованные допущения.
Учитывая это, на странице с примерами задач на официальном сайте Epoch даже было написано: некоторые из этих задач могут не быть решены ИИ в течение десятилетий.
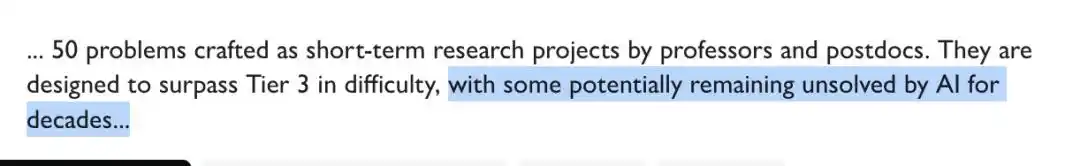
(Эту фразу теперь постоянно вспоминают иронично)
Однако по мере того, как модели становились всё сильнее, проявилась и другая проблема: сама база задач начала не выдерживать «испытания» ИИ.
OpenAI в процессе тестирования обнаружила, что ошибок в FrontierMath больше, чем ожидалось.
Затем Epoch запустила независимый аудит: сначала GPT-5.5 и Claude Opus 4.7 отсеяли спорные моменты, после чего математики проверили каждую задачу. В итоге в июне 2026 года была выпущена версия 2, в которой в Tier 4 исправили 12 задач, удалили 7, оставив 43.
После пересмотра результаты моделей продолжили расти.
GPT-5.6 Sol достигла 83,0%, Claude Fable 5 — 90,2%, а GPT-6 Astra показала результат 97,6%.
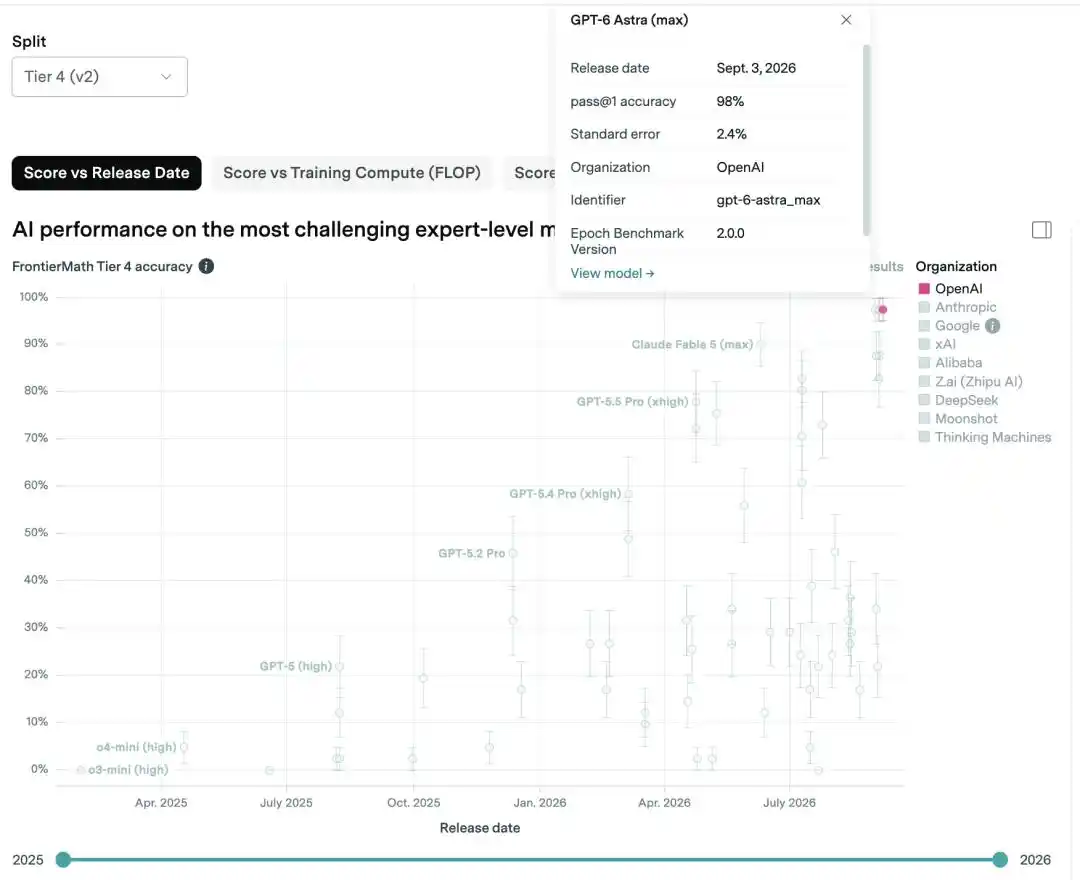
Но что важнее, Astra решила и ту единственную задачу, которую до этого ни разу не решал ИИ.
Таким образом, каждая задача в Tier 4 была хотя бы раз успешно решена ИИ. Этот специально созданный для сильнейших моделей исследовательский рубеж в итоге был пройден.
Однако это не означает, что «математика решена ИИ». Как раз наоборот, FrontierMath уже движется к следующему этапу.
Теперь весь проект, помимо Tiers 1-4, включает в себя настоящие Открытые проблемы (Open Problems), а также FrontierMath Erdős, формализующий открытые проблемы Эрдёша в Lean.
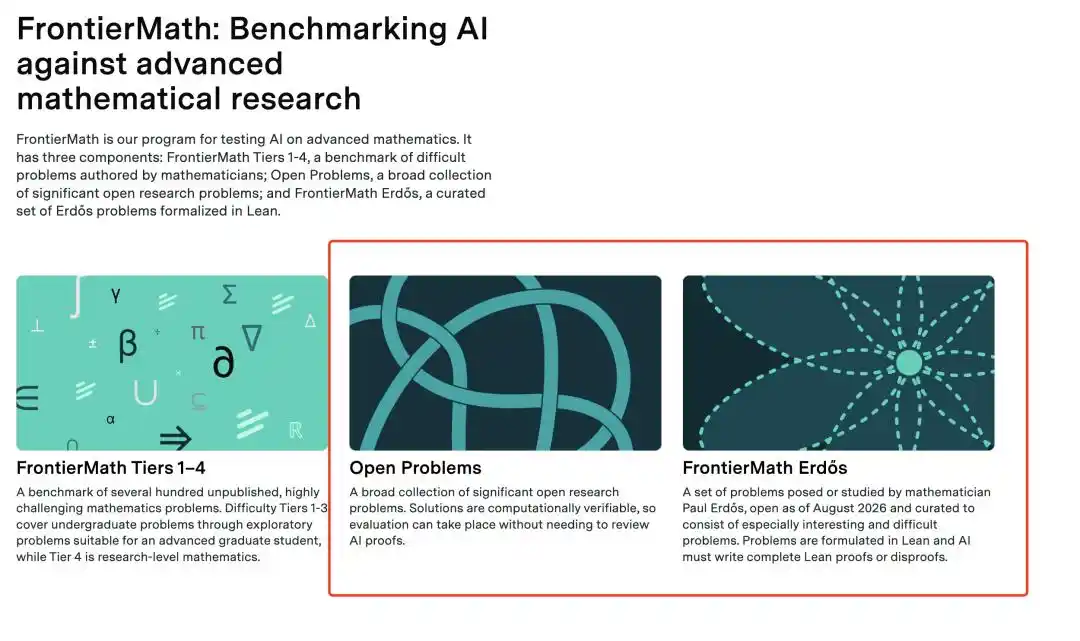
Первые напрямую предлагают моделям ещё не решённые математическим сообществом исследовательские вопросы; вторые требуют от ИИ написания полного доказательства, которое пройдёт формальную проверку.
На этот раз Astra в FrontierMath Erdős из 68 задач решила только 2.
История продолжается~
Статья из официального аккаунта WeChat «量子位», автор: henry