С бенчмарками в последнее время творится что-то неладное.
8 сентября аналитическая фирма SemiAnalysis опубликовала пять твитов, напрямую назвав двух технологических гигантов с триллионной капитализацией — Google и Meta — моделями с наиболее очевидными следами накрутки.
Это модели Gemini 3.8 Flash и Muse Spark 1.3.
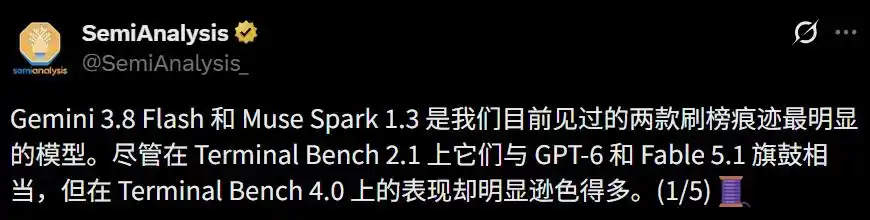
Доказательства очень ясны.
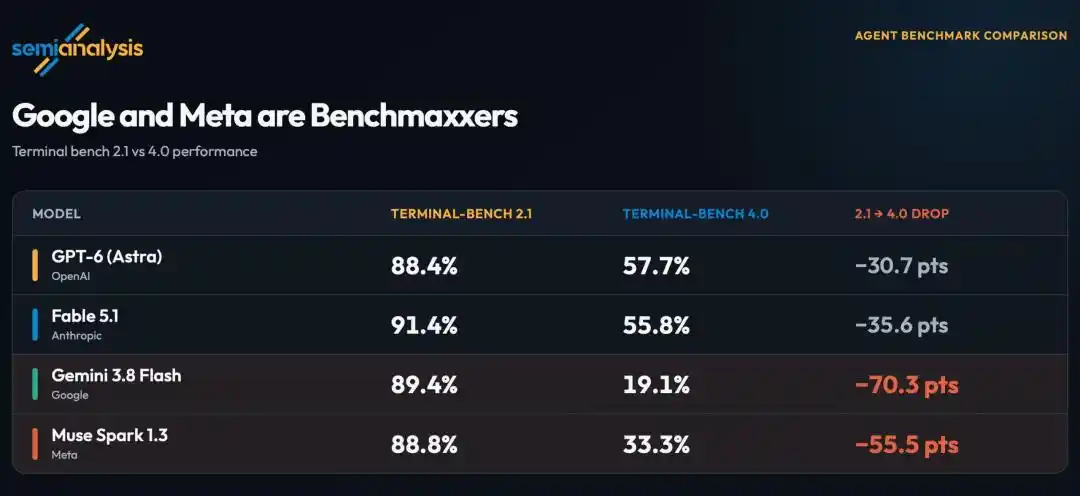
В рейтинге Terminal-Bench 2.1, оценивающем практические способности агентов, Gemini 3.8 Flash набрала 89,4 балла, заняв 2-е место среди 182 моделей, обогнав даже GPT-6 Astra.
Однако в только что запущенной 29 августа версии Terminal-Bench 4.0 та же модель получила всего 19,1 балла, опустившись на 12-е место среди 14 участников, то есть её результат упал в пять раз.
В то же время GPT-6 Astra упал с 88,4 до 57,7 баллов, что всё равно составляет скидку в 35%.
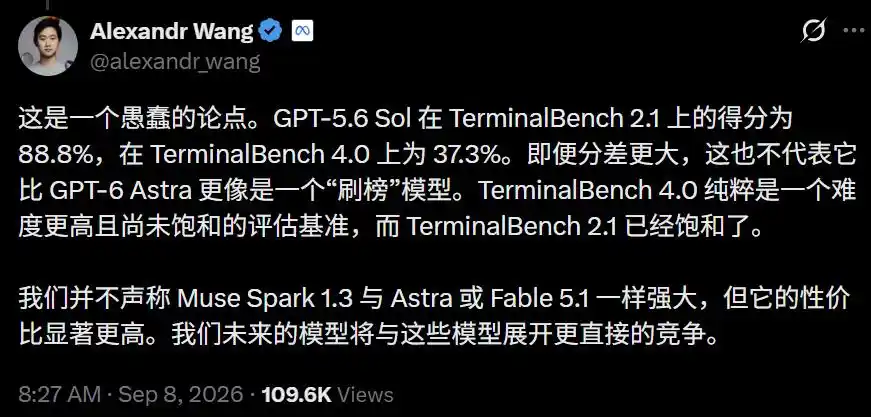
Всего через 27 минут главный AI-директор Meta Александр Ванг лично появился в комментариях, сразу заявив шестью словами: Это глупый аргумент.
Он отметил, что GPT-5.6 Sol набрал 88,8 в версии 2.1 и упал до 37,3 в версии 4.0 — разрыв ещё больше, но никто не говорит, что Sol накручивал рейтинг.
Он также подчеркнул, что Meta никогда не утверждала, что Muse Spark 1.3 так же мощна, как Astra или Fable 5.1, просто её соотношение цены и качества явно выше.
Новый тест — и результат рухнул до минимума
Краткое описание: Terminal-Bench измеряет реальные практические способности агента.
Метод заключается в том, чтобы дать модели терминал и нечёткую цель, а всё остальное она должна сделать сама. Затем система должна самостоятельно планировать путь, использовать инструменты, писать скрипты, а при ошибках — исправлять их.
В версии 2.1, которую индустрия накручивала уже полгода, результаты этих двух моделей действительно были хорошими.
Gemini 3.8 Flash набрала 89,4 балла, заняв 2-е место, Muse Spark 1.3 с 88,8 балла — 4-е место, следом идут GPT-6 Astra с 88,4 балла и Claude Fable 5.1 с 85,02 балла.
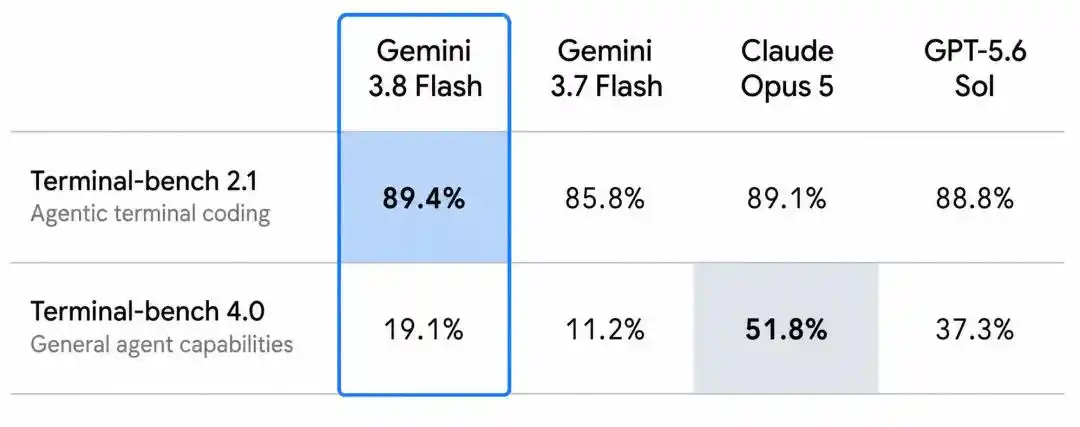
Вот это да: одна недорогая модель уровня Flash, одна новая разработка Meta, ориентированная на ценность, — и обе превзошли флагманские модели двух ведущих лабораторий.
А потом вышла версия 4.0.
Новый тест состоит из 66 задач, из которых не только убрали 8 старых, уже «разгаданных», но и серьёзно изменили 19, а также установили лимит времени в 8 часов.
Механизмы защиты от накрутки также были значительно усилены.
Организаторы не только установили 35 детальных критериев оценки, но и добавили специальный «тест на противостояние читерству», где агенту намеренно позволяли искать лазейки в системе поощрений, и любые задачи, где это удавалось, немедленно исключались.
С появлением нового рейтинга картина резко изменилась.
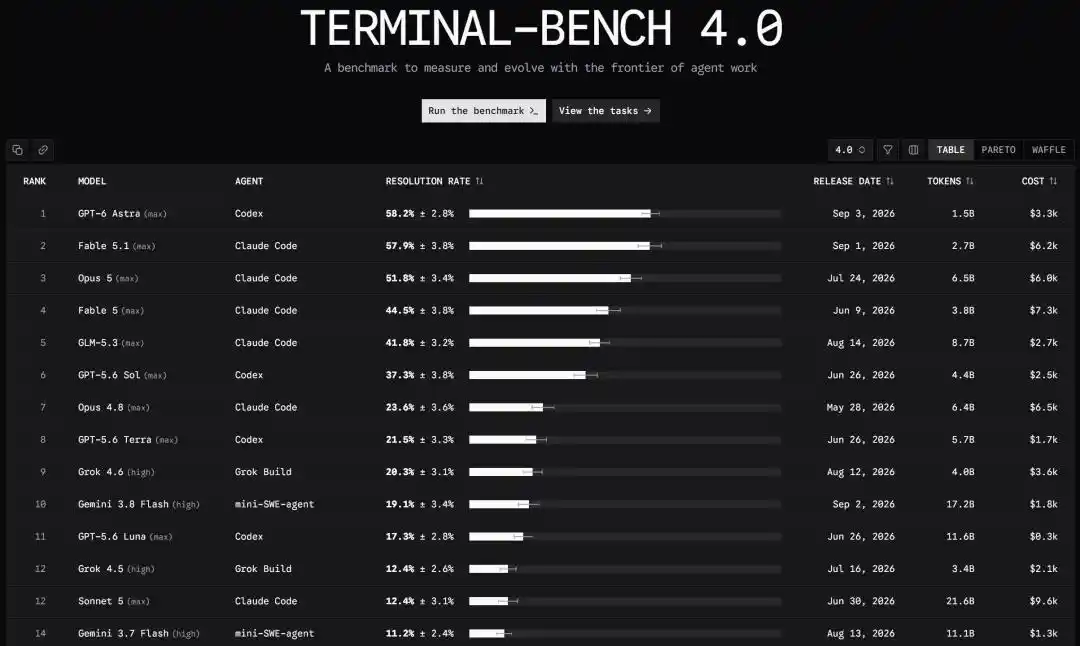
Claude Mythos 5.1(max) набрал 60,9 балла, удержав позиции, за ним следуют GPT-6 Astra и Claude Fable 5.1 с 57,7 и 55,8 балла соответственно, затем идёт Claude Opus 5 с 52,3 балла. Модели предыдущего поколения GPT-5.6 Sol и Terra набрали 37,3 и 23,6 балла.
Для сравнения, Gemini 3.8 Flash резко упала до 19,1 балла. Согласно графику, предоставленному SemiAnalysis, результат Muse Spark 1.3 составил 33,3 балла.
Итог таков.
В старом рейтинге Gemini 3.8 Flash ещё могла обогнать GPT-6 Astra; в новом её результат составляет меньше трети от результата Astra, и она даже отстала от GPT-5.6 Terra предыдущего поколения.
Не нужно списывать ответы, можно купить «секретные тесты»
Споры — это одно, но второе обвинение SemiAnalysis раскрывает настоящую инсайдерскую информацию индустрии.
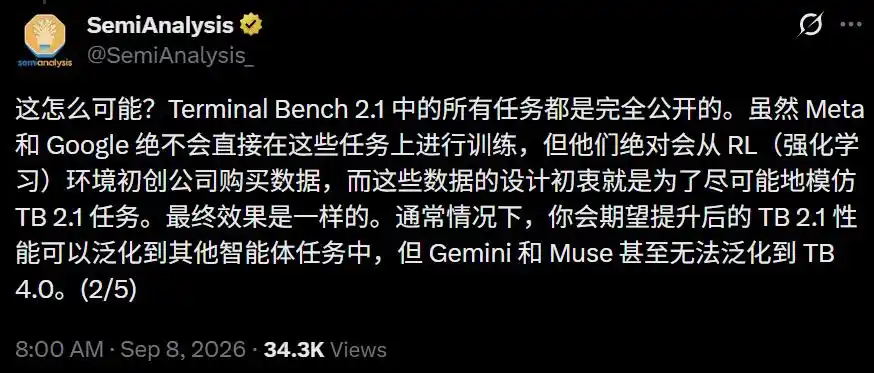
По их мнению, задачи Terminal Bench 2.1 полностью публичны, и Meta с Google, конечно, не станут тупо тренировать на оригинальных вопросах, но они абсолютно точно купят данные — специально те обучающие данные, которые разработаны максимально близко к стилю вопросов TB 2.1. Конечный эффект практически неотличим от читерства.
И это — продвинутая тактика накрутки рейтингов в 2026 году.
Старые методы «загрязнения» данных были грубыми — просто смешивали оригинальные вопросы с предобучающим корпусом, чтобы модель их зазубрила.
Такое легко обнаружить, и после очистки данных результаты показывают истинное положение дел.
Индустрия уже не раз на этом обжигалась: например, почти 40% выборок HumanEval были загрязнены, а GSM8K после очистки терял 13 баллов. Самый яркий случай — SWE-bench: при тестировании на частном репозитории кода результат падал вдвое.
Поэтому теперь крупные компании не трогают оригинальные вопросы, а вместо этого покупают «симуляционные тесты, похожие на экзаменационные». То есть закрытые системы заданий, где модель пробует, ошибается и получает вознаграждение.
Сейчас это уже зрелый бизнес с фиксированными ценами.
Отдельная обучающая задача стоит от 200 до 2000 долларов, сложные задачи по разработке ПО могут доходить до 20 тысяч.
Если нужно клонировать сайт для создания тренировочной среды с UI, это обойдётся примерно в 20 тысяч долларов.
Если требуется воссоздать продукт уровня Slack, то начинается от 30 тысяч долларов.
Для клиентов, требующих эксклюзивных прав, цена может увеличиться в 4–5 раз.
Согласно исследованию Epoch AI, внутри Anthropic обсуждали возможность тратить на это 1 миллиард долларов в год. Контракты на один квартал легко достигают шести- и семизначных сумм, а исследователи сообщают, что средняя цена составляет 300–500 тысяч долларов за квартал.
На стороне предложения этим занимаются как минимум 35 компаний, большинство из которых — стартапы с командой менее 20 человек. Крупные игроки на рынке данных также все перестраиваются: Scale AI до инвестиций Meta имела выручку более 1,4 миллиарда, а годовой доход Surge приближается к 1 миллиарду.
Текущая ситуация сюрреалистична.
С одной стороны — полностью открытые вопросы рейтингов, с другой — зрелая индустрия продажи заданий. Если хочешь, чтобы твоя модель показала высокий результат в определённом рейтинге, не нужно напрямую жульничать — просто заплати и закажи.
И продавец тестов, и экзаменатор
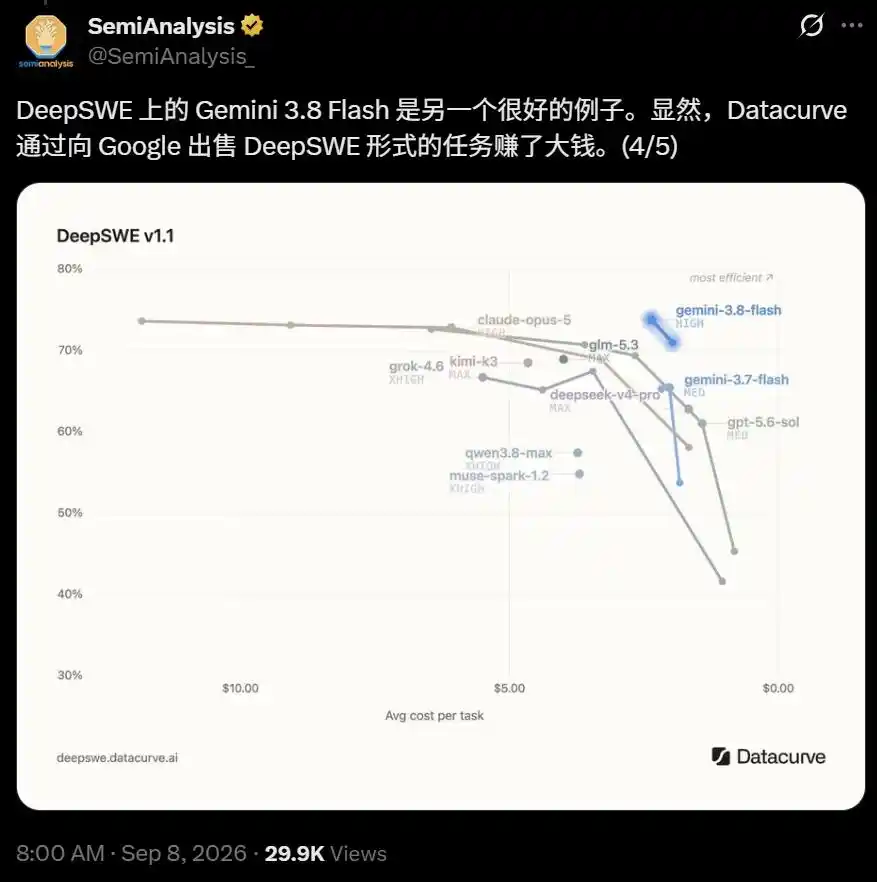
Затем SemiAnalysis прямо назвала компанию под названием Datacurve.
В рейтинге DeepSWE 1.1, специализирующемся на тестировании долгосрочного программирования, Muse Spark 1.3(max) набрала 75,4 балла и заняла первое место, за ней следуют GPT-6 Astra и Claude Opus 5, а Gemini 3.8 Flash с 73,8 балла оказалась на четвёртом месте.
Две модели, обвинённые в накрутке, — одна первая, другая четвёртая.
Наверное, вы уже заметили подвох.
Этот рейтинг ведёт Datacurve, а способ заработка Datacurve как раз заключается в продаже «экспертных данных по программированию и сред для обучения с подкреплением» передовым лабораториям.
DeepSWE — это не только собственный бенчмарк Datacurve, но и для тестирования используется её собственная среда оценки.
Быть одновременно продавцом тренировочных материалов и составителем экзаменационных билетов — это, можно сказать, полностью подтверждено.
Срок годности рейтингов почти истёк
В заключение SemiAnalysis вынесла приговор публичной оценке во всей индустрии.
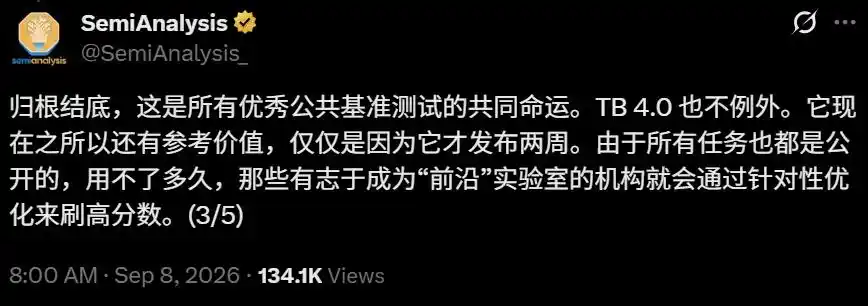
Они считают, что в конечном счёте это судьба всех качественных публичных бенчмарков. TB 4.0 не исключение — сейчас она кажется точной только потому, что вышла две недели назад.
Пока её вопросы остаются публичными, рано или поздно все лаборатории, называющие себя «передовыми», изотрут их до дыр.
Лекарство, которое в итоге предлагает SemiAnalysis, очень прямое — создавать больше качественных частных бенчмарков.
Направление верное, но цена также болезненна.
Как только вся оценка станет приватной, публичные рейтинги окончательно превратятся в маркетинговые релизы компаний.
По-настоящему значимые реальные результаты будут тайно циркулировать только между лабораториями и частными оценочными агентствами.
Крупные компании, конечно, будут только рады, ведь на закрытом экзамене никто не сможет заранее выучить ответы.
Но для широкого круга разработчиков тот самый общий измерительный инструмент, который справедливо оценивал все модели, вероятно, будет утерян навсегда.
Источники:
https://x.com/SemiAnalysis_/status/2097112791471522292
Редактор: Моисей
Эта статья из официального аккаунта WeChat «Новые пророки ИИ», автор: Откровение ASI