Роботы учатся способности, которая когда-то была присуща только людям: запоминать мир, по которому они перемещаются.
Когда человек впервые заходит в незнакомую комнату, он не запоминает всё увиденное кадр за кадром. Мы запоминаем ключевые структуры: где дверь, где стол, где мы только что были и где находимся сейчас.
Именно эта избирательная память позволяет человеку действовать в сложной среде. Для роботов это также ключевая проблема, которую необходимо решить для работы в реальном мире.
В апреле этого года открытая модель потокового 3D-реконструирования LingBot-Map от Ant Lingbo предложила новый технический подход к решению этой фундаментальной задачи — «как роботу запоминать пространство». Без сложного оборудования, используя лишь обычную RGB-камеру, робот может в реальном времени оценивать позу камеры и реконструировать трёхмерную структуру сцены в процессе съёмки видео, тем самым заполнив ключевой технологический пробел в области пространственного восприятия в реальном времени.
При пересечении нескольких комнат в длинной последовательности, в условиях резких изменений среды и значительных смен угла обзора, LingBot-Map демонстрирует исключительную устойчивость.
На данный момент официальный проект LingBot-Map на GitHub собрал 16.9K звёзд и 1.9K форков, неоднократно попадал в тренды GitHub и стал одним из наиболее обсуждаемых open-source проектов в области 3D-компьютерного зрения.
- Адрес проекта: https://github.com/Robbyant/lingbot-map
- Адрес статьи: https://arxiv.org/pdf/2604.14141
- Страница статьи: https://technology.robbyant.com/lingbot-map
- Ссылка на Hugging Face: https://huggingface.co/robbyant/lingbot-map
- Ссылка на ModelScope: https://www.modelscope.cn/models/Robbyant/lingbot-map
Приятным сюрпризом стало новое признание этого исследования.
Его статья «Geometric Context Transformer for Streaming 3D Reconstruction» была принята для устного доклада (Oral) на ECCV 2026 и будет представлена в рамках конференции. Во время вчерашней церемонии открытия ECCV редакторы Machine Heart заметили эту работу в списке кандидатов на награды.
От высокого внимания сообщества GitHub до признания на ведущей конференции по компьютерному зрению — LingBot-Map прошла двойную валидацию: как в экосистеме разработчиков, так и в академическом сообществе.
Что ещё важнее, это отражает смену парадигмы: конкуренция в области пространственного восприятия роботов смещается с «видеть мир» на «запоминать мир».
До признания на топ-конференции LingBot-Map уже прошла проверку open-source сообществом
До получения статуса Oral на ECCV, LingBot-Map уже привлекла значительное внимание open-source сообщества, и разработчики начали различные доработки вокруг этого проекта.
Кто-то быстро выполнил воспроизведение и проверку, кто-то попытался запустить его на различном аппаратном обеспечении, а другие разработчики начали исследовать новые способы сбора пространственных данных.
Подходы каждого интересны по-своему, и такая активная исследовательская деятельность сообщества часто лучше демонстрирует жизнеспособность проекта, чем просто количество звёзд.
Сделать быстрый опыт доступным для большего числа людей: от развёртывания до визуализации
Для многих исследовательских проектов публикация статьи не означает, что обычные разработчики смогут ими пользоваться. Настройка окружения, установка зависимостей, отображение результатов — эти этапы часто создают разрыв между демонстрацией в статье и реальным использованием.
Вскоре после открытия исходного кода LingBot-Map разработчики создали нативный десктопный интерфейс и просмотрщик 3D-облаков точек для локального запуска на Apple Silicon Mac, позволяя пользователям более интуитивно просматривать результаты пространственной реконструкции, генерируемые моделью.
Источник: https://github.com/donalleniii/lingbot-desktop-mac
В то же время, другие разработчики создали решение для запуска в один клик на основе Pinokio, ещё больше автоматизировав процесс настройки окружения, установки зависимостей и запуска демо, чтобы пользователи без опыта сложной настройки также могли быстро опробовать LingBot-Map.
Источник: https://github.com/cocktailpeanut/lingbot-map.pinokio
Эти попытки закрыли важный пробел между результатами исследования и опытом разработки, позволив большему числу пользователей действительно прикоснуться к этой модели потоковой 3D-реконструкции и использовать её.
Запуск на большем количестве устройств: адаптация для потребительского железа
Помимо оптимизации процесса использования, разработчики также начали расширять спектр аппаратного обеспечения, на котором может работать LingBot-Map.
Разработчик ureeey попробовал адаптировать проект под устройства с видеокартой RTX 4060 и 8 ГБ видеопамяти, оптимизировав стратегию выполнения для снижения нагрузки на память, что позволило запускать LingBot-Map в более лёгких GPU-средах.
Источник: https://github.com/ureeey/lingbot-map-rtx4060-8g/blob/main/README.md?utm_source=chatgpt.com
Значение таких попыток заключается в следующем: когда модель перестаёт быть ограниченной высокопроизводительными рабочими станциями и может работать в более обычных средах разработки, у технологии появляется шанс быть протестированной, изменённой и применённой большим числом людей.
От камеры до умных очков: исследование новых точек входа для сбора данных
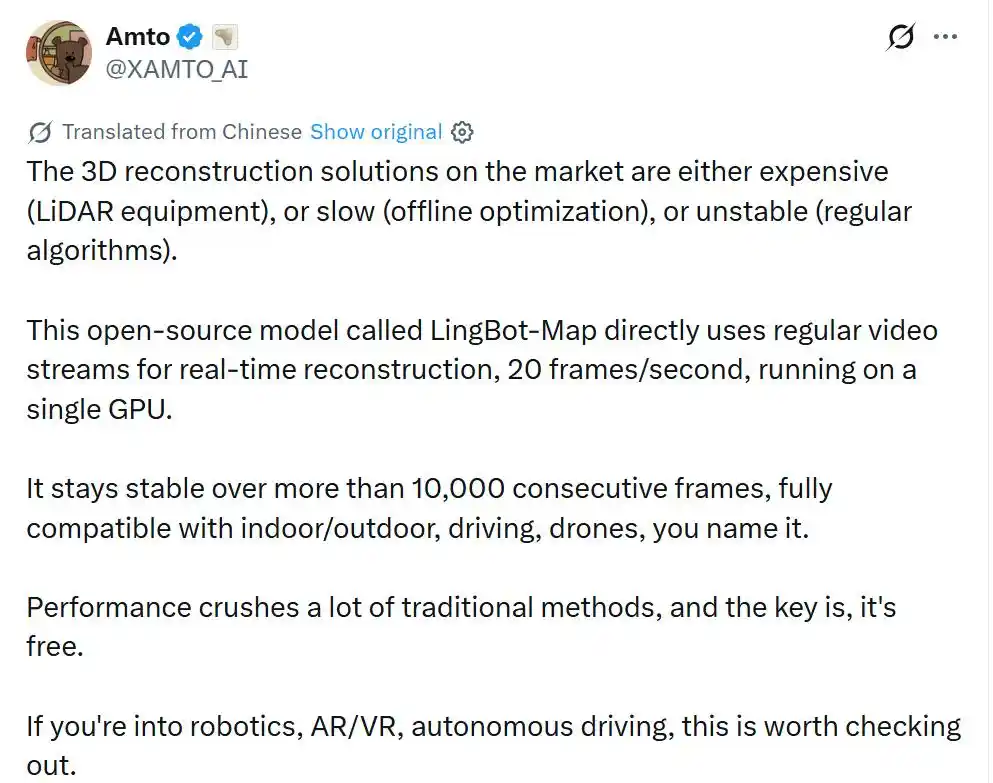
На платформе X некоторые разработчики отметили, что ранее задачи высокоточного 3D-сканирования часто зависели от специализированных LiDAR-устройств или требовали сложных офлайн-оптимизационных процессов, а традиционные методы также сталкивались с проблемами стабильности при длительном непрерывном вводе.
В отличие от них, LingBot-Map реализует потоковую реконструкцию в реальном времени с использованием обычного видеопотока, работает на одном GPU со скоростью около 20 кадров/с и способна обрабатывать длинные последовательности ввода свыше 10 000 кадров.
Источник: https://x.com/XAMTO_AI/status/2080900857235726635
По мнению этих разработчиков, LingBot-Map демонстрирует более лёгкий путь к пространственному восприятию: снижение зависимости от специализированного оборудования и сложных процессов, что открывает возможность для использования возможностей реальной 3D-реконструкции в таких сценариях, как робототехника, AR/VR, автономное вождение и других.
Основываясь на этом, некоторые действительно пошли дальше и подключили LingBot-Map к потребительским устройствам.
Один пользователь превратил умные очки Ray-Ban Meta Gen-2 (без LiDAR) в устройство для 3D-сканирования, собирая данные через мобильное приложение и вызывая развёрнутый на RunPod бэкенд LingBot-Map, завершая 3D-картографирование пространства примерно за 30 секунд. Даже при использовании небольшого количества видеокадров, для помещений достигался хороший результат реконструкции.
Источник: https://x.com/0x6rss/status/2079597540568137866
Помимо умных очков, другой пользователь запустил LingBot-Map на обычном настольном компьютере Dell, просто сняв видео своего рабочего стола, и примерно через 61,5 секунды получил интерактивную 3D-модель в виде облака точек.
Источник: https://x.com/shavonnewong_/status/2080130333094101360
И это лишь часть исследований сообщества после открытия кода LingBot-Map. Для исследовательского проекта в области 3D-зрения такая постоянная активность по доработке не является обычным явлением, что говорит о том, что LingBot-Map начинает входить в реальные сценарии использования.
После открытия кода команда продолжает обновлять скрипты для оценки, оптимизировать вывод, добавлять примеры использования и исправлять проблемы, повышая удобство и стабильность проекта. Кроме того, официальная команда продемонстрировала результаты реконструкции сверхдлинного видео: для примерно 25 000 кадров, видео продолжительностью 13 минут с перемещением по помещению, LingBot-Map сохранила способность к непрерывной реконструкции, генерируя полное трёхмерное представление пространства.
Разумеется, популярность в сообществе — это лишь одна сторона медали. Для результата исследования долгосрочное влияние по-прежнему определяется тем, решает ли оно ключевые проблемы в своей области.
Что стоит за статусом Oral на ECCV: как LingBot-Map переосмысливает пространственную память роботов?
Итак, какую же проблему решает LingBot-Map? Почему модель потоковой 3D-реконструкции привлекает постоянное внимание разработчиков для расширения и получает признание в виде статуса Oral на ECCV?
Ответ нужно искать в ключевой проблеме пространственного восприятия роботов: как роботу, при постоянно растущем потоке видео, сохранять долгосрочную память о пространстве, избегая при этом бесконечного роста вычислительных и ресурсных затрат со временем.
Для робота 3D-реконструкция требует понимания окружающей среды по мере движения. Робот видит текущий кадр и должен одновременно ответить на вопросы: где находится увиденное сейчас? Каково соотношение между ранее пройденными областями и текущим кадром?
Это означает, что модель должна непрерывно оценивать траекторию камеры и генерировать соответствующую информацию о глубине, в итоге формируя постоянно расширяющуюся трёхмерную карту.
По сравнению с офлайн-реконструкцией, потоковая реконструкция сталкивается с фундаментальным противоречием: сохранение большей исторической информации улучшает пространственную согласованность; но чем длиннее история, тем быстрее растут вычислительные затраты и затраты на хранение.
Существующие методы в основном следуют трем подходам.
Один метод похож на запоминание всей истории. Например, подходы на основе causal attention кэшируют информацию всех предыдущих кадров. Таким образом, модель обладает полным контекстом, но с ростом последовательности также растут требования к памяти и вычислениям.
Другой метод выбирает сжатие исторических состояний, например, с помощью рекуррентных сетевых архитектур. Но чрезмерное сжатие может привести к тому, что модель забудет ключевую геометрическую информацию, и после длительной работы возникнет дрейф траектории.
Некоторые методы сочетаются с традиционным SLAM, поддерживая стабильность за счёт выбора ключевых кадров и алгоритмов оптимизации. Но такие методы зависят от заданных вручную правил и требуют дополнительных процессов оптимизации, что затрудняет достижение реального времени.
Таким образом, по-настоящему сложная проблема заключается в следующем: с каким постоянно растущим видеопотоком сталкивается робот, какую пространственную информацию необходимо сохранить, а какую можно отбросить?
LingBot-Map называет эту проблему управлением контекстом (context management) в потоковой реконструкции. Он стремится заставить модель, подобно человеческой пространственной памяти, сохранять только самые важные геометрические ключи, а не записывать все наблюдения.
GCA: разделение пространственной памяти на три уровня, чтобы модель знала, что запоминать
Для решения этой проблемы LingBot-Map предлагает Geometric Context Attention (GCA, геометрическое контекстное внимание).
Его основная идея заимствована из традиционного SLAM: стабильная пространственная система обычно требует трёх типов информации: фиксированную точку отсчёта для определения координат; информацию о ближайшей области для определения текущего местоположения; долгосрочную историю для избежания накопленного дрейфа. Поэтому GCA разделяет потоковое состояние на три части.
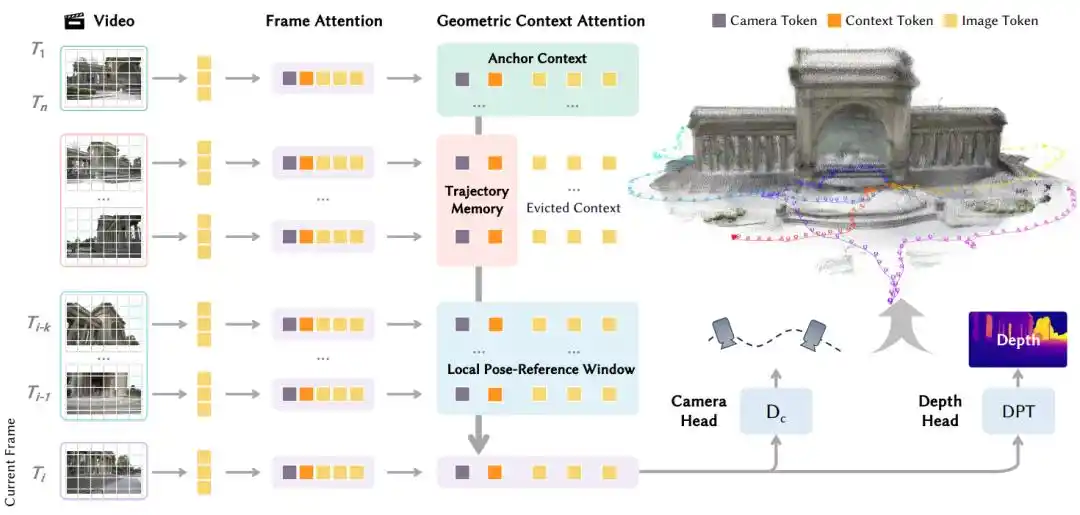
Поток работы LingBot-Map. Эта структура обрабатывает текущий вид относительно инициализированного множества [T, T). Бэкбон DINO извлекает признаки изображения, которые затем уточняются через чередующиеся слои внимания между кадрами и слои GCA. В модуле GCA входной вид агрегирует информацию из контекста привязки (anchor), локального окна поз-ссылки [T, T] и контекста памяти траектории. Наконец, специализированные головы предсказывают позу камеры и карту глубины, достигая устойчивой, эффективной по памяти потоковой 3D-реконструкции длинных последовательностей.
Первый уровень: Контекст привязки (Anchor Context), установление пространственных координат. Отвечает за запоминание «откуда я начал». Он предоставляет стабильный базис для всей трёхмерной системы координат. Пространственная реконструкция больше всего боится дрейфа координат; имея привязку, модель при обработке десятитысячного кадра по-прежнему чётко знает, где произошёл первый кадр.
Второй уровень: Локальное окно поз-ссылки (Local Pose-Reference Window), поддержание точного позиционирования в локальной области. Отвечает за захват локальных геометрических деталей вблизи текущего местоположения. Это эквивалентно поддержанию ясного непосредственного восприятия «что вокруг меня», обеспечивая точность реконструкции кадр за кадром.
Третий уровень: Память траектории (Trajectory Memory), сжатие долгосрочной истории для избежания дрейфа. Это ключевой элемент во всей архитектуре. Он сжимает огромный объём исторической информации в чрезвычайно компактные токены для каждого кадра, сохраняя «впечатление» о пройденном пути с низкими затратами на хранение. Именно этот механизм позволяет потреблению памяти LingBot-Map почти не расти с увеличением длины видео, обработка 100 кадров и 10 000 кадров требует практически одинаковых вычислительных затрат и объёма памяти.
Эффективность от такого подхода весьма значительна. В последовательности из 10 000 кадров традиционному causal attention требуется около 5 миллионов токенов; GCA требуется всего около 70 тысяч токенов, сжимая почти в 80 раз, и при обработке каждого нового кадра вычислительные затраты и потребление памяти почти не растут с общим числом кадров.
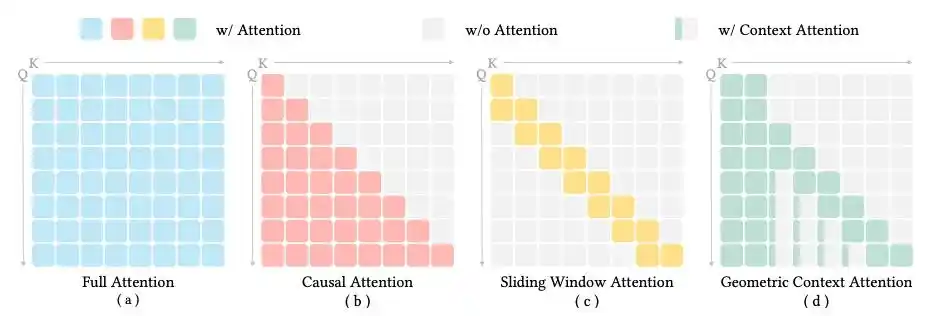
Сравнение масок внимания. Каждый прямоугольник представляет токены одного кадра, состоящие из небольшого отрезка контекстных токенов и большего отрезка токенов изображения. (a) Полное внимание (Full attention) учитывает все кадры. (b) Каузальное внимание (Causal attention) поддерживает потоковую обработку, но вычислительные затраты растут линейно с длиной последовательности. (c) Скользящее оконное внимание (Sliding-window attention) ограничивает вычислительные затраты, но теряет долгосрочный контекст. (d) GCA делит потоковый контекст на привязку (n=2), локальное окно (k=2) и память траектории, сохраняя богатый долгосрочный контекст при почти постоянных вычислительных затратах с ростом длины последовательности.
Как она показывает себя на бенчмарках?
Эксперименты также подтверждают эффективность LingBot-Map.
Команда сначала протестировала модель на наборе данных Oxford Spires, проверяя способности модели к локальному позиционированию на коротких дистанциях и долгосрочную стабильность в двух разных режимах.
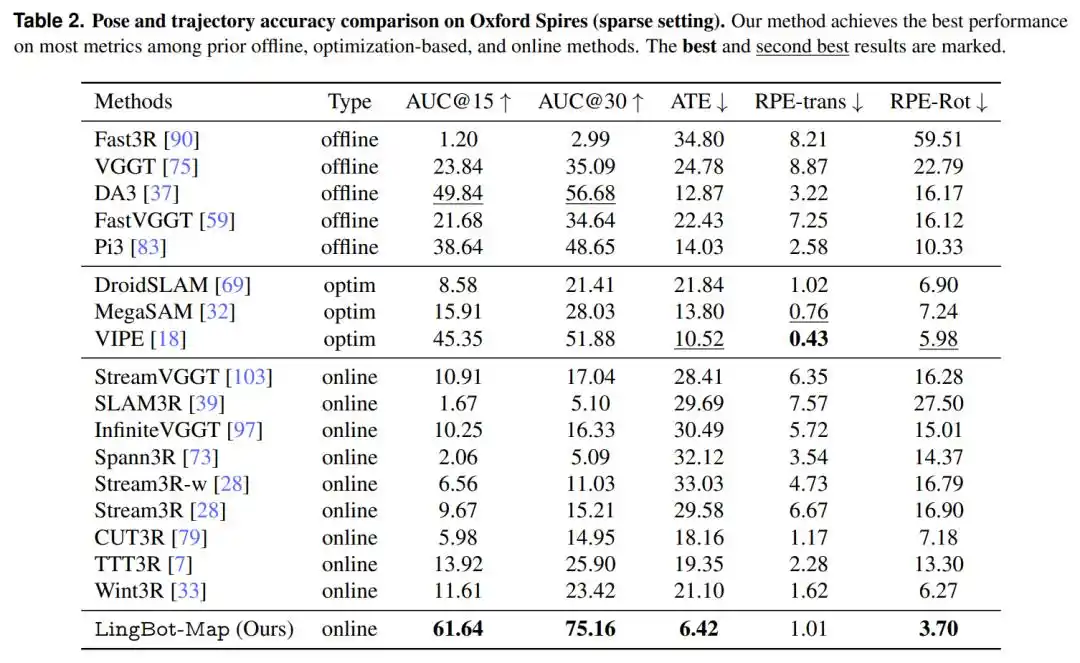
В разреженном режиме (sparse setting) команда выбрала 320 изображений (сэмплирование через каждые 12 кадров) для тестирования, и LingBot-Map показал наилучшие результаты почти по всем метрикам.
Несмотря на то, что LingBot-Map использует потоковый онлайн-вывод, её производительность значительно превосходит самую сильную офлайн-базовую модель. Конкретно, AUC@15 у LingBot-Map составил 61.64, что заметно выше, чем у лучшей офлайн-модели DA3 (49.84), и более чем вдвое превышает показатель VGGT (23.84). По метрике точности на уровне траектории (ATE) LingBot-Map снизила ошибку с 12.87 метров у DA3 и 24.78 метров у VGGT до 6.42 метров.
По сравнению с традиционными оптимизационными методами, зависящими от ошибки репроекции между кадрами, LingBot-Map также продемонстрировала превосходные результаты. Она превзошла лучший оптимизационный метод VIPE по точности позы (AUC@15: 61.64 против 45.35) и согласованности траектории (ATE: 6.42 против 10.52).
При сравнении между самими методами потоковой обработки в реальном времени преимущество становится ещё более очевидным. Другие потоковые методы обычно страдают от серьёзной проблемы забывания: по мере роста последовательности модель постепенно теряет геометрическую информацию, наблюдаемую ранее, что в итоге приводит к накопленному дрейфу. LingBot-Map достигла показателей 61.64 и 6.42 соответственно, повысив точность позы примерно в 10 раз и снизив ошибку траектории примерно в 2.8 раза.
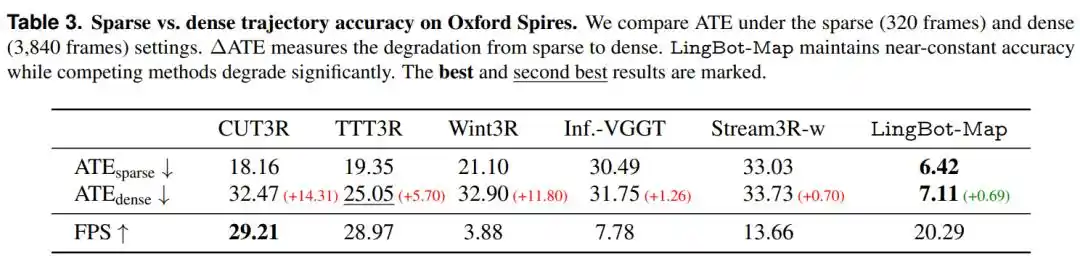
В плотном режиме (dense setting, полные 3840 кадров) команда провела стресс-тест способности модели к потоковой реконструкции длинных последовательностей. По мере увеличения длины траектории с 320 до 3840 кадров большинство методов прямого распространения (feedforward) демонстрируют значительное падение производительности из-за проблемы накопленного дрейфа.
В отличие от них, LingBot-Map сохраняет низкий уровень ошибки, ATE увеличился лишь с 6.42 до 7.11. При увеличении длины последовательности в 12 раз ошибка выросла всего на 0.69.
Это показывает, что трёхуровневая контекстная структура GCA — включая контекст привязки (anchor context), память траектории (trajectory memory) и локальное окно (local window) — способна эффективно поддерживать геометрическую согласованность на больших расстояниях без явной оптимизации или детектирования петель (loop closure).
Примечательно, что LingBot-Map, сохраняя наивысшую точность траектории, также достигает конкурентоспособной скорости вывода, составляющей 20.29 кадров/с, демонстрируя наилучшие результаты оценки траектории среди всех потоковых методов.
В отношении генерации высококачественных трёхмерных карт команда протестировала реконструкцию облаков точек на трёх наборах данных: ETH3D, 7-Scenes и NRGBD. LingBot-Map получила наивысший F1-скор во всех случаях.
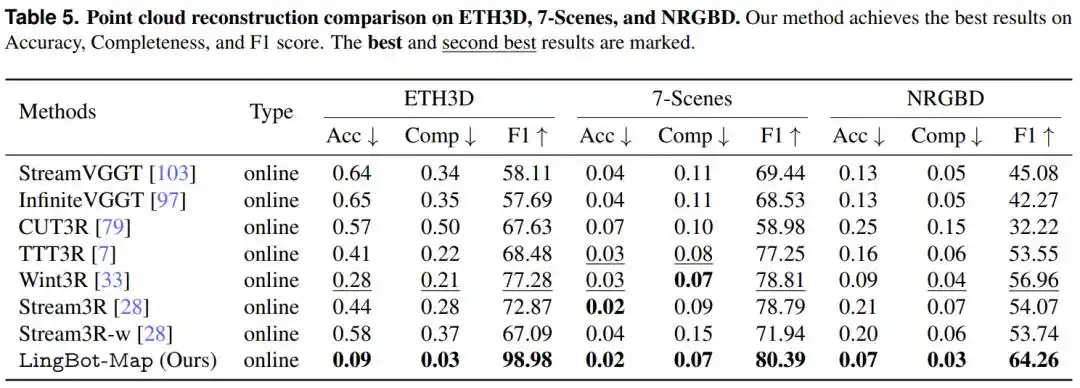
На наборе данных ETH3D F1-скор LingBot-Map составил 98.98, что на 21.70 процентных пункта выше, чем у занявшего второе место Wint3R (77.28). Это показывает, что результаты реконструкции, генерируемые LingBot-Map, не только более точны, но и покрывают более полную структуру сцены.
На наборе данных 7-Scenes F1-скор LingBot-Map составил 80.39, а по метрикам Accuracy (0.02) и Completeness (0.07) также были достигнуты наилучшие показатели.
На наборе данных NRGBD преимущество LingBot-Map стало ещё более очевидным: её F1-скор составил 64.26. NRGBD содержит большое количество сложных внутренних сред и детализированных геометрических структур. В таких сценах другие методы, из-за накопленного дрейфа позы, часто приводят к размытию поверхностей или повторению структур в результатах реконструкции. А LingBot-Map, обладающая более сильной устойчивостью к дрейфу в оценке траектории, напрямую повышает качество реконструкции в подобных сценах.
Ниже представлены результаты качественного сравнения. В относительно простых сценах (верхние группы на изображении) у TTT3R и Wint3R уже наблюдаются проблемы со смещением краёв зданий. С ростом сложности сцены (средние группы) методы-конкуренты начинают демонстрировать повторяющиеся структуры и размытые поверхности, что вызвано проецированием одной и той же геометрической структуры в разные места из-за накопленного дрейфа позы.
В наиболее сложных сценах с несколькими зданиями на открытом воздухе (нижние группы) разрыв становится ещё более явным: TTT3R и Wint3R почти полностью теряют пространственную согласованность, генерируемые облака точек коллапсируют и фрагментируются, невозможно даже различить отдельные здания. Для сравнения, LingBot-Map сохраняет чёткую геометрическую структуру, острые края зданий и непрерывные поверхности стен, что показывает, как способность к долгосрочной геометрической согласованности, обеспечиваемая GCA, напрямую трансформируется в высокое качество 3D-реконструкции.
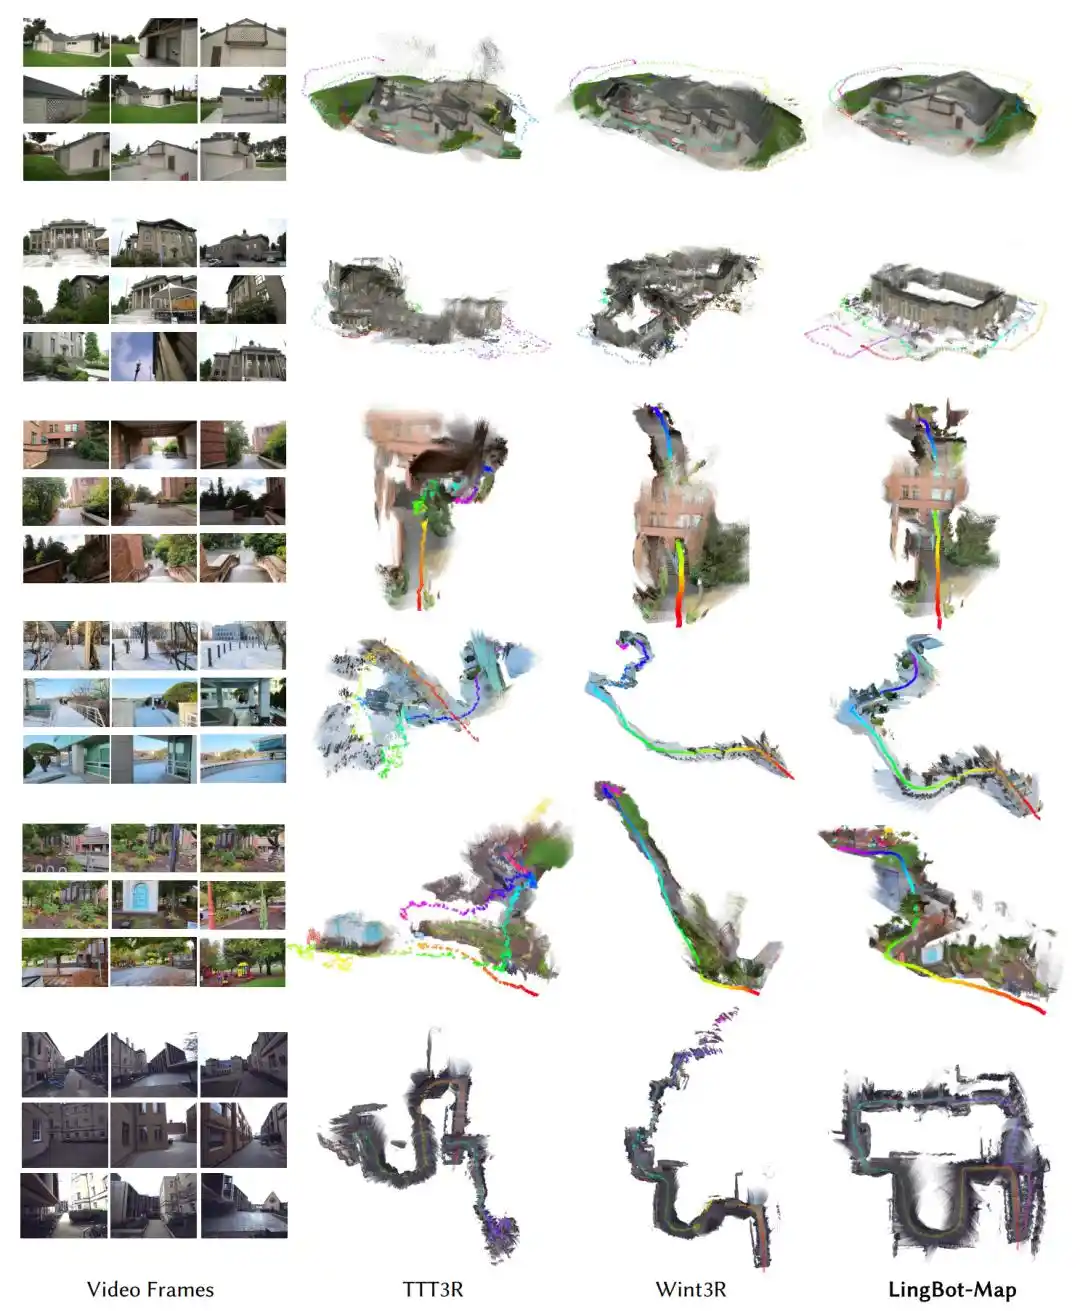
Качественное сравнение реконструкции облаков точек.
От одной модели — к системе пространственного восприятия для роботов
На самом деле, если взглянуть на техническую стратегию Ant Lingbo, LingBot-Map существует не изолированно.
Для робота настоящее пространственное понимание — это не единичная способность. Сначала нужно понять окружающую среду, затем точно определить расстояния и, наконец, интегрировать непрерывно наблюдаемую информацию, формируя долгосрочную память обо всей среде.
Вокруг этих трёх этапов Ant Lingbo уже выстроила LingBot-Vision, LingBot-Depth и LingBot-Map, соответствующие пониманию визуальной структуры, высокоточному пространственному восприятию и постоянной пространственной памяти соответственно.
Подход LingBot-Vision заключается в том, чтобы заставить модель вновь обратить внимание на границы в изображении. Команда считает, что контуры объектов и области изменения формы содержат большое количество геометрической информации и являются важными ключами для понимания пространства роботом. На основе этого команда предложила моделирование маскированных границ (Masked Boundary Modeling), позволяющее модели без ручной разметки или дополнительных детекторов границ самостоятельно изучать представление границ на уровне субпикселей и использовать эту информацию для усиления визуальных представлений.
Ключевое понимание LingBot-Depth заключается в том, чтобы рассматривать отсутствие данных с датчика как информацию, доступную для обучения, а не просто как шум. С помощью моделирования маскированной глубины (Masked Depth Modeling, MDM) модель может, объединяя визуальный контекст RGB-изображения, выводить информацию о глубине в отсутствующих областях. Таким образом, робот не только видит объекты, но и точнее определяет их пространственное взаиморасположение, особенно проявляя себя при работе с прозрачными, отражающими, плотными объектами.
LingBot-Map далее решает проблему запоминания, используя возможности потоковой 3D-реконструкции для организации визуальной информации из непрерывного видео в стабильное трёхмерное пространственное представление, позволяя роботу обновлять понимание окружающей среды в процессе постоянного движения и сохранять память об уже исследованных областях.
Вместе они образуют цепочку пространственного интеллекта от восприятия к пониманию и действию.
Когда робот сможет непрерывно воспринимать, понимать и запоминать окружающую среду, у него появится возможность выполнять более сложные задачи навигации, инспекции, манипулирования и выполнения миссий. То, что продвигает LingBot-Map, — это ключевой шаг робота от «видения мира» к «пониманию и использованию мира».
Эта статья из официального аккаунта WeChat «Машинное сердце» (ID: almosthuman2014), редактор: Чэнь Чэнь.