ИИ-учитель уже может выполнять множество одноразовых обучающих задач.
Математическую задачу он может разбить на этапы; эссе на английском языке — указать на грамматические ошибки; шахматную партию — объяснить следующий ход. Во многих сценариях вывод модели уже достаточно похож на терпеливого помощника.
Но эффективность обучения нельзя оценивать только со стороны учителя. Исправил ли ученик ошибки после объяснения, просто ли он следует подсказкам, оказывает ли одно и то же объяснение разный эффект на разных учеников — всё это происходит на стороне ученика.
Если ИИ-учитель хочет научиться персонализированному руководству, ему также необходимо многократно наблюдать за реакцией учеников.
В реальности эти реакции в основном получают из human study. Каждая корректировка обучающей стратегии требует привлечения студентов, сбора взаимодействий и последующей ручной оценки.
Модели ИИ можно быстро обновлять, но скорость получения образовательной обратной связи ограничена циклом экспериментов human study.
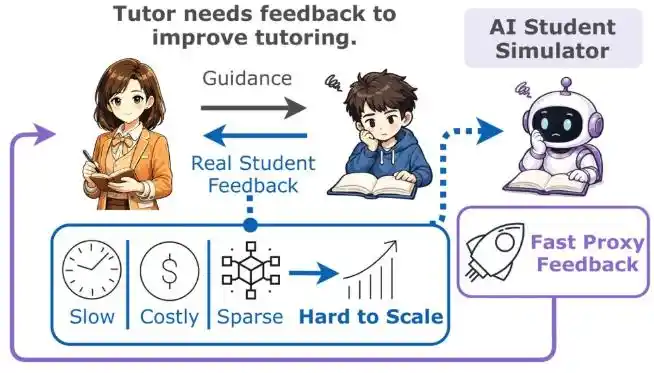
ИИ-тьютору нужна обратная связь от учеников для улучшения преподавания, но сбор реальной обратной связи обходится дорого. StudentSim стремится превратить записи реальных учеников в прокси-обратную связь, которую можно многократно использовать на этапе обучения.
Недавнее исследование StudentSim исходит из этого противоречия.
Исследовательская группа хочет улучшить ИИ-учителя, чтобы он понимал сильные и слабые стороны учеников и давал соответствующие указания разным ученикам. В процессе работы команда свела проблему к симулятору ученика: можно ли на реальных данных учеников обучить оцениваемых, многоразовых ИИ-учеников, чтобы ИИ-учитель получал больше обратной связи на этапе обучения.
Ссылка на статью: https://arxiv.org/abs/2609.01591
Ссылка на код:https://github.com/microsoft/StudentSim
Страница статьи на Huggingface:https://huggingface.co/papers/2609.01591
Эта задача в современных исследованиях ИИ-агентов не является изолированной. User simulator становится популярным направлением исследований, проникая в такие сценарии, как обслуживание клиентов, электронная коммерция, медицинские консультации, веб-операции. Исследователи создают симулированных пользователей, чтобы агент прошел больше взаимодействий перед запуском, тестируя стратегии, формулировки и устойчивость.
Моделирование пользователей в образовательном контексте сложнее. У учеников есть относительно стабильные границы знаний, привычные ошибки и траектории обучения. На одну и ту же задачу кто-то может ошибиться в знаке, кто-то — неправильно понять концепцию, кто-то после подсказки может сам вывести ответ, а кому-то нужно более прямое руководство.
Недавно обсуждаемые цифровые двойники человеческих учеников как раз и развиваются вокруг таких потребностей.
Моделирование учеников — не новая тема
От байесовского отслеживания знаний 1995 года до отслеживания глубоких знаний и отслеживания знаний с вниманием — это направление исследовалось почти 30 лет и стало весьма зрелым в аппроксимации поведения учеников.
Их общий недостаток в том, что модели принимают только структурированные входные данные, такие как задачи, состояния, значения способностей, у них нет входа для получения инструкций на естественном языке. Независимо от того, что говорит учитель, такие модели не могут интерактивно демонстрировать изменения в поведении, подобные ученическим.
Если напрямую заставить большую модель играть роль ученика, это кажется удобным. Написав ей «Ты — ученик начальной школы со слабой математической подготовкой», модель может мгновенно переключиться на манеру речи младшего школьника и также проявлять нерешительность и неуверенность.
Однако, манера речи и уровень познания не синхронизированы.
Модель может ответить с манерой ученика начальной школы: «Я не очень понимаю», а в следующем предложении выдать рассуждения на уровне матанализа. Она выглядит так, будто играет роль ученика, но фактическая обратная связь всё ещё зависит от собственных знаний модели, которые могут быть намного выше уровня знаний, который ей ограничили.
При обучении ИИ-учителя это смещение уровня познания создаёт проблемы. Тьютор получает не реакцию конкретного ученика в рамках его текущих границ способностей, а реакцию высоко способной модели, упакованную под определённый образ.
Именно поэтому использование только описания способностей в качестве условия — это очень хрупкий канал условия для больших моделей. Этот путь активно использовался в образовательных сценариях последние два года: диалоговые учебные корпуса, мультиагентные классы, генерация данных обучающихся — всё это применялось; параллельно появляется ряд исследований, специально проверяющих его валидность, ставящих под сомнение с точки зрения архитектуры, эталонов достоверности и опыта использования учителями.
В педагогике оценка эффективности руководства обычно не может основываться только на результатах самостоятельной работы ученика, но также и на том, как далеко ученик может продвинуться с помощью.
Выдвинутая Выготским концепция зоны ближайшего развития (zone of proximal development) как раз обсуждает это: разрыв между тем, что ученик может сделать самостоятельно сейчас, и тем, что он может сделать с поддержкой учителя, отражает пространство для педагогического вмешательства.
Эта идея позже была реализована в динамической оценке (dynamic assessment) как измеримая процедура: записывается не только правильность ответа ученика, но и наблюдается, как меняются его результаты после получения подсказки.
Применительно к симулятору ученика эта идея соответствует двум типам способностей.
Первое: симулятор должен воспроизводить состояние ученика при самостоятельной работе, включая границы способностей, привычные ошибки и типичный выбор. Второе: симулятор должен уметь соответствующим образом меняться после получения инструкций учителя, демонстрируя возможные изменения, которые могут произойти у этого ученика с помощью.
StudentSim
StudentSim определяет эти два типа способностей как behavioral fidelity (достоверность поведения) и guidance responsiveness (реакция на руководство) и соответственно обучает и оценивает персонализированные симуляторы учеников.
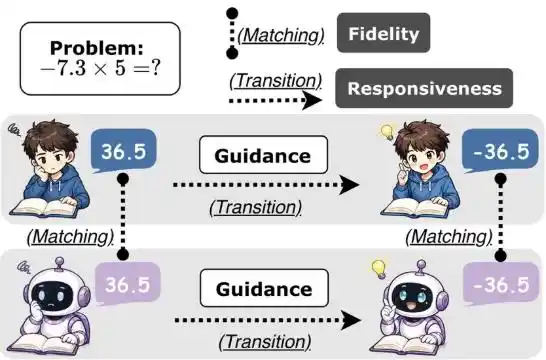
Симулятор ученика должен одновременно отвечать на два вопроса: похож ли он на целевого ученика при самостоятельной работе и вызывает ли он соответствующие изменения после получения инструкций учителя.
Процесс обучения состоит из двух шагов.
Первый шаг: агрегирование записей множества учеников в одной предметной области для обучения общей модели поведения учеников. На этом этапе изучаются общие ошибки, формат ответов, пути исправления после получения руководства.
Второй шаг: продолжение обучения на собственных записях отдельного ученика для получения персонализированного симулятора. Записей одного ученика мало, прямое обучение легко приводит к переобучению; сначала изучение групповых закономерностей, затем адаптация к личным данным позволяет более стабильно получать симулятор для каждого ученика.
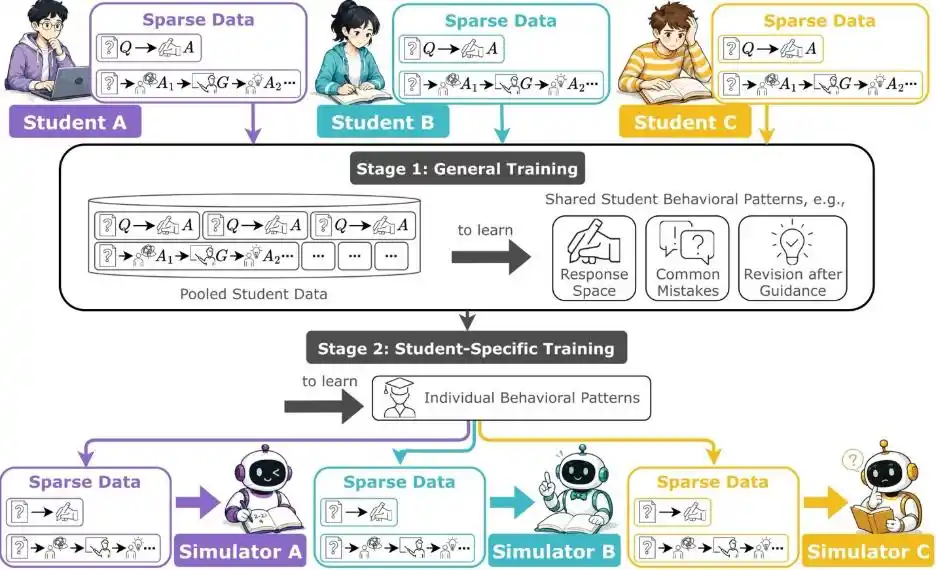
Процесс обучения
Исследовательская группа также создала StudentSimEval. Оценка охватывает 60 реальных учеников из трёх сценариев: шахматы, письмо на английском как втором языке и базовая математика.
В шахматах симулятор должен предсказать ход конкретного игрока в партии и изменить ход после указаний тренера. В письме на втором языке симулятор должен генерировать эссе, соответствующее ошибкам учащегося, и переписывать фрагменты на основе исправлений учителя. В математике симулятор должен предсказывать ответ ученика и исправлять его после объяснения.
Эти задачи на поверхности сильно отличаются, но цель оценки остаётся неизменной: сначала проверить, похож ли симулятор на самого ученика, затем — реагирует ли он на руководство. Все методы получают один и тот же набор записей учеников и сравниваются на одном и том же held-out тестовом наборе.
В результатах по шахматам F-мера StudentSim составляет 0.5150, R — 0.9067; у GPT-5.4 — 0.2316 и 0.7186 соответственно; у Maia2 — 0.4535 и 0.2721 соответственно. В экспериментах с письмом на втором языке и математикой StudentSim также превосходит соответствующие базовые линии по обоим показателям.
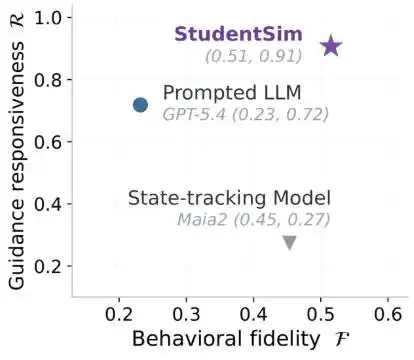
Двумерные результаты оценки в шахматах. GPT-5.4 хорошо реагирует на руководство, но имеет низкую достоверность поведения; Maia2 ближе к ходам шахматиста, но не имеет входа для инструкций на естественном языке; StudentSim находится в позиции с одновременно высокими значениями по обоим показателям.
Эти результаты демонстрируют чёткое разделение. GPT-5.4 может читать инструкции, но недостаточно точно имитирует конкретного ученика. Maia2 ближе к ходам человека-игрока, но не может воспринимать подсказки тренера на естественном языке. StudentSim, обученный на реальных записях обучения и адаптированный для каждого ученика, достигает улучшения как в поведении индивида, так и в реакции на руководство.
Однако сам по себе симулятор ученика не является целью; конечный пункт в том, что его функциональность должна быть применима в реальном мире и использоваться для улучшения модели учителя.
Ранее при обучении ИИ-тьюторов сигнал вознаграждения в некоторых работах поступал от экспертно размеченных качественных учебных диалогов, в других — от универсальных больших моделей-судьёй, использующих оценочные шкалы. Также были попытки подключить вознаграждение к симулированному ученику, но использовались ИИ-ученики на основе LLM, которые лишь играли роль и не были достоверны по уровню познания, а не симуляторы, обученные на данных реальных обучающихся. В этом аспекте StudentSim предлагает иной подход.
В статье далее StudentSim интегрируется в процесс обучения с подкреплением ИИ-тьютора.
Экспериментальный сценарий — шахматы. Система сначала извлекает ошибочные ходы, сделанные реальными учениками, ИИ-тьютор генерирует указания, StudentSim после прочтения указаний выдаёт исправленный ход.
Stockfish используется для вычисления изменения качества исправленного хода относительно исходного ошибочного хода, этот балл передаётся обратно тьютору в качестве сигнала RL. Контрольные группы включают тьютора без RL и тьютора, использующего GPT-5.4 в качестве студенческого симулятора для вознаграждения.
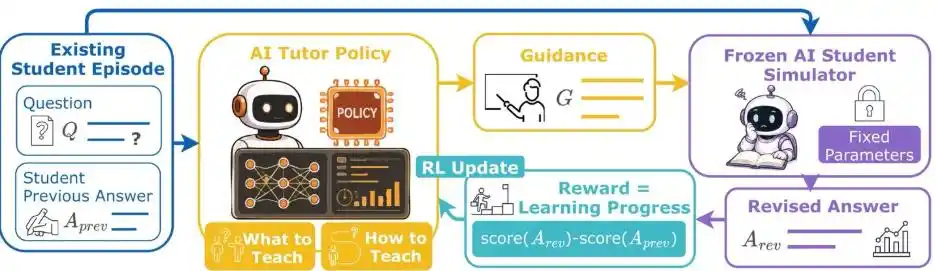
Тьютор генерирует указания, замороженный ИИ-симулятор ученика выдаёт исправленный ответ, система обновляет тьютора на основе изменения качества до и после исправления.
Три группы тьюторов используют одинаковые базовые модели, начальную точку SFT и настройки GRPO, но источник вознаграждения разный.
После слепой оценки шахматными экспертами, тьютор, обученный с вознаграждением от StudentSim, занял первое место по точности, качеству руководства и оценке персонализации.
Эксперты вслепую оценили три измерения: точность — доля ответов «без вводящих в заблуждение фактических ошибок», качество руководства и персонализация — от 1 до 5 баллов каждый. Тьютор, обученный с вознаграждением от StudentSim, занял первое место по всем трём измерениям.
Более примечателен эксперимент с противоположным результатом: точность тьютора, обученного с использованием GPT-5.4 в качестве студенческого симулятора, не только уступает StudentSim, но и ниже базовой линии без RL вообще, отставание связано с заметно более высокой частотой серьёзных фактических ошибок. Недостоверный симулятор толкает учителя в неправильном направлении: симулятор с познавательным уровнем, не соответствующим реальному ученику, но со сверхъестественными способностями к пониманию, даже прочитав самое нелепое руководство, может сам вывести какой-то ответ, тем самым присвоив случайное вознаграждение ошибочному руководству, и RL оптимизируется в сторону хаоса (и даже ошибок).
StudentSim не заменяет эксперименты с реальными учениками в образовательных исследованиях. Он превращает записи реальных учеников в симулированную обратную связь, которую можно многократно использовать на этапе обучения, позволяя ИИ-тьютору пройти больше циклов отбора и оптимизации перед входом в human study.
Для систем ИИ-учителей, требующих персонализированной обратной связи, такие студенческие симуляторы, продолжая мысль недавно популярных user simulator (можно симулировать любого человека, создавать цифровых двойников людей), предлагают революционный инженерный путь:
Изучать, как ученики ошибаются, изучать, как ученики меняются под руководством, предоставлять сигналы обратной связи в масштабе машинного обучения для обучения с подкреплением моделей учителей.
Источники:https://arxiv.org/abs/2609.01591
Эта статья взята с официального аккаунта WeChat «新智元» (Новый интеллектуальный век), автор: 新智元; редактор: LRST