В последние годы модели генерации видео быстро совершенствуются в разрешении, временной согласованности и управляемости. Задав текст, изображение, траекторию камеры или действия игрока, модели уже способны синтезировать последовательные последующие кадры, постепенно превращая «интерактивный видеомир» из концепции в прототип, который можно наблюдать и которым можно управлять.
Но способность продолжать изображение не равна способности управлять миром. Перемещение и столкновения в кадре — это лишь самый наглядный уровень взаимодействия; в более сложных средах у персонажей есть цели, идентичность и отношения, события подчиняются правилам и оставляют причинно-следственные последствия, длящиеся длительное время. Многие состояния существуют даже за пределами кадра, но всё равно меняют последующий сюжет и действия. Лишь предсказывая следующий фрагмент наблюдения на основе локальных пикселей, трудно явно поддерживать эту высокоуровневую семантику.
Сложный мир прежде всего требует «понимания почему». Цели, правила, память и причинно-следственные цепочки обычно невозможно напрямую извлечь из текущего кадра, но именно они определяют, как мир должен измениться в следующий момент. Языковые модели обладают способностями вызывать знания, рассуждать, планировать и программировать, что подходит для обработки таких низкочастотных, но высокосложных решений и дальнейшего воплощения этих решений в исполняемые правила.
Ещё один часто упускаемый из виду факт: игровое видео — это не сам мир, а пиксельная проекция результатов выполнения программы после рендеринга. На текущем этапе игры и симуляторы по-прежнему составляют основной источник интерактивных данных для видеомоделей мира. Если сохранить только действия и пиксели, а затем заставить видеомодель напрямую изучать отображение между ними, это равносильно обходу изначально существующей программы, правил и явного состояния мира с требованием к модели аппроксимировать всё поведение программы на основе визуальных результатов. Такой путь обучения не только неэффективен, но и связывает в одной модели «как мир эволюционирует» и «как мир представляется».
Основываясь на этом наблюдении, исследовательская группа AGI Lab Университета Сиху и Наньянского технологического университета предложила Code World Model — новую парадигму мировой модели, где языковая модель выступает в роли «мозга». Её ключевая идея заключается в том, чтобы coding agent посредством непрерывного написания, вызова и модификации кода поддерживал и обновлял исполняемое состояние мира; состояние, связанное с текущим наблюдением, затем преобразуется в прокси для управления генерацией детализированного визуального изображения видеомоделью.
Ссылка на статью:https://arxiv.org/abs/2608.25927
Домашняя страница проекта:https://buaacyw.github.io/cwm/
Репозиторий кода:https://github.com/buaacyw/code-world-model
Здесь языковая модель не заменяет видеомодель. Code World Model перераспределяет их обязанности: знания, цели, правила и долгосрочная причинность находятся в ведении coding agent и кода, внешний вид, детали движения, освещение и текстуры — в ведении видеомодели. Другими словами, первое определяет, что происходит в мире, а второе — как это всё выглядит.
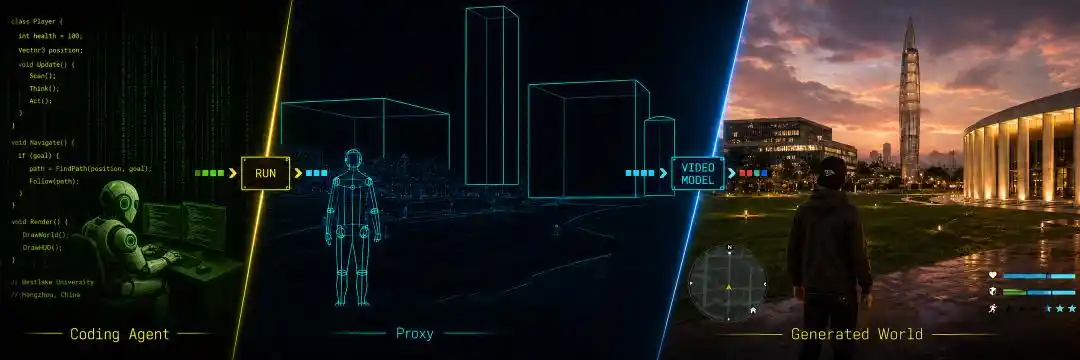
Рис. 1 Ключевое разделение труда в Code World Model: coding agent через код эволюционирует состояние мира, прокси преобразует связанные состояния в визуальные условия, видеомодель генерирует итоговое изображение.
Обзор метода
Согласно указанному разделению труда, Code World Model разбивает процесс функционирования мира на три взаимосвязанные части.
coding agent: понимает намерения игрока и новые события, вызывает знания о мире, рассуждает о потенциальных последствиях и решает, какие механизмы необходимо выполнить, объединить или изменить.
code: с более высокой частотой выполняет детерминированные обновления положения, атрибутов, столкновений, времени восстановления и триггеров событий, превращая высокоуровневые решения в проверяемые, повторно используемые, непрерывно исполняемые правила.
video model: считывает условия эволюционировавшего состояния, использует априорные знания о внешнем виде, движении и взаимодействии, извлечённые из больших объёмов визуальных данных, генерирует визуальное наблюдение с богатой текстурой, освещением и локальной динамикой.
Это разделение труда также соответствует разным вычислительным частотам. coding agent нужен только для разреженного принятия решений при появлении новой цели, сложного события или нехватки существующих механизмов; как только решение записано в код, программа может непрерывно выполнять интенсивные обновления состояния.
Что ещё важнее, coding agent изменяет не только значения в определённый момент времени, но и может менять принципы, по которым мир будет функционировать в дальнейшем.
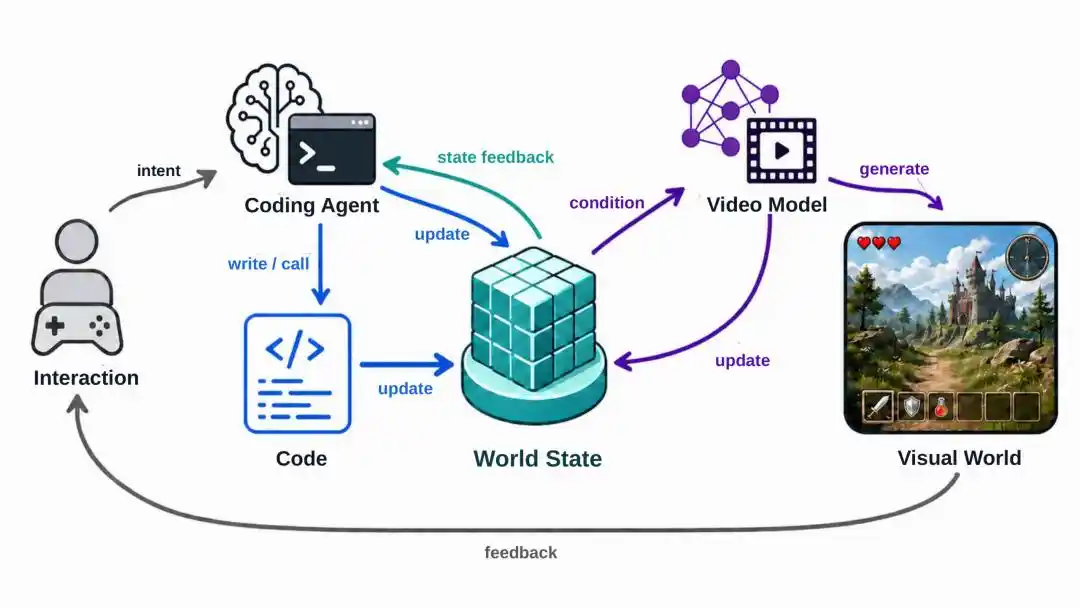
Рис. 2 Общая структура Code World Model. Полная концепция включает визуальную обратную связь; текущий прототип фокусируется на проверке прямой цепочки coding agent / code → world state → proxy → video model.
Прокси связывает исполняемое состояние и генерацию видео
После разделения обязанностей остаётся ключевая проблема интерфейса: coding agent и code поддерживают исполняемое состояние, а video model принимает текстовые, графические или видео токены. Между ними необходим общий язык, который одновременно легко конструируется программой и может обеспечивать пространственные ограничения от кадра к кадру.
Структурированный текст достаточно гибок, но ему сложно стабильно описывать положение сущностей, относительные отношения, траектории движения и точные изменения камеры для каждого кадра; полное построение и рендеринг 3D-мира, хотя и даёт более сильный контроль, снова влечёт высокие затраты на ассеты, геометрию, материалы, анимацию и конвейер рендеринга.
Для решения этой проблемы в работе вводится proxy. Он извлекает из world state информацию, которой действительно необходимо следовать при текущем наблюдении, и организует её в грубое визуальное представление. Лёгкий, детерминированный компилятор отрисовывает proxy в proxy video, который вместе со структурированным текстом передаётся в video model.
Текст отвечает за объяснение «кто, что и что делать», а proxy определяет «где, как двигаться, как снимать камерой».
proxy может выражать камеру и ракурс, положение и ориентацию сущностей, масштаб и траекторию, компоновку сцены и окклюзию, а также грубое состояние, необходимое для текущего взаимодействия; текстуры, материалы, детальное освещение и полную локальную динамику намеренно оставляют video model. Статья обобщает этот принцип проектирования следующим образом: сохранять только минимальное достаточное состояние, необходимое для текущего наблюдения, находя баланс между управляемостью и стоимостью кодирования состояния.
В текущей реализации proxy имеет лишь четверть ширины и высоты целевого видео, количество пикселей примерно в 1/16 от целевого. Он состоит из простых, повторно используемых геометрических примитивов, не требует ассетов производственного качества, но при этом обеспечивает кадр за кадром редактируемый пространственно-временной каркас.
Получение строго выровненных данных из записей геймплея
Чтобы video model научился понимать proxy, обучающие выборки должны одновременно содержать proxy video, структурированный текст и целевое RGB-видео, причём proxy и RGB должны быть строго выровнены во времени, по камере и идентификаторам сущностей.
Записи геймплея естественным образом сохраняют это соответствие. Исследовательская группа синхронно записывала RGB, состояние камеры, идентификаторы сущностей, положение и ориентацию, приблизительный масштаб, компоновку сцены и состояние взаимодействия из одного и того же процесса gameplay execution, а затем офлайн компилировала proxy через код. Поскольку оба происходят из одного выполнения, для каждого кадра можно установить взаимно однозначное соответствие, а идентификаторы могут быть стабильно отображены между кадрами.
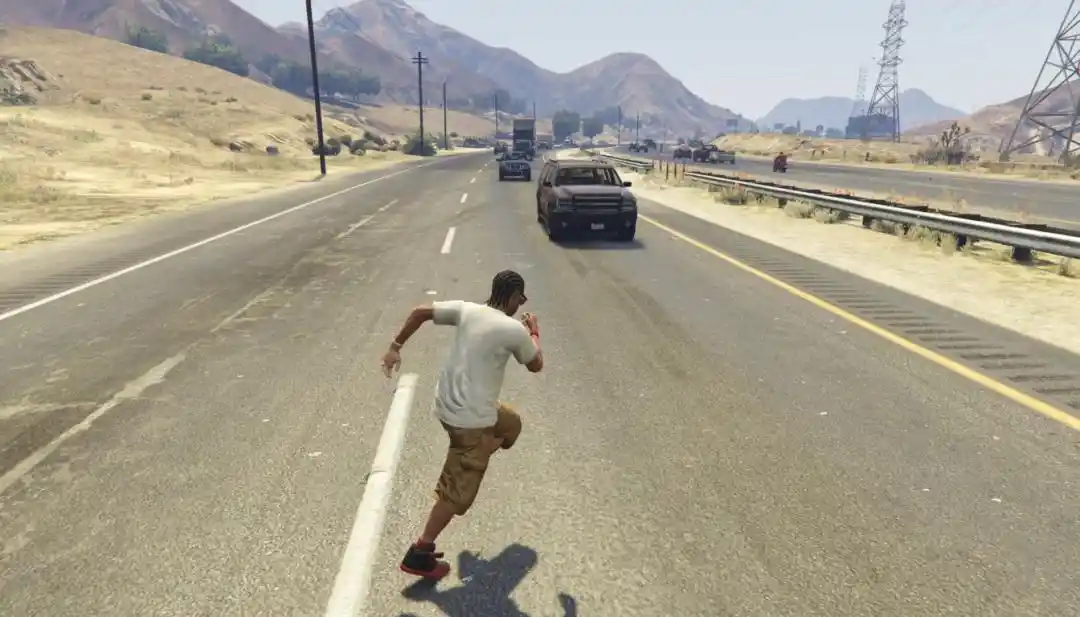
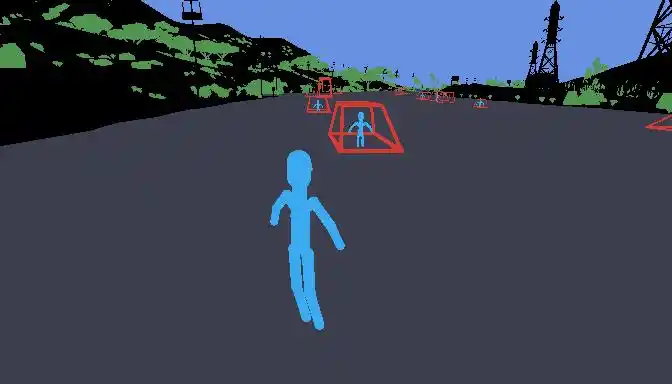
Рис. 3a Целевое RGB (вверху) и proxy того же кадра (внизу) из игровых данных.
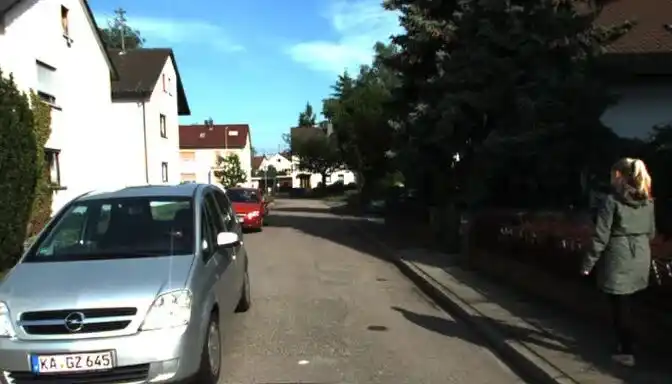
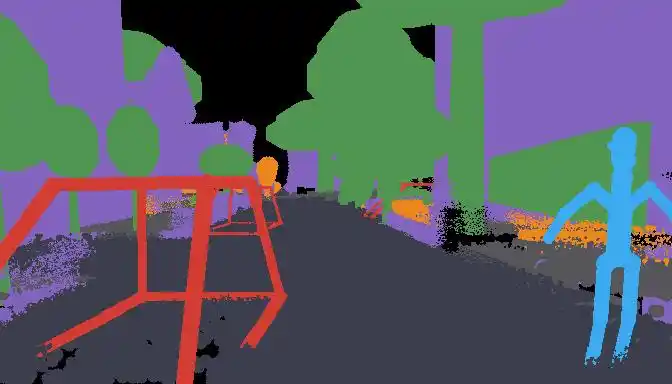
Рис. 3b Целевое RGB из реального видео (вверху) и прокси, сконструированный офлайн с использованием калибровки камеры, 3D-реконструкции и аннотации объектов (внизу).
Используемые в статье данные геймплея содержат 157 записей, общей продолжительностью около 5.6 часов исходного видео. Исследовательская группа производила выборку с интервалом в 2 секунды, получив 9,420 обучающих фрагментов по 5 секунд; каждое целевое RGB содержит 124 кадра с разрешением 1344×768 и частотой кадров 24 FPS, соответствующий proxy также содержит 124 кадра с разрешением 336×192 и комбинирует fixed-log depth и categorical semantic-ID map.
Те же самые записи выполнения можно перекомпилировать в прокси с разным охватом и гранулярностью информации, без необходимости повторной записи RGB.
Статья также демонстрирует на KITTI-360 офлайн-процесс создания пар прокси-наблюдение для реального видео, чтобы показать возможность расширения этого интерфейса на реальные данные; адаптация текущей видеомодели по-прежнему использует только парные данные геймплея.
Как работает прототипная система?
Текущий прототип использует бэкбон Ref2VA модели MiniMax-H3 в качестве video model, адаптирует все 50 transformer blocks с помощью rank-128 LoRA, обучаемых параметров около 596 миллионов. Обучение проводится на 8 GPU NVIDIA H800, всего выполнено 3 эпохи, 3,534 шага оптимизации.
На этапе вывода coding agent'ом выступает GPT-5.6 Sol. Система предоставляет ему базовое управление игроком, обработку столкновений, цикл обновления во время выполнения, шаблоны существующей сцены игрового движка и логики геймплея, а также прокси-примитивы, использованные на этапе обучения. coding agent может комбинировать, расширять и переписывать этот код, создавая простой, исполняемый, управляемый игроком мир; грубая 3D-геометрия в нём используется только для выражения прокси, а не напрямую в качестве итогового изображения.
Для каждого 5-секундного фрагмента GPT Image 2 генерирует appearance anchor на основе прокси первого кадра и текста; затем MiniMax-H3, объединяя первый кадр, полную последовательность прокси и текст, генерирует RGB-видео из 124 кадров, 1344×768, 24 FPS.
Более длинные видео генерируются через скользящее окно с перекрытием в 34 кадра: следующее окно наследует RGB-контекст конца предыдущего окна и повторно использует тот же appearance anchor для поддержания локальной непрерывности и общего внешнего вида идентичности.
Результаты эксперимента
Качественные результаты показывают, что даже при адаптации LoRA всего на ~5.6 часах исходного видео геймплея модель всё ещё способна, когда внешний вид персонажей, окружения и стиль явно отличаются от обучающих, следовать указанным прокси положению персонажей, траекториям действий, компоновке сцены и движению камеры, одновременно дополняя их богатыми текстурами, освещением и локальной динамикой.
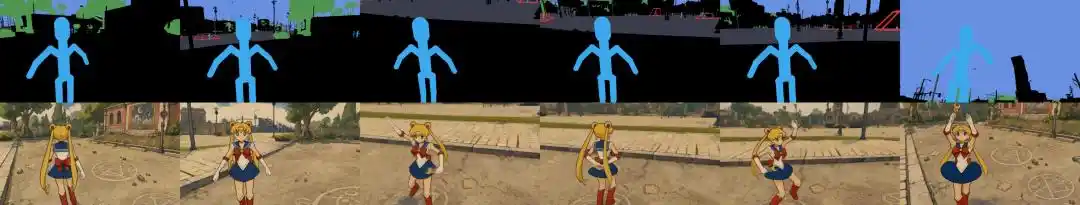
Рис. 4 proxy обеспечивает положение и траекторию действий персонажей, video model представляет один и тот же грубый каркас в виде персонажей с разной идентичностью и художественным стилем. Вверху: proxy; внизу: результаты генерации.
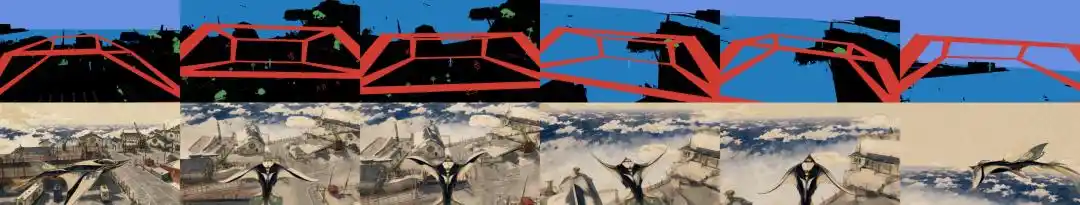
Рис. 5 Простые геометрические примитивы накладывают ограничения на сложные объекты и движение камеры. Вверху: proxy; внизу: результаты генерации.
Например, один и тот же грубый human primitive может быть представлен как персонажи с совершенно разной идентичностью и художественным стилем; wireframe или box могут ограничивать положение и примерное движение транспортных средств, лодок и других сложных объектов; один и тот же прокси-интерфейс также может выражать бег, танцы, плавание, падение и облёт камеры.
Таким образом, видно, что прокси фиксирует пространственно-временной каркас, которому должно следовать текущее наблюдение, а не ассеты и стиль обучающей игры.
На домашней странице проекта также приведено видео-сравнение с action- или camera-conditioned видеомоделями мира.
Это сравнение касается гранулярности управления и визуального результата: proxy напрямую предоставляет движение сущностей и изменение ракурса от кадра к кадру, поэтому способен накладывать более тонкие, более прямые пространственно-временные ограничения; в статье эти результаты не представлены как сравнение latency вывода.
Пользователи прокомментировали: «Будет ли Unreal Engine 6 последним движком, создающим игры традиционными 3D-методами? Возможно, Unreal Engine 7 уже будет использовать аналогичную технологическую схему. Только генеральный директор Unreal Engine Тим знает ответ»
Позже Тим также пришёл посмотреть и сказал: «Я тоже не знаю!»
Заключение: сначала решить, что происходит в мире, а затем сгенерировать, как это выглядит
Предыдущие видеомодели мира в основном изучали, «как продолжить наблюдение». Code World Model продвигает проблему на шаг вперёд: перед генерацией следующего фрагмента наблюдения сначала поддерживать, что представляет собой мир в данный момент, каким правилам следует и почему последствия одного события сохраняются.
По-настоящему открытый генеративный мир требует как визуального воображения видеомодели, так и исполняемого механизма, способного поддерживать знания, цели, правила, отношения и причинно-следственные последствия. Суть Code World Model можно свести к одной фразе: пусть код решает, что происходит в мире, а видеомодель решает, как всё это выглядит.
Источники: https://arxiv.org/abs/2608.25927
Эта статья взята с официального аккаунта WeChat «Новые Интеллектуальные Ресурсы», автор: Новые Интеллектуальные Ресурсы; редактор: LRST