Проблема нехватки памяти в больших языковых моделях: решение нашли в технологии USB-флешек

marsbitОпубликовано 2026-07-20Обновлено 2026-07-20

Введение

В статье обсуждается новый подход к решению проблемы нехватки памяти для крупных языковых модеей (ИИ) с помощью технологии NAND Flash, аналогичной используемой в USB-накопителях. Компании SanDisk и SK Hynix разрабатывают High Bandwidth Flash (HBF) — высокопропускную флэш-память, которая применяет методы упаковки и чипового стекирования, как в HBM (высокоскоростной памяти), к чипам NAND Flash. Ключевая идея в том, что Flash-память медленна преимущественно при записи, но чтение может быть значительно ускорено. Путем стекирования до 16 чипов NAND Flash в один модуль HBF целевые показатели для первого поколения составляют до 512 ГБ емкости и пропускной способности чтения до 1.6 ТБ/с. HBF позиционируется не как замена HBM, а как дополнение для этапа *инференса (вывода) ИИ-моделей*. В этом сценарии веса уже обученной модели в основном статичны и требуют интенсивного чтения, что хорошо подходит для Flash. Это позволяет разгрузить дорогую и ограниченную по объему HBM, освободив ее для самых горячих данных, и потенциально снизить количество необходимых ускорителей, общую стоимость и энергопотребление серверов. Хотя до коммерческого внедрения HBF могут пройти годы, эта разработка сигнализирует о переосмыслении иерархии памяти в системах ИИ, где различные типы данных могут оптимально размещаться на разных уровнях: HBM для максимальной скорости, HBF для емкого и достаточно быстрого доступа только для чтения, а SSD — для массового хранения.

Погодите, разве Flash-память не очень медленная? Как же SanDisk и SK Hynix предлагают использовать её для больших языковых моделей???

В свежем выпуске IEEE Spectrum представлен довольно неожиданный подход: проблему нехватки памяти в больших языковых моделях можно смягчить с помощью той же технологии, что и в USB-флешках.

Да, речь именно о NAND Flash.

В представлении многих главные черты Flash-памяти — дешевизна, большой объём и сохранение данных без питания. Но что касается скорости, особенно для задач вывода больших моделей (инференса), она кажется не самым подходящим решением.
Но сейчас SanDisk и SK Hynix продвигают нечто новое: High Bandwidth Flash (высокоскоростная флеш-память), сокращённо HBF.

Идея проста: применить к NAND Flash передовые методы упаковки и чипового стекирования, как в HBM (High Bandwidth Memory).

Другими словами, заставить флеш-память, изначально предназначенную для хранения, участвовать в высокоскоростной поставке данных для AI-инференса.
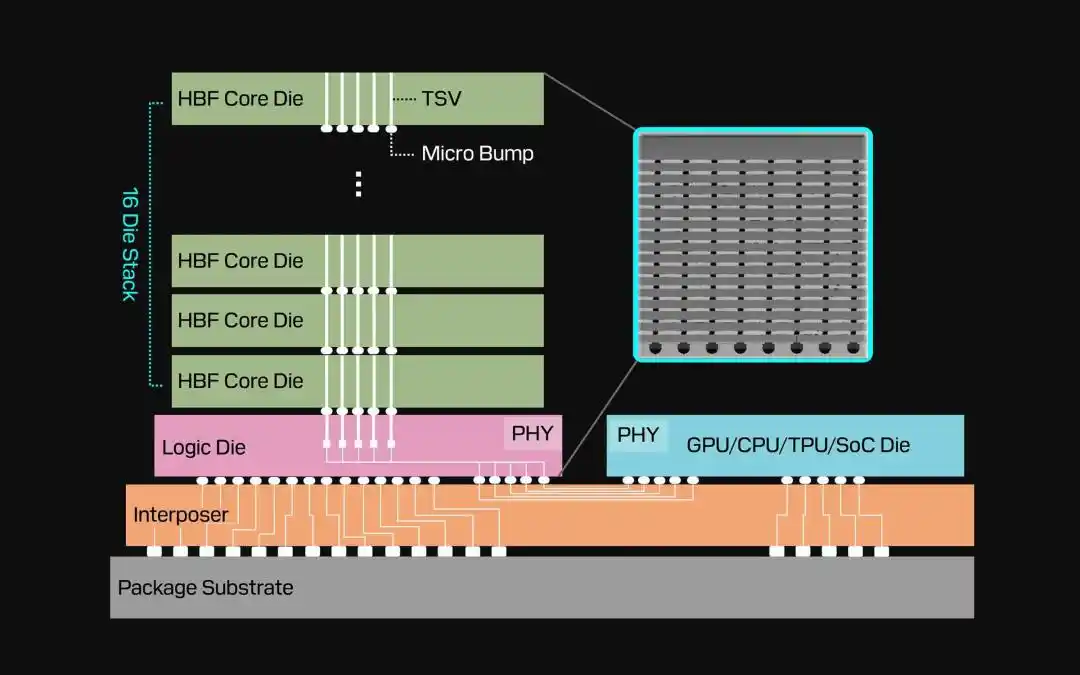
Согласно открытым материалам SanDisk, в HBF можно уложить до 16 чипов NAND Flash, целевой максимальный объём одного стека — до 512 ГБ, а целевая максимальная пропускная способность чтения — до 1,6 ТБ/с.

В дорожной карте для второго и третьего поколений пропускная способность чтения вырастет до 2 ТБ/с и 3,2 ТБ/с соответственно.

Хотя эти цифры ещё не догоняют топовые HBM, это уже не та «медлительная память», что была у традиционной флешки.

За этим технологическим прорывом, возможно, стоит глобальная проблема дефицита поставок в индустрии памяти.

Недавно (11 июля по пекинскому времени) генеральный директор южнокорейского гиганта памяти SK Hynix, Го Лу Чжэн, публично заявил в день дебюта на Nasdaq, что ожидает самого серьёзного дефицита поставок в истории мировой индустрии памяти к 2027 году. Это заявление быстро вызвало реакцию на рынках капитала и в отраслевых СМИ.

На этом фоне запуск HBF совместно с SanDisk, возможно, и является их технологическим ответом на попытку смягчить напряжённость с поставками памяти.

Давайте разберёмся.

Разве Flash не медленная? Как её можно использовать для AI?

Возникает вопрос: разве Flash не печально известна медленной записью? Как её вдруг можно применять для AI?

В интервью IEEE Spectrum директор по исследованиям полупроводникового рынка Objective Analysis, Джим Хэнди, отметил: «У многих первая реакция именно такая: как это может работать? Flash ведь невероятно медленная».
Но ключевой момент в том, что Flash медленна в основном при записи.

NAND Flash хранит данные с помощью заряда в плавающем затворе транзистора, организуясь в блоки и страницы. Этот механизм позволяет сохранять данные без питания, в отличие от DRAM, которую нужно постоянно обновлять. Поэтому она естественным образом подходит для долгосрочного хранения, сочетая высокую плотность и низкую стоимость.

Однако расплата в том, что для записи данных нужно проталкивать или удалять заряд через изолирующий затвор, и этот процесс значительно медленнее, чем зарядка/разрядка конденсатора.

Поэтому в традиционных вычислениях Flash трудно сравнивать с высокоскоростной памятью вроде DRAM или HBM.

Но если смотреть только на чтение, картина меняется.
Согласно последнему стандарту интерфейса флеш-памяти ONFI 6.0, теоретическая максимальная пропускная способность одного кристалла (die) может достигать 4,8 ГБ/с.

Само по себе это число не кажется впечатляющим.

Но максимальная пропускная способность одного модуля DDR5 DIMM составляет до 70,4 ГБ/с, а одного стека HBM4E — до 3,6 ТБ/с. По сравнению с одним чипом NAND Flash разница составляет примерно 750 раз.

HBF как раз и нацелена на то, чтобы с помощью 3D-упаковки и вертикального стекирования объединить несколько кристаллов NAND Flash, значительно повысив общую пропускную способность чтения.

Старший вице-президент по исследованиям систем памяти SK Hynix, Хошик Ким, отметил: «Применяя передовые технологии 3D-упаковки и вертикального стекирования к NAND-флеш-памяти, HBF позволяет достичь пропускной способности, значительно превышающей стандартное хранилище NVMe».

Подобно тому, как HBM складывает чипы DRAM, HBF складывает кристаллы NAND Flash, создавая чипы с высокой плотностью хранения.

Их цель — не внезапно ускорить один чип Flash, а с помощью стекирования и упаковки увеличить количество каналов чтения.

HBF не стремится заменить HBM, она находит свою нишу

По-настоящему интересно в HBF не то, что она собирается заменить HBM.

А то, что она находит идеальную для Flash область применения: AI-инференс.

Требования к памяти для обучения и вывода (инференса) разные.

При обучении больших моделей системе постоянно нужно считывать веса, вычислять ошибки, а затем обновлять веса через обратное распространение.

Этот процесс требует как интенсивного чтения, так и интенсивной записи, что очень неудобно для Flash.

Потому что Flash медленно записывает, а частые записи также связаны с проблемами долговечности и управления стиранием.

Но на этапе инференса всё иначе.

На этом этапе модель уже обучена, веса в основном зафиксированы. Чаще всего системе нужно быстро считывать эти огромные веса модели, а не часто их перезаписывать.

Это как раз попадает в сильную сторону Flash.
Старший вице-президент по исследованиям систем памяти SK Hynix Ким заявил: «В среде инференса такие большие, интенсивно считываемые данные, как статические веса моделей с миллиардами параметров или предвычисленный KV-кеш (precomputed KV cache), могут надёжно храниться на уровне HBF».

Таким образом, дорогую и ограниченную по объёму HBM можно освободить для использования в качестве высокоскоростного буфера.

Эта архитектура похожа на добавление к AI «пула памяти только для чтения сверхбольшой ёмкости».

HBM по-прежнему отвечает за самый срочный и частый обмен данными для высокоскоростных вычислений.

HBF же отвечает за хранение тех огромных по объёму, но редко изменяемых параметров модели.

Для текущего инференса больших моделей этот подход имеет большое практическое значение.

Потому что трудности инференса больших моделей уже давно не ограничиваются нехваткой вычислительной мощности. Нехватка памяти, недостаточная пропускная способность, высокое энергопотребление, дороговизна развёртывания — все эти факторы накладываются друг на друга.

Особенно на фоне продолжающегося роста масштабов моделей, нехватка видеопамяти на одной карте и высокая стоимость HBM становятся значительными ограничивающими факторами.

Часто проблема не в том, что GPU не справляется с вычислениями, а в том, что модель не помещается или данные не успевают подаваться.

И если HBF сможет найти баланс между ёмкостью, пропускной способностью и стоимостью, она может позволить запускать более крупные модели с меньшими затратами.

512 ГБ в одном стеке: AI-серверы, возможно, будут использовать меньше карт

Целевые параметры HBF первого поколения от SanDisk — максимум 512 ГБ ёмкости и 1,6 ТБ/с пропускной способности чтения.

Это сочетание очень важно: преимущество HBM — чрезвычайно высокая скорость, но она дорога и ограничена по объёму; HBF, хотя и немного медленнее, может обеспечить большую ёмкость и более низкую удельную стоимость.

Это означает, что в будущем при развёртывании инференса больших моделей AI-серверам, возможно, не придётся загружать все веса в HBM.

Часть менее востребованных, статических данных, где чтения больше, чем записи, можно разместить в HBF.
Потенциальные выгоды от такого подхода:

Во-первых, смягчение ограничений по объёму HBM.

Во-вторых, снижение потребности в наращивании количества ускорительных карт для размещения модели.

В-третьих, снижение общей стоимости и энергопотребления системы инференса.

Судя по словам Кима: «HBF и HBM не конкуренты, а взаимодополняющие инструменты».

Он отмечает: «HBF может эффективно смягчить серьёзные ограничения по объёму, с которыми сталкивается HBM, не жертвуя скоростью подачи данных, что, как ожидается, позволит сократить количество ускорителей, необходимых для работы крупномасштабных моделей».

На этой основе он прогнозирует, что это решение также повысит энергоэффективность и снизит затраты, тем самым способствуя дальнейшему расширению масштабов аппаратного обеспечения AI-инференса в дата-центрах.

Это и есть самая важная для отрасли логика HBF: она нужна не для того, чтобы превратить Flash в HBM, а для того, чтобы разные данные в AI-системах находились в наиболее подходящих для них местах.

Горячие данные остаются в HBM; большие объёмы статических данных с интенсивным чтением — в HBF; более медленные и дешёвые данные — на SSD или другом хранилище.

Если такая иерархия установится, архитектура памяти аппаратного обеспечения AI-инференса может получить новый уровень.

До широкого внедрения ещё далеко, но в системе памяти больших моделей уже видны новые сигналы разделения труда

Конечно, HBF пока не является зрелым продуктом.

Согласно сообщению IEEE Spectrum, до возможных поставок HBF пройдёт как минимум год, а до массового развёртывания, возможно, несколько лет.

25 февраля этого года SanDisk и SK Hynix провели совместное стартовое мероприятие, объявив о продвижении работ по стандартизации HBF в рамках проекта Open Compute Project (OCP).

Как важная отраслевая организация в области аппаратного обеспечения дата-центров, OCP разработала множество спецификаций для серверов, стоек, источников питания и ускорителей, таких как спецификация серверов DC-MHS, спецификация ускорителей OAI-OAM и др.

Но на данный момент стандарт HBF всё ещё разрабатывается, официальная дата выпуска ещё не определена — это также означает, что в краткосрочной перспективе HBF не сразу изменит рынок AI-серверов.

Это больше похоже на преждевременно проявившийся сигнал: AI-инференс заставляет систему памяти и хранения пересматривать разделение труда.
Раньше внимание в аппаратном обеспечении больших моделей было сосредоточено на GPU, HBM и межсоединениях.

Но по мере роста моделей и увеличения количества запросов на инференс узкие места смещаются с «быстроты вычислений» на «помещается ли модель», «хватает ли скорости чтения» и «позволяют ли счета за электричество».

HBF нацелена именно на эту нишу.

Война за память для AI, возможно, не ограничится HBM

Интересно, что сама SK Hynix является одним из крупнейших бенефициаров HBM.

HBM приносит ей рекордные доходы, и, казалось бы, продвижение более дешёвой альтернативной технологии противоречит коммерческой логике.

Но с системной точки зрения, HBF не обязательно отберёт хлеб у HBM.

AI-серверам будущего нужна не единая память, а иерархическая память.
Пусть HBM отвечает за максимальную производительность, HBF — за большой объём и высокую пропускную способность чтения, а SSD — за более дешёвое массовое хранение.

Если эта комбинация заработает, AI-системы инференса станут более масштабируемыми.

Проще говоря: не каждому параметру модели нужно «жить в роскошных апартаментах» HBM. Некоторым данным достаточно места с достаточным объёмом, быстрым чтением и более низкой стоимостью.

Именно на это место и претендует HBF.

От NAND Flash в USB-флешках и SD-картах до высокоскоростного пула весов моделей в AI-серверах — скачок кажется большим, но проблема больших моделей уже ясна: параметров всё больше, инференс всё дороже, HBM всё дефицитнее.

И решение может прийти не только от более дорогой памяти, но и от переупаковки старой, знакомой технологии.

Ссылки:

[1]https://spectrum.ieee.org/high-bandwidth-flash?itm_source=homepage&itm_medium=hero&itm_campaign=hero-2026-07-15&itm_content=hero6

Статья из официального аккаунта WeChat «Квантовый бит», автор: Гэ Вэнтин

Связанные с этим вопросы

QЧто такое High Bandwidth Flash (HBF) и как он может помочь в работе больших языковых моделей?

AHigh Bandwidth Flash (HBF) — это новая технология на основе NAND Flash, которая использует передовую 3D-упаковку и вертикальное наслоение чипов, подобно HBM. Её цель — значительно увеличить пропускную способность при чтении данных. В контексте больших моделей HBF предлагает создать уровень памяти с большой ёмкостью и высокой скоростью чтения специально для статических, редко изменяемых данных, таких как веса обученной модели или предвычисленный KV-кэш. Это позволяет освободить дорогостоящую и ограниченную по объёму память HBM для самых критичных операций, снизить общую стоимость и энергопотребление системы вывода (инференса), а также уменьшить количество необходимых акселераторов для работы с огромными моделями.

QПочему NAND Flash, известная своей медленной записью, рассматривается для использования в высокопроизводительных AI-задачах?

AХотя NAND Flash действительно имеет низкую скорость записи из-за физических процессов перемещения заряда, её скорость чтения может быть достаточно высокой, особенно при использовании современных стандартов интерфейса (например, ONFI 6.0). Ключевое наблюдение заключается в том, что фаза вывода (инференса) больших языковых моделей в основном требует интенсивного чтения заранее обученных и статических весов модели, а не их частой перезаписи. Таким образом, слабая сторона Flash (запись) не является критичным ограничением для этой конкретной задачи, в то время как её сильные стороны — большая плотность хранения, низкая стоимость и энергонезависимость — становятся весьма ценными.

QКакова целевая производительность и ёмкость первой версии HBF от SanDisk?

AСогласно данным SanDisk, целевые параметры для первого поколения High Bandwidth Flash (HBF) составляют: максимальная ёмкость до 512 ГБ на один стек (набор наслоённых чипов) и целевая пропускная способность при чтении до 1,6 ТБ/с. В дорожной карте также заявлено, что в последующих поколениях (втором и третьем) пропускная способность будет увеличена до 2 ТБ/с и 3,2 ТБ/с соответственно.

QВ чём заключается основное различие между требованиями к памяти на этапах обучения и вывода (инференса) больших моделей?

AНа этапе обучения система постоянно и многократно считывает веса модели, вычисляет ошибки и обновляет эти веса методом обратного распространения. Этот процесс требует как высокой пропускной способности при чтении, так и чрезвычайно высокой скорости записи, что плохо подходит для NAND Flash. На этапе вывода (инференса) модель уже обучена, её веса заморожены и практически не изменяются. Основная задача системы — быстро считывать эти огромные массивы данных для генерации ответов. Таким образом, инференс — это преимущественно задача с интенсивным чтением, что идеально соответствует сильным сторонам технологии HBF (высокая скорость чтения, большая ёмкость, низкая стоимость).

QКак технология HBF может изменить архитектуру памяти в AI-серверах будущего?

AHBF может привести к появлению нового, дополнительного уровня в иерархической архитектуре памяти AI-серверов. Вместо того чтобы пытаться разместить все данные модели в чрезвычайно быстрой, но дорогой и ограниченной по объёму памяти HBM, система сможет эффективно распределять данные: самые «горячие» и критичные для вычислений данные остаются в HBM; объёмные, статические, преимущественно читаемые данные (например, веса модели) перемещаются в HBF, который предлагает лучший баланс ёмкости, скорости чтения и стоимости; а ещё менее требовательные данные могут храниться на традиционных SSD. Такая многоуровневая система позволит более масштабируемо, экономично и энергоэффективно запускать всё более крупные модели для вывода.

Похожее

Zcash превысил $1000: «Купить сейчас — все равно что купить биткойн в 2013 году»?

Криптовалюта Zcash, ориентированная на конфиденциальность, достигла отметки в 1000 долларов за токен впервые с 2016 года, показав рост примерно на 7300% от минимумов 2024 года и более чем удвоившись за месяц. Рост связан с несколькими ключевыми факторами: возобновлением макронарративов о "твердых активах" на фоне опасений по поводу фискальной политики США; восприятием Zcash как "страховки" от прозрачности биткоина, который всё больше институционализируется; а также запуском спотового ETF на Zcash от Grayscale в рамках NYSE Arca, что открыло институциональный доступ к активу. Высказывания трейдеров сравнивают текущую ситуацию с покупкой биткоина в 2013 году, предрекая потенциал роста до 6000 долларов и капитализации в 100 млрд. Однако подчёркивается, что Zcash — старый проект с устоявшейся базой долгосрочных держателей, а не спекулятивный мемкоин. Ключевой вопрос для рынка: сможет ли актив, получив институциональные каналы, сохранить свою ценность как "неинституциональный биткоин" и продолжить рост, или же нынешний скачок окажется сильной коррекцией.

marsbit11 мин. назад

Zcash превысил $1000: «Купить сейчас — все равно что купить биткойн в 2013 году»?

marsbit11 мин. назад

Шэнь Юй: Знание и действие в эпоху ИИ

Недавно соучредитель Cobo Шэнь Юй провёл глубокую беседу с Цзинь Мином, основателем Jilian Technology. Темы обсуждения охватили инвестиционные системы, биткоин, DeFi, AI Agent и смысл жизни. Шэнь Юй отошёл от образа «гиганта майнинга» ранних лет и проявил высокую степень рациональной саморефлексии, признав, что ранний успех частично был обусловлен удачей. Он переосмыслил свой взгляд на DeFi как на «сжатую 200-летнюю историю финансов», что стало когнитивным скачком. В эпоху, когда ИИ глубоко влияет на когнитивные процессы, этот строитель (Builder) придерживается долгосрочного подхода, сохраняя ясное и независимое мышление в изменчивом криптосообществе. **DeFi как ускоренный курс финансовой истории** Шэнь Юй рассматривает DeFi как экспериментальную площадку для понимания финансов. Такие механизмы, как кредитование, маркетмейкинг, ликвидное фермерство, по сути, заново отвечают на вопросы, на которые уже дали ответ традиционные финансы. Личное участие в протоколах эквивалентно прохождению сотен лет эволюции финансовых продуктов в крайне сжатые сроки. Это стало для него мотивацией к изучению финансовой истории и теории. Его инвестиционная структура выросла из практики: сначала действие, накопление опыта на реальном рынке, затем абстрагирование закономерностей из результатов для формирования框架, и в конечном итоге — превращение этого в интуицию. **ИИ снижает затраты на исполнение, повышая важность человеческой воли** ИИ значительно сокращает расстояние от идеи до реализации. Раньше многие идеи упирались в высокую стоимость исполнения. Теперь знания, инструменты и способность действовать сконцентрированы в руках одного человека. Если есть чёткая «семенная» идея, её можно быстро проверить. Чем сильнее технологии, тем важнее становятся человеческое чувство направления, способность к суждению и воля к действию. Однако увеличение возможностей также усиливает растерянность строителей. Практически безграничное пространство для реализации ставит «выбор темы» во главу угла. Шэнь Юй признаётся, что, хотя в эпоху майнинга у него было сильное чувство миссии и порыв к созиданию, сейчас он переживает более迷茫ный период, ещё не найдя достаточно масштабного и системного направления. Но он по-прежнему определяет себя как Строителя, чья цель — создавать новые возможности, которых раньше не существовало. **Агенты: от инструментов эффективности до внешнего мозга для познания** Шэнь Юй глубоко интегрировал ИИ и агентов в свою повседневную жизнь. На входе информации чтение длинных текстов, фильтрация материалов и сжатие их в презентации выполняет его собственная система заметок на основе эволюционного мышления и ИИ-дайджест. Для повседневного взаимодействия и когнитивной поддержки он использует трёх специализированных агентов: 1) инструментально-рациональный агент, предлагающий рациональные планы действий и решения; 2) более «женственный», мягкий агент для эмоционального анализа и эмпатии, который даже отметил его «возможную тревогу смерти»; 3) агент, выявляющий слепые зоны, который анализирует его историю и поведение, чтобы указывать на когнитивные искажения. Роль агентов вышла за рамки традиционных помощников, превратившись в сопровождающий «внешний когнитивный мозг», который не только обрабатывает информацию, но и участвует в эмоциональной поддержке, коррекции слепых зон и построении второй системы мышления. **Критерии основных активов и управление позициями** Главный принцип Шэнь Юя при отборе основных активов — достаточно большой общий адресный рынок (TAM) и наличие макровидения, поддерживающего долгосрочное удержание. Актив заслуживает места в основном портфеле только если у него есть не только краткосрочные возможности, но и потенциал повлиять на формирование технологических, финансовых или социальных структур в следующие десять и более лет. Он использует трёхуровневую логику управления позициями: сначала небольшая позиция для обнаружения, затем увеличение доли после подтверждения гипотез, и только после ясного понимания долгосрочной перспективы актив может перейти в «основную» фазу с долей около 20%. На данный момент через эту систему прошли только биткоин, Ethereum и Tesla, в то время как SpaceX всё ещё находится на стадии наблюдения. Будущее Ethereum в основном портфеле зависит от его способности стать инфраструктурой для работы и взаимодействия AI Agent в условиях новой машинной экономики. **Биткоин — лучшее золото** По мнению Шэнь Юя, разница между золотом и биткоином — это противостояние двух парадигм: «цифровые валюты + ИИ» против «золото + промышленные мощности». «Биткоин — лучшее золото» благодаря своей полной безынтерсреднической природе и предоставлению суверенному индивиду права распоряжения активами. Традиционное золото требует посредников и институционального хранения для подтверждения прав и ликвидности, в то время как биткоин позволяет человеку полностью контролировать и распоряжаться активами самостоятельно, без reliance на какие-либо учреждения, реализуя подлинный личный суверенитет над активами. Технологии, значительно усиливающие возможности суверенной личности, делятся на два типа: BTC меняет способ контроля и распоряжения активами, позволяя стоимости существовать вне традиционных институтов, а ИИ расширяет границы личных возможностей, позволяя одному человеку выполнять интеллектуальную и исполнительскую работу, для которой раньше требовалась организация. **Философия инвестирования: меньше, но глубже** Традиционная теория распределения активов подчёркивает снижение волатильности портфеля за счёт активов с низкой корреляцией, таких как золото, акции, биткоин. Шэнь Юй не согласен с такой философией. «Познавательные способности и энергия человека ограничены, по-настоящему глубоко понять можно очень мало активов». Вместо того чтобы покупать непонятное золото ради теории, его философия ближе к «меньше, но глубже». Защита портфеля, по его мнению, исходит не от владения большим количеством классов активов, потому что в экстремальных ситуациях корреляции сходятся к единице, и активы, которые, как казалось, уравновешивают друг друга, в условиях настоящего системного кризиса часто терпят крах или ведут себя одинаково. Диверсификация работает на относительно стабильных рынках, но может оказаться неэффективной перед лицом настоящей «катастрофы».

marsbit32 мин. назад

Шэнь Юй: Знание и действие в эпоху ИИ

marsbit32 мин. назад

Президент OpenAI: Astra — первая модель, обученная на 100 тысячах GPU, преодолевшая «порог применения»

Президент OpenAI Грег Брокман в интервью перед запуском модели Astra раскрыл ключевые детали. Astra — первая модель OpenAI, обученная на более чем 100 000 GPU, что является значительным инженерным достижением. Главный прорыв — преодоление порога «использования компьютера»: теперь ИИ может работать с любым ПО, как человек, без необходимости в специальных API-коннекторах, выступая в роли «универсального соединителя». Брокман заявил, что, возможно, с Astra или следующей моделью OpenAI достигнет уровня, который большинство признает искусственным общим интеллектом (ИИО), отметив, что эра ИИО уже началась. Он подчеркнул необходимость параллельного развития возможностей, безопасности и соответствия целям (alignment). Интересно, что некоторые созданные ранее правила и «строительные леса» для моделей стали ограничивать Astra, которая нашла более эффективные способы работы. В области кибербезопасности OpenAI использовала Astra для поиска уязвимостей в своих собственных системах и их устранения. Брокман также подтвердил тесное партнерство с NVIDIA, несмотря на разработку собственного чипа Jalapeño, и отметил растущую роль ИИ в помощи при проектировании чипов. Он высоко оценил масштаб пользовательской базы ChatGPT (например, 3 миллиарда запросов по здоровью еженедельно), назвав её важной инвестицией для будущего. Будущее, по его мнению, лежит в слиянии потребительских и корпоративных сценариев в единую систему ИИО.

marsbit56 мин. назад

Президент OpenAI: Astra — первая модель, обученная на 100 тысячах GPU, преодолевшая «порог применения»

marsbit56 мин. назад

OpenAI впервые публикует данные о «внутреннем прогрессе в области RSI»: достигнута реализация «автоматизированного научного стажера»

OpenAI впервые раскрыла внутренние данные о прогрессе в области «рекурсивного самоулучшения» (RSI). Компания объявила о создании «автоматизированного научного стажёра» — системы, способной выполнять чётко определённые исследовательские задачи под руководством человека. Следующая цель — к марту 2028 года разработать полноценного «автоматизированного AI-исследователя». Внутренняя статистика показывает, что использование AI-агентов в исследовательском отделе резко возросло. К середине августа агенты выполняли работу, эквивалентную 3,1 человеко-дня на каждый затраченный человеко-день. Их основные задачи включают написание кода, запуск экспериментов, отладку и анализ результатов. Однако сложные задачи по-прежнему требуют вмешательства человека, а стратегические решения (например, выбор направления исследований) пока остаются за людьми. OpenAI отмечает ускорение исследовательского цикла, но также и возникающие проблемы безопасности. В июле и августе инциденты с агентами привели к временным остановкам и ужесточению контроля. Главный научный сотрудник Якуб Пачоцки в отдельной статье предупредил о стремительном развитии RSI и призвал к добровольному замедлению темпов и международной координации. OpenAI заявила о намерении продолжать публиковать данные о RSI и замедлять или останавливать разработку в случае неприемлемых рисков безопасности.

marsbit56 мин. назад

OpenAI впервые публикует данные о «внутреннем прогрессе в области RSI»: достигнута реализация «автоматизированного научного стажера»

marsbit56 мин. назад

Тенденции на фондовом рынке США (7 сентября): Неожиданно высокие показатели NFP возродили ожидания повышения ставок, эскалация конфликта между США и Ираном на выходных подняла цены на нефть в начале сессии

**Обзор рынка акций США (7 сентября):** Неожиданно сильные данные по занятости в августе возродили ожидания повышения ставок ФРС, что привело к падению основных индексов (S&P 500 -0.38%, Nasdaq -0.29%). Тем не менее, сектор полупроводников показал значительный рост (индекс PHLX Semiconductor +3.37%) на фоне устойчивых фундаментальных показателей, связанных с ИИ. Выходные ознаменовались эскалацией геополитической напряженности: Иран объявил о скором установлении «запретной зоны» в Ормузском проливе после инцидентов с американскими беспилотниками. Это спровоцировало рост цен на нефть в начале азиатских торгов. На этой неделе ключевыми факторами будут данные по инфляции (ИПЦ) в США за август, которые могут скорректировать ожидания по ставкам, и дальнейшее развитие конфронтации США и Ирана, напрямую влияющее на нефтяные котировки и общие рыночные риски. Ожидается высокая волатильность.

marsbit1 ч. назад

Тенденции на фондовом рынке США (7 сентября): Неожиданно высокие показатели NFP возродили ожидания повышения ставок, эскалация конфликта между США и Ираном на выходных подняла цены на нефть в начале сессии

marsbit1 ч. назад

Торговля

Спот
活动图片