Dalam beberapa tahun terakhir, model generasi video telah berkembang pesat dalam hal kejernihan, konsistensi temporal, dan kemampuan kendali. Dengan diberikan teks, gambar, lintasan kamera, atau gerakan pemain, model kini mampu menyintesis adegan lanjutan yang koheren, membuat konsep "dunia video interaktif" perlahan-lahan beralih dari konsep menjadi prototipe yang dapat ditonton dan dioperasikan.
Namun, mampu melanjutkan adegan tidak sama dengan mampu menjalankan sebuah dunia. Perpindahan dan tabrakan dalam bidikan kamera hanyalah lapisan interaksi yang paling intuitif; di lingkungan yang lebih kompleks, karakter memiliki tujuan, identitas, dan hubungan, peristiwa dibatasi oleh aturan, dan juga meninggalkan konsekuensi kausal yang melintasi waktu yang lebih lama. Banyak keadaan bahkan terjadi di luar bidikan kamera, namun tetap dapat mengubah alur cerita dan tindakan selanjutnya. Hanya dengan memprediksi pengamatan berikutnya berdasarkan piksel lokal, sangat sulit untuk secara eksplisit mempertahankan semantik tingkat tinggi ini.
Dunia yang kompleks pertama-tama membutuhkan "pemahaman mengapa". Tujuan, aturan, memori, dan rantai kausal biasanya tidak dapat langsung dibaca dari frame saat ini, namun hal-hal inilah yang menentukan bagaimana dunia harus berubah selanjutnya. Kemampuan model bahasa dalam memanggil pengetahuan, bernalar, merencanakan, dan memprogram cocok untuk menangani keputusan dengan frekuensi rendah namun kompleksitas tinggi ini, dan selanjutnya menerjemahkan keputusan tersebut menjadi aturan yang dapat dieksekusi.
Fakta lain yang sering diabaikan adalah: video game bukanlah dunia itu sendiri, melainkan proyeksi piksel dari hasil eksekusi program yang dirender. Saat ini, game dan simulator masih menjadi sumber data interaktif utama untuk model dunia video. Jika hanya menyimpan tindakan dan piksel, lalu meminta model video langsung mempelajari pemetaan di antara keduanya, sama saja dengan melewati program, aturan, dan world state eksplisit yang sudah ada, dan malah meminta model untuk membalik-fit seluruh perilaku program dari hasil visual. Jalur pembelajaran seperti ini tidak hanya tidak efisien, tetapi juga menggabungkan "bagaimana dunia berkembang" dan "bagaimana dunia ditampilkan" ke dalam model yang sama.
Berdasarkan pengamatan ini, tim peneliti dari Laboratorium AGI Universitas West Lake dan Universitas Teknologi Nanyang mengusulkan Code World Model, sebuah paradigma model dunia baru yang menggunakan model bahasa sebagai "otak". Inti dari gagasan ini adalah membiarkan coding agent terus-menerus menulis, memanggil, dan memodifikasi kode untuk memelihara dan memperbarui world state yang dapat dieksekusi; state yang relevan dengan pengamatan saat ini kemudian dikonversi menjadi proxy untuk memandu model video dalam menghasilkan gambar visual yang detail.
Tautan makalah:https://arxiv.org/abs/2608.25927
Halaman proyek:https://buaacyw.github.io/cwm/
Repositori kode:https://github.com/buaacyw/code-world-model
Model bahasa di sini tidak menggantikan model video. Code World Model membagi kembali tanggung jawab keduanya: pengetahuan, tujuan, aturan, dan kausalitas jangka panjang menjadi tanggung jawab coding agent dan kode, sedangkan penampakan, detail gerakan, pencahayaan, dan tekstur menjadi tanggung jawab model video. Dengan kata lain, yang pertama menentukan apa yang terjadi di dunia, yang terakhir menentukan bagaimana semua itu terlihat.
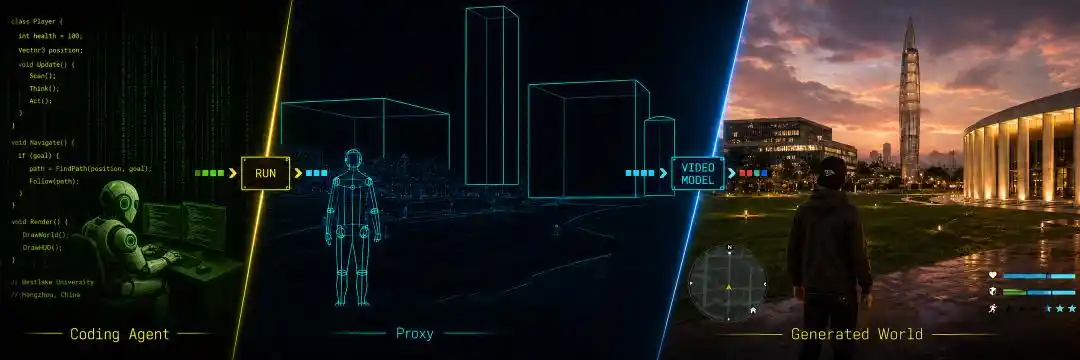
Gambar 1 Pembagian tugas inti Code World Model: coding agent mengembangkan world state melalui kode, proxy mengubah state yang relevan menjadi kondisi visual, model video menghasilkan gambar akhir.
Ikhtisar Metode
Sejalan dengan pembagian tugas di atas, Code World Model membagi proses berjalannya dunia menjadi tiga bagian yang saling terkait.
coding agent: Memahami maksud pemain dan peristiwa baru, memanggil pengetahuan dunia, menalar konsekuensi potensial, dan memutuskan mekanisme mana yang perlu dieksekusi, dikombinasikan, atau dimodifikasi.
kode: Menjalankan pembaruan deterministik seperti posisi, atribut, tabrakan, cooldown, dan pemicu peristiwa dengan frekuensi lebih tinggi, mengubah keputusan tingkat tinggi menjadi aturan yang dapat diperiksa, digunakan kembali, dan dijalankan secara berkelanjutan.
model video: Membaca kondisi state yang telah berkembang, memanfaatkan prioritas penampakan, gerakan, dan interaksi yang dipelajari dari data visual skala besar, untuk menghasilkan pengamatan visual dengan tekstur, pencahayaan, dan dinamika lokal yang kaya.
Pembagian tugas ini juga sesuai dengan frekuensi komputasi yang berbeda. Coding agent hanya perlu membuat keputusan jarang ketika muncul tujuan baru, peristiwa kompleks, atau mekanisme yang ada tidak memadai; begitu keputusan ditulis ke dalam kode, program dapat terus melakukan pembaruan state yang padat.
Yang lebih penting, coding agent tidak hanya mengubah nilai pada saat tertentu, tetapi juga dapat mengubah cara dunia berjalan setelahnya.
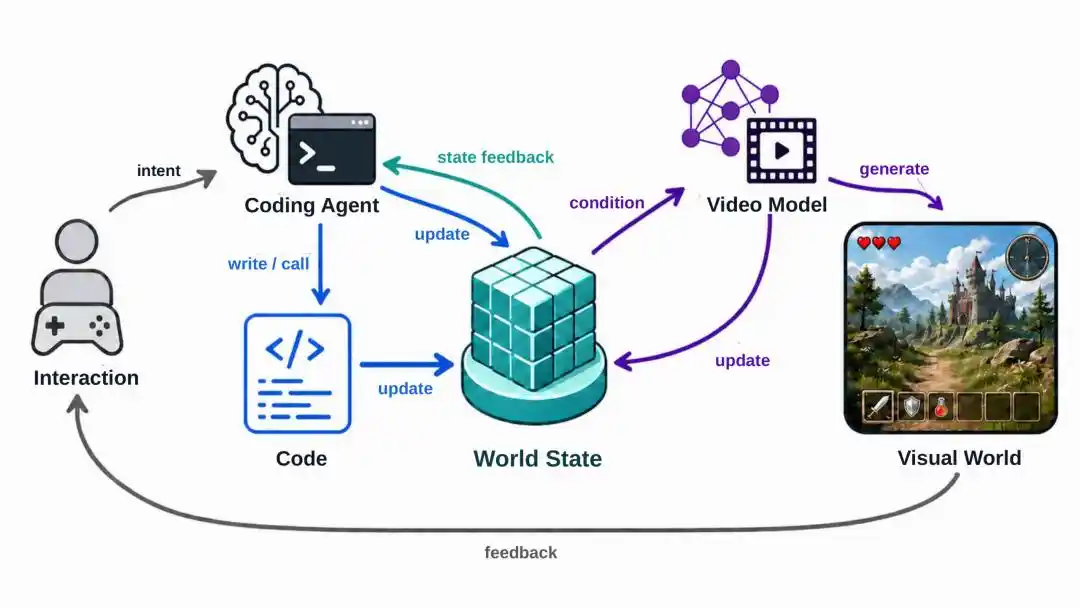
Gambar 2 Kerangka keseluruhan Code World Model. Konsep lengkap mencakup umpan balik visual; prototipe saat ini fokus memvalidasi jalur maju coding agent / code → world state → proxy → video model.
Proxy Menghubungkan State yang Dapat Dieksekusi dengan Generasi Video
Setelah pembagian tugas selesai, masih ada masalah antarmuka kunci: coding agent dan kode memelihara state yang dapat dieksekusi, sementara model video menerima token teks, gambar, atau video. Di antara keduanya dibutuhkan bahasa bersama yang mudah dibangun oleh program dan sekaligus mampu memberikan kendala spasial per-frame.
Teks terstruktur cukup fleksibel, tetapi sulit untuk secara stabil menggambarkan posisi entitas, hubungan relatif, lintasan gerakan, dan perubahan kamera yang tepat di setiap frame; membangun dan merender dunia 3D penuh meskipun memberikan kendali lebih kuat, akan kembali memperkenalkan biaya tinggi dari aset, geometri, material, animasi, dan pipeline rendering.
Untuk itu, penelitian ini memperkenalkan proxy. Proxy mengekstrak informasi yang benar-benar perlu diikuti oleh pengamatan saat ini dari world state, dan mengorganisasikannya menjadi representasi visual berbutir kasar. Kompiler yang ringan dan deterministik merender proxy menjadi proxy video, yang kemudian dikirim bersama teks terstruktur ke model video.
Teks bertanggung jawab menjelaskan "siapa, apa, ingin melakukan apa", sementara proxy menentukan "di mana, bagaimana bergerak, bagaimana kamera merekam".
Proxy dapat mengekspresikan kamera dan sudut pandang, posisi dan orientasi entitas, skala dan lintasan, tata letak dan oklusi adegan, serta state berbutir kasar yang diperlukan untuk interaksi saat ini; tekstur, material, pencahayaan halus, dan gerakan lokal penuh sengaja diserahkan kepada model video. Artikel ini meringkas prinsip desain ini sebagai: hanya mempertahankan state minimum yang cukup diperlukan untuk pengamatan saat ini, mencapai keseimbangan antara kemampuan kendali dan biaya encoding state.
Implementasi proxy saat ini hanya memiliki seperempat tinggi dan lebar dari video target, dengan jumlah piksel sekitar 1/16 dari target. Proxy dibentuk dari kombinasi primitif geometris sederhana yang dapat digunakan kembali, tidak memerlukan aset berkualitas produksi, namun mampu menyediakan kerangka spasial-temporal yang dapat diedit per-frame.
Mendapatkan Data yang Selaras Secara Ketat dari Rekaman Runtime Game
Agar model video belajar memahami proxy, sampel pelatihan perlu secara bersamaan mengandung proxy video, teks terstruktur, dan video RGB target, dan proxy serta RGB harus selaras secara ketat dalam hal waktu, kamera, dan identitas entitas.
Rekaman runtime game secara alami mempertahankan korespondensi ini. Tim peneliti merekam secara sinkron RGB, state kamera, identitas entitas, posisi dan orientasi, skala perkiraan, tata letak adegan, dan state interaksi dari satu kali gameplay execution yang sama, kemudian mengompilasi proxy secara offline melalui kode. Karena keduanya berasal dari eksekusi yang sama, setiap frame dapat membangun korespondensi satu-ke-satu, dan identitas lintas frame dapat dipetakan secara stabil.
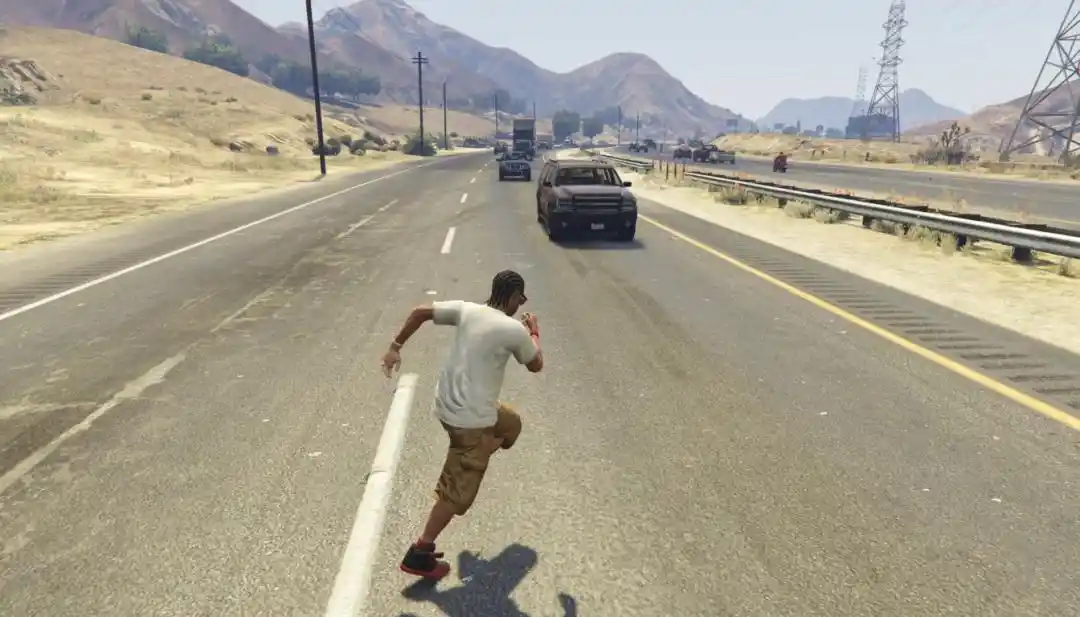
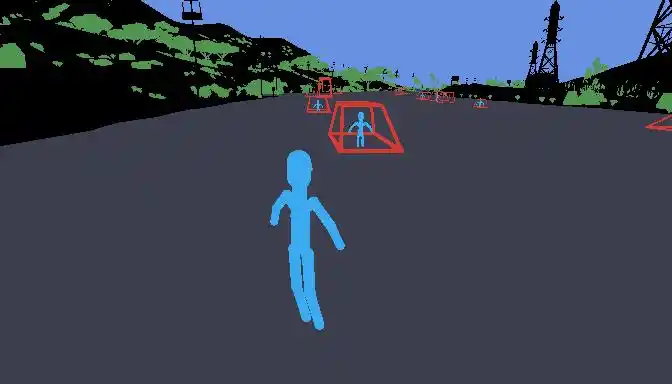
Gambar 3a RGB target dalam data game (atas) dan proxy frame yang sama (bawah).
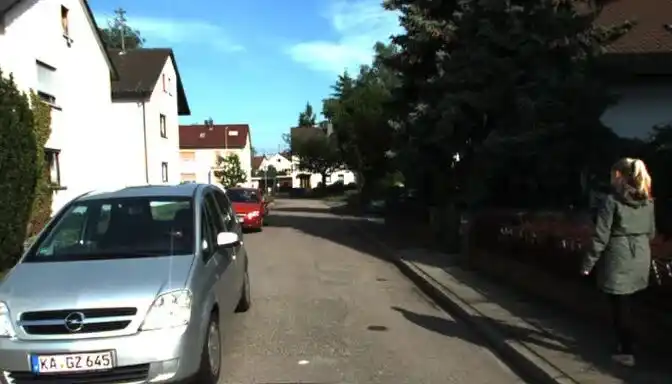
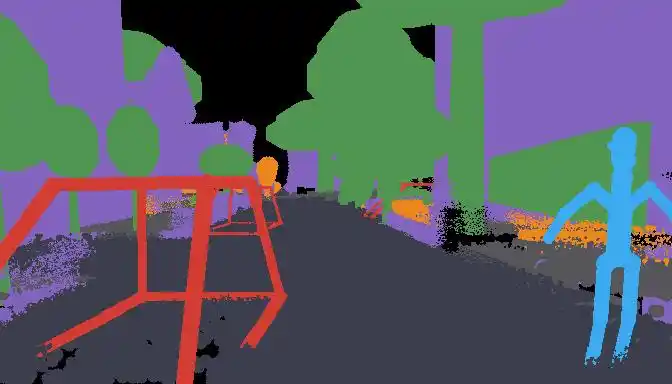
Gambar 3b RGB target dalam video nyata (atas), dan proxy yang dibangun secara offline menggunakan kalibrasi kamera, rekonstruksi 3D, dan anotasi objek (bawah).
Data gameplay yang digunakan dalam makalah mencakup 157 rekaman, total sekitar 5,6 jam video sumber. Tim peneliti mengambil sampel dengan interval 2 detik, menghasilkan 9.420 klip pelatihan berdurasi 5 detik; setiap target RGB berisi 124 frame, dengan resolusi 1344×768, frame rate 24 FPS, proxy yang sesuai juga berisi 124 frame, dengan resolusi 336×192, dikombinasikan dengan fixed-log depth dan categorical semantic-ID map.
Rekaman runtime yang sama juga dapat dikompilasi ulang menjadi proxy dengan cakupan dan granularitas informasi yang berbeda, tanpa perlu merekam ulang RGB.
Makalah ini juga menunjukkan alur pembuatan offline proxy-observation pair untuk video nyata pada KITTI-360, untuk mengilustrasikan kemungkinan perluasan antarmuka ini ke data nyata; adaptasi model video saat ini masih hanya menggunakan data gameplay berpasangan.
Bagaimana Sistem Prototipe Berjalan?
Prototipe saat ini menggunakan backbone Ref2VA dari MiniMax-H3 sebagai model video, melakukan adaptasi LoFA rank-128 pada seluruh 50 transformer block, dengan parameter yang dapat dilatih sekitar 596 juta. Pelatihan menggunakan 8 GPU NVIDIA H800, total menyelesaikan 3 epoch, 3.534 langkah optimisasi.
Tahap inferensi menggunakan GPT-5.6 Sol sebagai coding agent. Sistem memberikan kontrol dasar pemain, penanganan tabrakan, loop pembaruan runtime, template scene game-engine dan gameplay logic yang ada, serta proxy primitive yang digunakan pada tahap pelatihan kepada coding agent. Coding agent dapat menggabungkan, memperluas, dan menulis ulang kode ini, untuk membangun dunia yang sederhana, dapat dieksekusi, dan dapat dikendalikan pemain; geometri 3D berbutir kasar di dalamnya hanya digunakan untuk mengekspresikan proxy, tidak secara langsung berfungsi sebagai gambar akhir.
Untuk setiap klip 5 detik, GPT Image 2 menghasilkan appearance anchor berdasarkan proxy dan teks dari frame pertama; MiniMax-H3 kemudian menggabungkan frame pertama, urutan proxy lengkap, dan teks, untuk menghasilkan video RGB 124 frame, 1344×768, 24 FPS.
Video yang lebih panjang dihasilkan melalui sliding window dengan tumpang tindih 34 frame: window berikutnya mewarisi konteks RGB dari akhir window sebelumnya, dan menggunakan kembali appearance anchor yang sama, untuk menjaga kontinuitas lokal dan penampakan identitas keseluruhan.
Hasil Eksperimen
Hasil kualitatif menunjukkan, meskipun hanya menggunakan sekitar 5,6 jam video sumber gameplay untuk adaptasi LoRA, model tetap mampu mengikuti posisi karakter, lintasan gerakan, tata letak adegan, dan gerakan kamera yang ditentukan proxy, bahkan ketika identitas karakter, lingkungan, dan gaya visualnya menyimpang jelas dari penampakan pelatihan, sambil menambahkan tekstur, pencahayaan, dan dinamika lokal yang kaya.
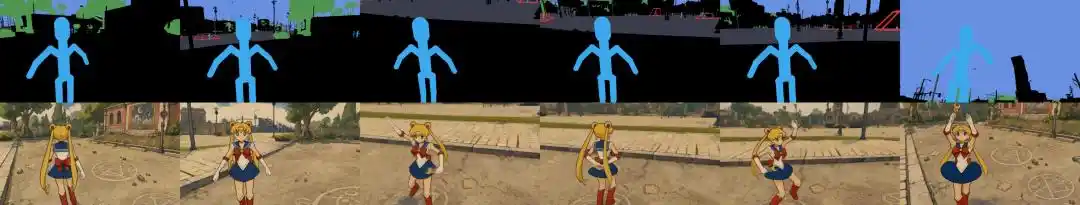
Gambar 4 Proxy memberikan posisi karakter dan lintasan gerakan, model video menyajikan kerangka kasar yang sama sebagai karakter dengan identitas dan gaya seni yang berbeda. Atas: proxy; Bawah: hasil generasi.
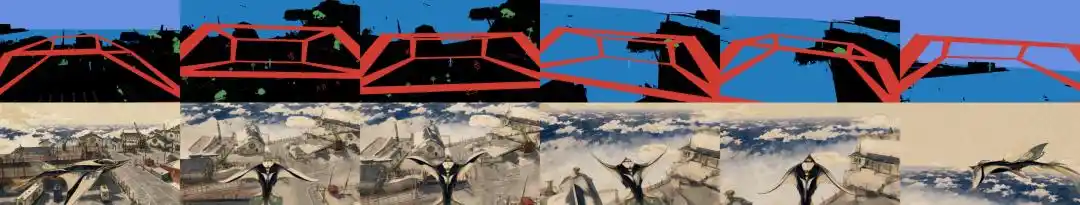
Gambar 5 Primitif geometri sederhana memberlakukan kendala pada objek kompleks dan gerakan kamera. Atas: proxy; Bawah: hasil generasi.
Sebagai contoh, coarse human primitive yang sama dapat disajikan sebagai karakter dengan identitas dan gaya seni yang sama sekali berbeda; wireframe atau kotak dapat membatasi posisi dan pergerakan kasar kendaraan, kapal, dan objek kompleks lainnya; antarmuka proxy yang sama juga mampu mengekspresikan berlari, menari, berenang, jatuh, dan gerakan kamera mengelilingi.
Dari sini dapat dilihat, proxy memperbaiki kerangka spasial-temporal yang harus diikuti oleh pengamatan saat ini, bukan aset dan gaya visual dari game pelatihan.
Halaman proyek juga memberikan perbandingan video dengan model dunia video yang dikondisikan oleh action atau kamera.
Perbandingan ini fokus pada granularitas kendali dan hasil visual: proxy secara langsung memberikan gerakan entitas dan perubahan sudut pandang per-frame, sehingga dapat memberikan kendala spasial-temporal yang lebih halus dan langsung; makalah tidak menyajikan hasil ini sebagai perbandingan latency inferensi.
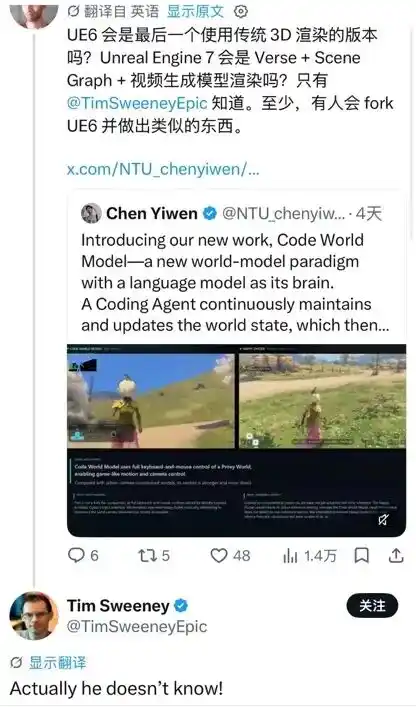
Komentar pengguna mengatakan, "Apakah Unreal Engine 6 akan menjadi mesin terakhir yang membuat game dengan metode 3D tradisional? Mungkin Unreal Engine 7 akan menggunakan skema teknologi serupa. Hanya CEO Unreal Engine Tim yang tahu jawabannya."
Kemudian Tim juga datang untuk melihat dan berkata, "Saya juga tidak tahu!"
Kesimpulan: Pertama Tentukan Apa yang Terjadi di Dunia, Baru Hasilkan Bagaimana Terlihatnya
Model dunia video sebelumnya terutama mempelajari "bagaimana pengamatan berlanjut". Code World Model melangkah lebih maju: sebelum menghasilkan pengamatan berikutnya, pertama-tama pertahankan apa itu dunia saat ini, aturan apa yang diikuti, dan mengapa konsekuensi suatu peristiwa bertahan.
Sebuah dunia generatif yang benar-benar terbuka membutuhkan imajinasi visual dari model video, dan juga mekanisme eksekusi yang dapat mempertahankan pengetahuan, tujuan, aturan, hubungan, dan konsekuensi kausal. Inti Code World Model dapat diringkas menjadi satu kalimat: biarkan kode menentukan apa yang terjadi di dunia, biarkan model video menentukan bagaimana semua itu terlihat.
Referensi:https://arxiv.org/abs/2608.25927
Artikel ini berasal dari akun WeChat publik "新智元", penulis: 新智元; editor: LRST