Seiring dengan perkembangan Office AI dan agen dokumen cerdas, model-model besar mulai langsung menangani materi panjang berbasis gambar dan teks seperti laporan keuangan, kontrak, dan laporan penelitian.
Namun, kemampuan menerima seluruh dokumen, tidak sama dengan kemampuan menggunakan informasi di dalamnya dengan benar.
Menghadapi ratusan halaman teks, gambar, tabel, dan bagan, pertanyaan pertama yang harus dijawab model adalah: Bukti yang benar-benar relevan dengan pertanyaan saat ini, sebenarnya ada di mana?
Karya baru yang diterima di EMNLP 2026, “Can Retrieval Heads See Images? Multimodal Retrieval Heads in Long-Context Vision-Language Models”, mempelajari proses ini dari dalam model.
Dari "Dapat Menampung" ke "Dapat Menemukan"
Model bahasa-vision konteks panjang dapat menerima sejumlah besar teks dan gambar sekaligus, tetapi jawaban akhir biasanya hanya bergantung pada sebagian kecil informasi di dalamnya. Bukti yang relevan mungkin berupa segmen teks, atau mungkin tersembunyi di tabel, gambar, atau area tata letak tertentu.
Pertanyaan yang menjadi fokus tim peneliti adalah: Ketika bukti sudah muncul dalam input, apakah di dalam model ada sekelompok kepala perhatian (attention head) yang bertanggung jawab untuk mengarahkan pertanyaan ke konten teks atau visual yang relevan?
Tim menyebut kepala perhatian yang diidentifikasi ini sebagai Kepala Pencarian Multimodal (MMRetHeads).
Bagaimana Mengidentifikasi Kepala Pencarian Multimodal?
Terinspirasi oleh QRHead, tim peneliti mengusulkan metode deteksi MMRetHeads.
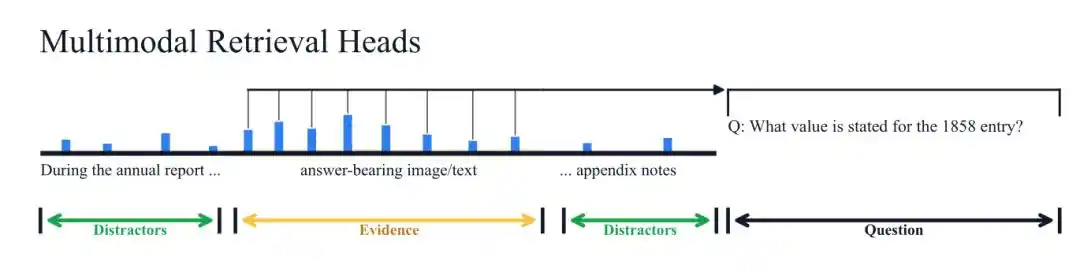
Secara spesifik, metode ini menganalisis attention dari pertanyaan-ke-bukti (question-to-evidence attention) untuk setiap kepala perhatian, yaitu perhatian dari token pertanyaan yang menunjuk ke area bukti yang diberi label. Bukti jika berupa teks, sesuai dengan token teks; jika bukti terletak dalam gambar, sesuai dengan token visual. Semakin kuat perhatian yang menunjuk ke bukti, semakin tinggi skor pencarian kepala perhatian tersebut.
△
Penelitian mencakup 6 model bahasa-vision konteks panjang seperti Qwen3-VL, Gemma3, termasuk tugas pencarian teks, pencarian gambar, pencarian teks render, dan pencarian gambar identik, serta menguji panjang konteks 8K, 16K, 32K, 64K, dan 128K.
Analisis juga menemukan bahwa pencarian teks dan gambar berbagi sebagian kepala perhatian, tetapi konteks panjang dan bentuk bukti yang berbeda juga memanggil kepala perhatian yang berbeda.
Apakah Kepala Perhatian Ini Benar-Benar Mempengaruhi Jawaban Model?
Perhatian yang mengarah ke bukti hanya menunjukkan adanya hubungan antara keduanya. Untuk menguji apakah model benar-benar bergantung pada kepala-kepala ini, tim peneliti memblokir kepala pencarian dengan skor tinggi, kemudian membandingkan hasilnya dengan hasil memblokir jumlah kepala perhatian acak yang sama.
Dalam tugas pencarian teks dan gambar, setelah kepala pencarian diblokir, kinerja model menurun secara signifikan di berbagai panjang konteks dan posisi bukti; pemblokiran acak menyebabkan dampak yang jauh lebih kecil.
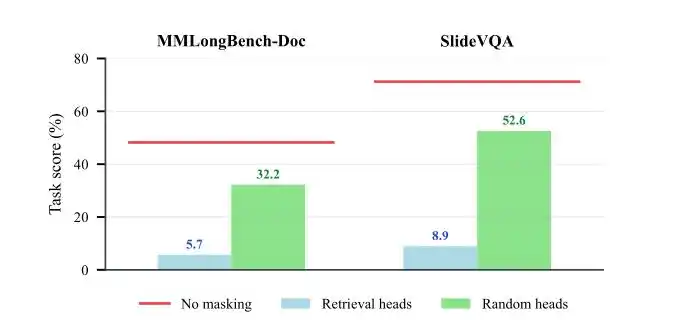
Perbedaan serupa juga muncul dalam Tanya Jawab Dokumen Panjang yang lebih realistis:
- MMLongBench-Doc:48.2→5.7
- SlideVQA: 71.2→8.9
Setelah pemblokiran acak, kedua tugas masing-masing tetap mempertahankan skor 32.2 dan 52.6. Penurunan yang disebabkan oleh pemblokiran kepala pencarian jelas lebih besar, menunjukkan bahwa kepala-kepala ini tidak hanya menempatkan perhatian di dekat bukti, tetapi juga memiliki peran kausal dalam akses model terhadap bukti.
Hasil serupa juga dapat diamati dalam tugas penalaran multimodal. Setelah kepala pencarian diblokir, model terkadang menjawab "informasi tidak cukup" meskipun bagan masih ada dalam input, atau mungkin membaca konten yang salah atau menghasilkan dasar yang tidak ada.
△
Dari Mekanisme Internal ke Pencarian Dokumen
Tim peneliti selanjutnya menggunakan sinyal bukti dari kepala perhatian ini untuk pencarian dokumen multimodal.
Dengan pertanyaan yang diberikan, MMRetHeads akan menghitung skor relevansi untuk kandidat halaman atau area tata letak, dan mengurutkan kandidat berdasarkan itu. Pencarian tingkat halaman mencari halaman utuh yang mengandung bukti, sedangkan pencarian tingkat tata letak lebih lanjut melokalisasi blok teks, tabel, gambar, atau bagan dalam halaman. Seluruh proses tidak memerlukan pelatihan pencari (retriever) tambahan.
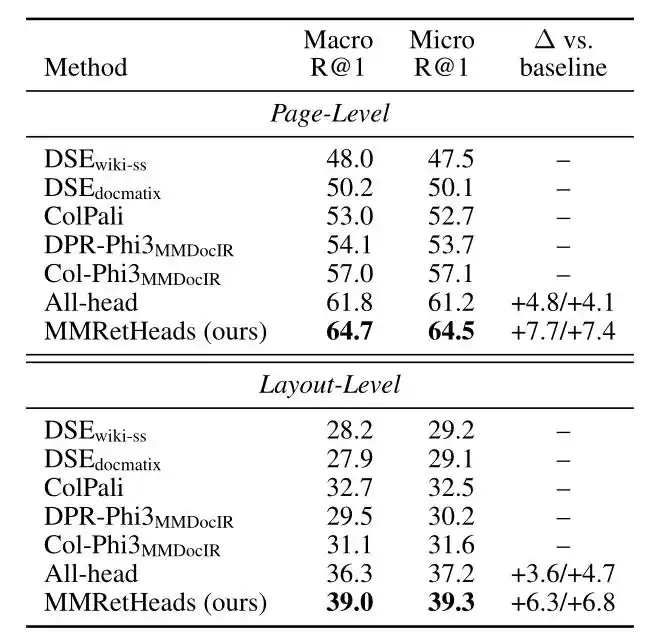
Pada MMDocIR, Recall@1 tingkat halaman Qwen3-VL-8B mencapai 64.7, meningkat 7.7 poin persentase dibandingkan baseline terkuat yang dilaporkan; Recall@1 tingkat tata letak mencapai 39.0, meningkat 6.3 poin persentase dibandingkan baseline terkuat yang dilaporkan.
△
Tautan makalah: https://arxiv.org/abs/2605.27243
Artikel ini berasal dari akun WeChat publik "量子位", penulis: Tim MMRetHeads