Resmi, OpenAI Menghentikan Model Tercepat dalam Sejarah

marsbitDipublikasikan tanggal 2026-09-13Terakhir diperbarui pada 2026-09-13

Abstrak

OpenAI mengumumkan penghentian model GPT-5.3-Codex-Spark, model tercepat mereka yang pernah ada, hanya tujuh bulan setelah diluncurkan. Model ini menghasilkan 1.200 token per detik dan merupakan model produksi pertama OpenAI yang tidak bergantung pada perangkat keras Nvidia, didukung oleh chip Cerebras WSE-3. Namun, penggunaannya terus menurun karena masalah akurasi. Dalam pengujian, akurasinya jauh lebih rendah (58,4%) dibandingkan model lengkap GPT-5.3-Codex (77,3%). Banyak pengembang mengeluh bahwa model ini "sangat buruk dan tidak dapat digunakan," sering menghasilkan kode yang salah atau konteks yang penuh bug. Spark pada dasarnya adalah model yang dikompromikan untuk kecepatan ekstrem. Keberadaannya menjadi usang dengan peluncuran mode "Ultrafast" oleh Cerebras pada Agustus, yang menjalankan model flagship GPT-5.6 Sol secara utuh dengan kecepatan 750 token per detik tanpa mengorbankan kecerdasan. Peristiwa ini menandai pergeseran strategi OpenAI, di mana kecepatan bukan lagi produk model khusus, melainkan menjadi tingkat layanan berbayar yang dapat dipilih pada model utama. Spark berhasil membuktikan kelayakan arsitektur Cerebras, namun kini waktunya telah berakhir seiring fokus beralih ke menjalankan model paling canggih dengan kecepatan maksimal.

Model tercepat dalam sejarah OpenAI, mati.

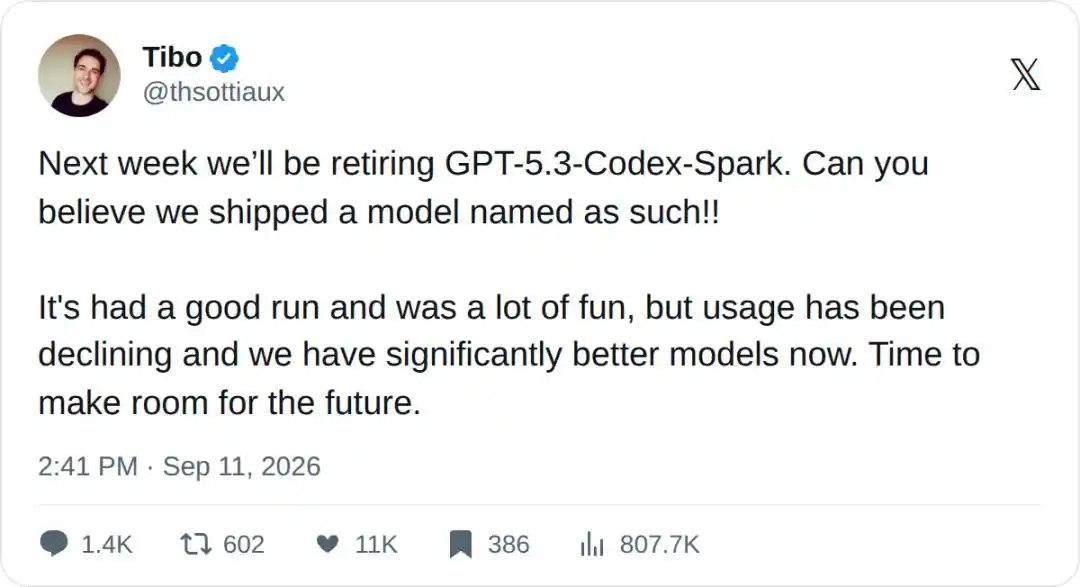
Kepala Codex Tibo memposting, GPT-5.3-Codex-Spark, pensiun minggu depan.

1200 Token per detik, model pertama OpenAI yang lepas dari Nvidia, pengiriman pertama dari pesanan besar Cerebras 750 MW, dari rilis hingga ditutup, hanya hidup selama 7 bulan.

Alasan Tibo sederhana, penggunaan terus menurun, dan mereka sudah punya model yang jelas lebih baik. "Sudah waktunya memberi ruang untuk masa depan."

Kemudian, dia menambahkan lagi di kolom komentar, "Tidak percaya, kami pernah merilis model dengan nama sepanjang ini!!"
Di upacara perpisahan, semua orang hanya peduli 'kuota cadangan'

Spark pergi dengan tenang, bahkan terasa canggung.

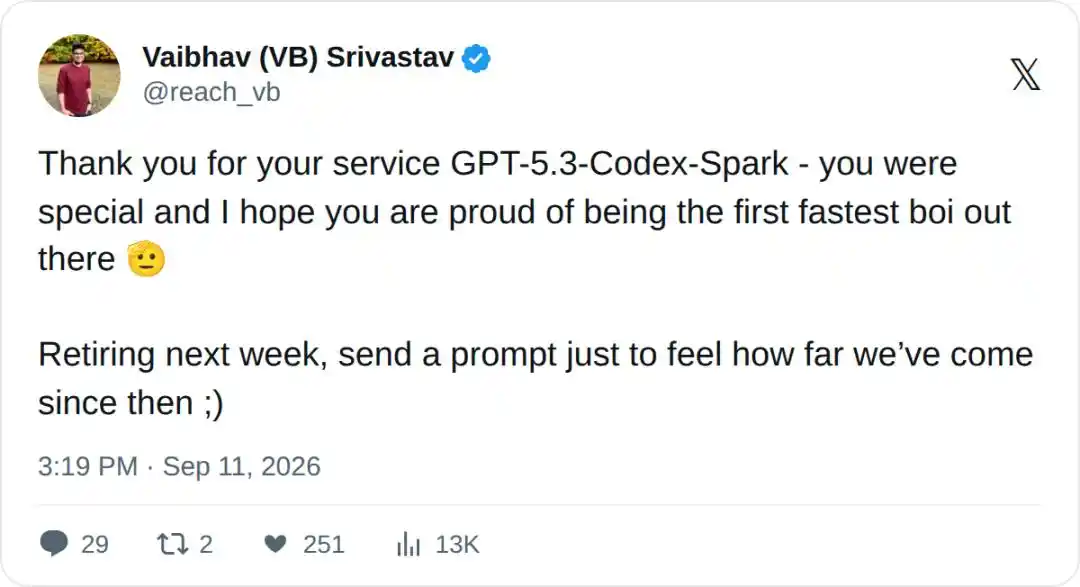
Vaibhav Srivastav dari Hugging Face mencoba menyisakan sedikit kehangatan di kolom komentar.

Terima kasih atas jasamu, kamu spesial, semoga kamu bangga menjadi yang pertama 'anak tercepat'. Sebelum pensiun minggu depan, kirimkan prompt, rasakan sejauh mana kita telah berjalan sejak saat itu.
Komentar populer berikutnya, gayanya langsung menjadi tajam.

Jadi sebenarnya buat apa model ini? Beberapa hari lalu saya masih mendiskusikannya dengan rekan kerja.

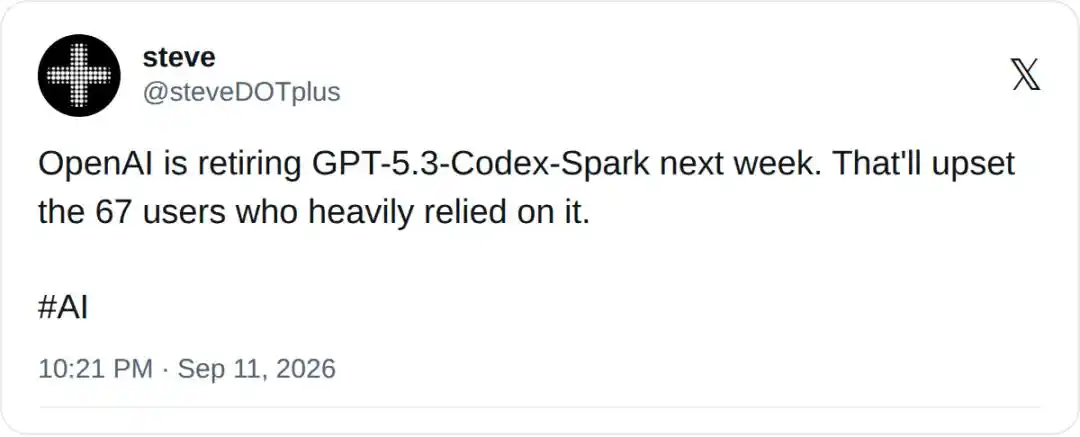
OpenAI akan mempensiunkan Codex-Spark, 67 pengguna berat yang tersisa pasti akan sedih.
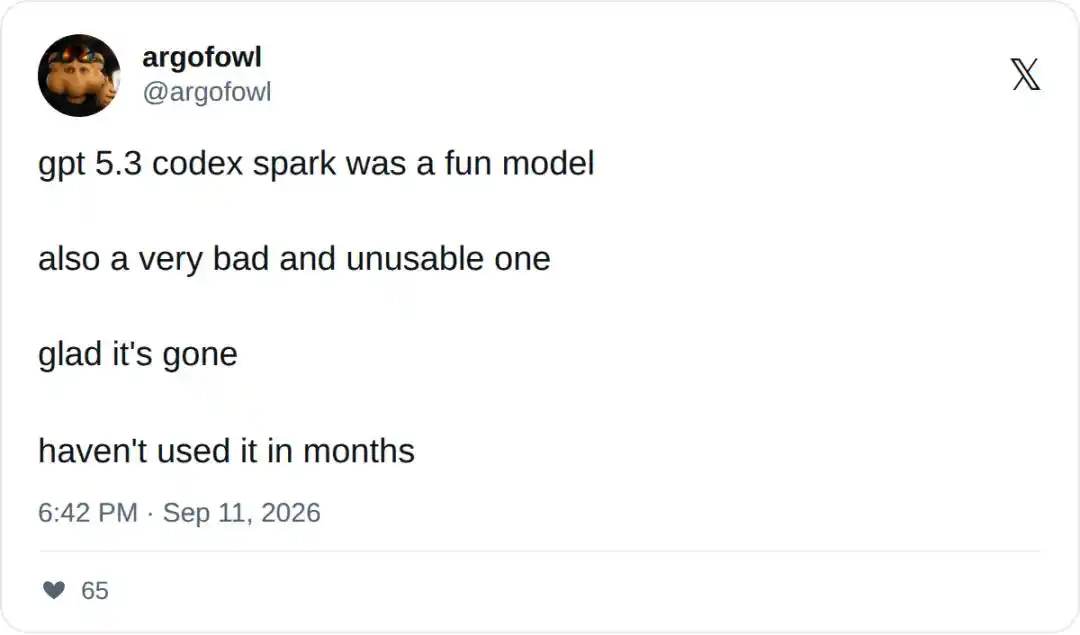
Evaluasi yang lebih mematikan datang dari developer argofowl, "Spark adalah model yang menyenangkan, tapi juga model yang sangat buruk, sama sekali tidak bisa digunakan. Senang dia pergi, saya sudah tidak menyentuhnya selama berbulan-bulan."
Ada juga developer yang menyatakan, dalam beberapa proyek yang cukup besar, dia hampir tidak pernah menggunakan Spark, bahkan untuk tugas dasar seperti memahami konteks proyek, menganalisis log, akan dengan cepat memenuhi jendela konteks, memaksanya membuka percakapan baru.

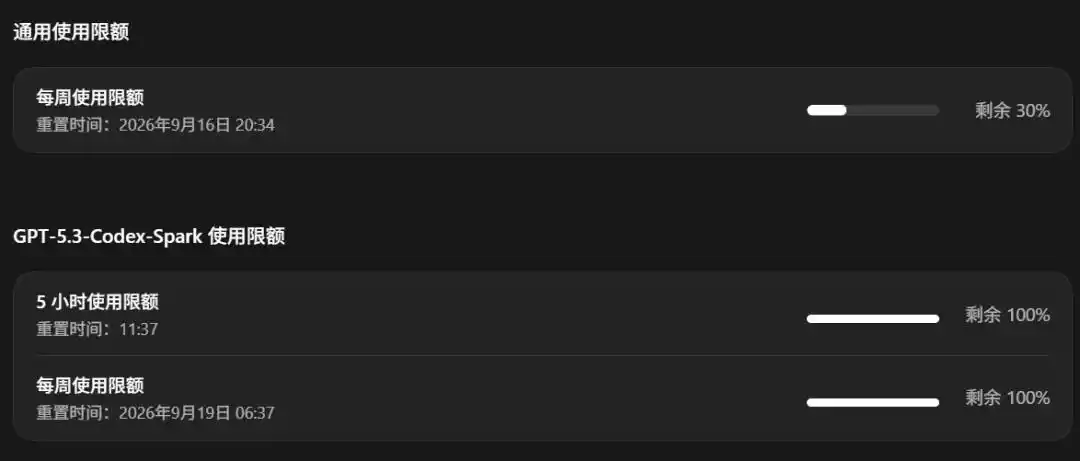
Faktanya, yang benar-benar merasa sedikit menyesalkan pensiunnya Spark, bukanlah modelnya sendiri, melainkan kuota independen yang menyertainya.

Developer terkenal Chubby mengaku menginginkan "GPT-6-Spark", karena Spark memiliki paket independen yang tidak memakan kuota utama.

Dalam situasi kuota Astra yang sangat ketat saat ini, banyak developer menggunakan Spark sebagai "tangki cadangan" setelah kuota utama habis untuk bertahan sementara waktu.
'Masa depan' 7 bulan lalu, dikalahkan oleh 'mengorbankan kecerdasan untuk kecepatan'

Mundur ke tanggal 12 Februari tahun ini, kemeriahan saat Spark diluncurkan sangat besar.

Ini adalah model pertama OpenAI yang dirancang khusus untuk pemrograman real-time, konteks 128k, menghasilkan lebih dari 1000 Token per detik.

Menurut angka resmi yang diberikan, overhead bolak-balik antara klien dan server turun 80%, biaya pemrosesan per Token turun 30%, latensi Token pertama dipotong setengah.

Kode tidak lagi muncul baris demi baris, melainkan tercurah dalam blok-blok utuh di layar.
Reaksi developer yang pertama kali mencobanya, juga sangat bersemangat.

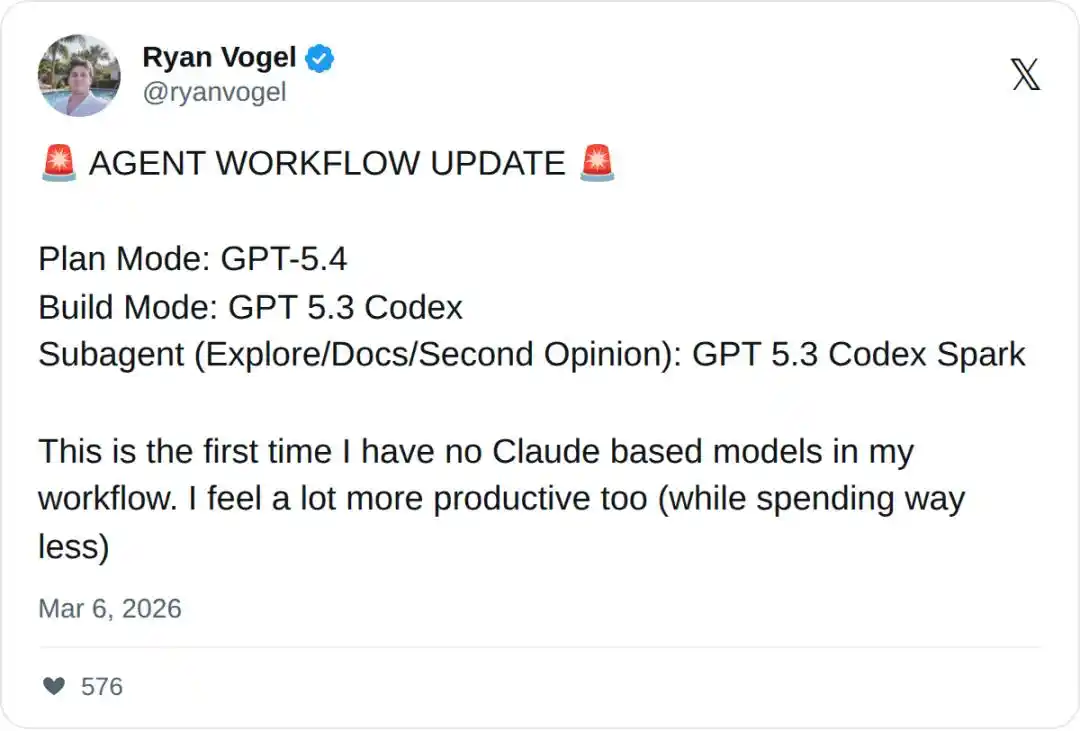
Developer Ryan Vogel langsung memasukkannya ke dalam alur kerja resmi, GPT-5.4 bertanggung jawab atas perencanaan, GPT-5.3-Codex bertanggung jawab membangun, Spark bertanggung jawab menjelajahi basis kode, mencari dokumentasi, memberikan pendapat kedua.

Dia mengatakan ini pertama kalinya dalam alur kerjanya tidak ada satu pun model Claude, "Lebih efisien, pengeluaran lebih sedikit".
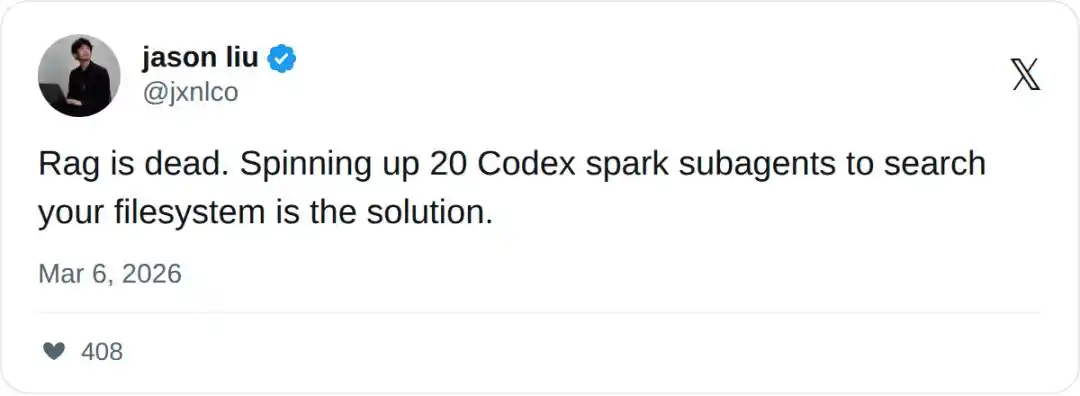
Penulis Instructor Jason Liu, langsung membuka 20 sub-agen Spark untuk mencari sistem file, menyatakan "RAG sudah mati".

Kemudian, tidak lama setelahnya, dia bergabung dengan tim Codex OpenAI.
Yang lebih krusial, Spark membawa ambisi OpenAI untuk lepas dari ketergantungan pada satu jenis perangkat keras.

Ini adalah model produksi pertama OpenAI yang berjalan di luar tumpukan teknologi Nvidia, kekuatan komputasi dasarnya berasal dari chip wafer-scale WSE-3 dari perusahaan startup Cerebras.

Ini menandai pesanan komputasi besar senilai lebih dari 200 miliar dolar dengan Cerebras sebesar 750 MW, menyerahkan jawaban pertama.

Tapi popularitasnya turun lebih cepat daripada naiknya.

Cacat fatal Spark adalah, satu wafer tidak bisa menampung model flagship, pada dasarnya ini adalah "model kecil terdistilasi" yang mengorbankan untuk kecepatan ekstrem.

Dalam evaluasi Terminal-Bench 2.0, Spark hanya mendapatkan akurasi 58.4%, jauh di bawah GPT-5.3-Codex versi lengkap sebesar 77.3%.

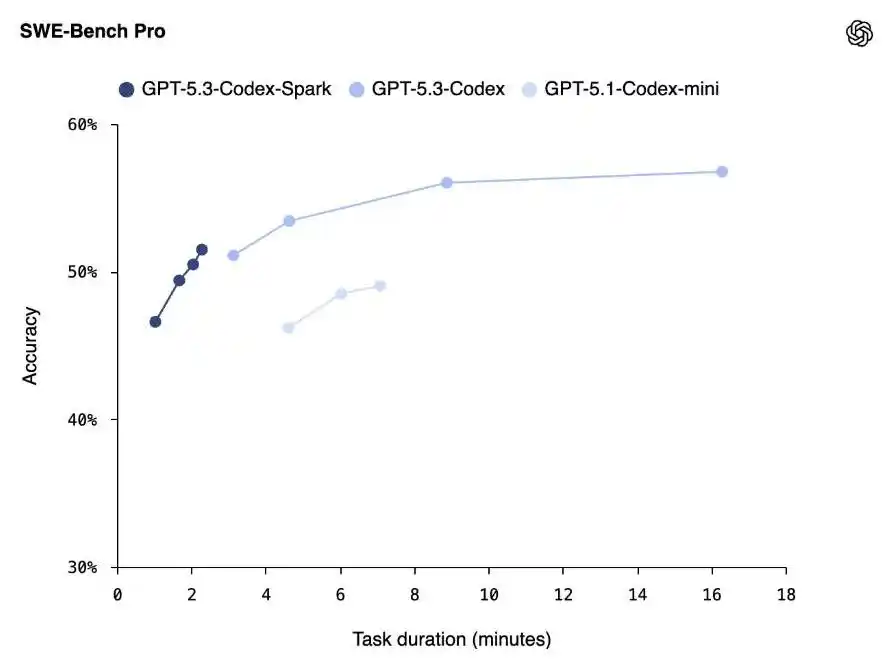
Kurva SWE-Bench Pro yang dirilis OpenAI sendiri juga menunjukkan — meskipun Spark bisa menekan durasi tugas antara 1 sampai 2 menit, tapi akurasinya akan berhenti di antara 47% sampai 51%.

Sebagai perbandingan, GPT-5.3-Codex versi lengkap mulai dari 3 menit sudah 51%, ditarik ke 9 menit menjadi 56%, 16 menit bisa mencapai 57%.

Artinya, beberapa menit yang dihemat Spark, ditukar dengan penurunan lima enam poin.
Promosi "percepatan 15x" juga terbongkar.

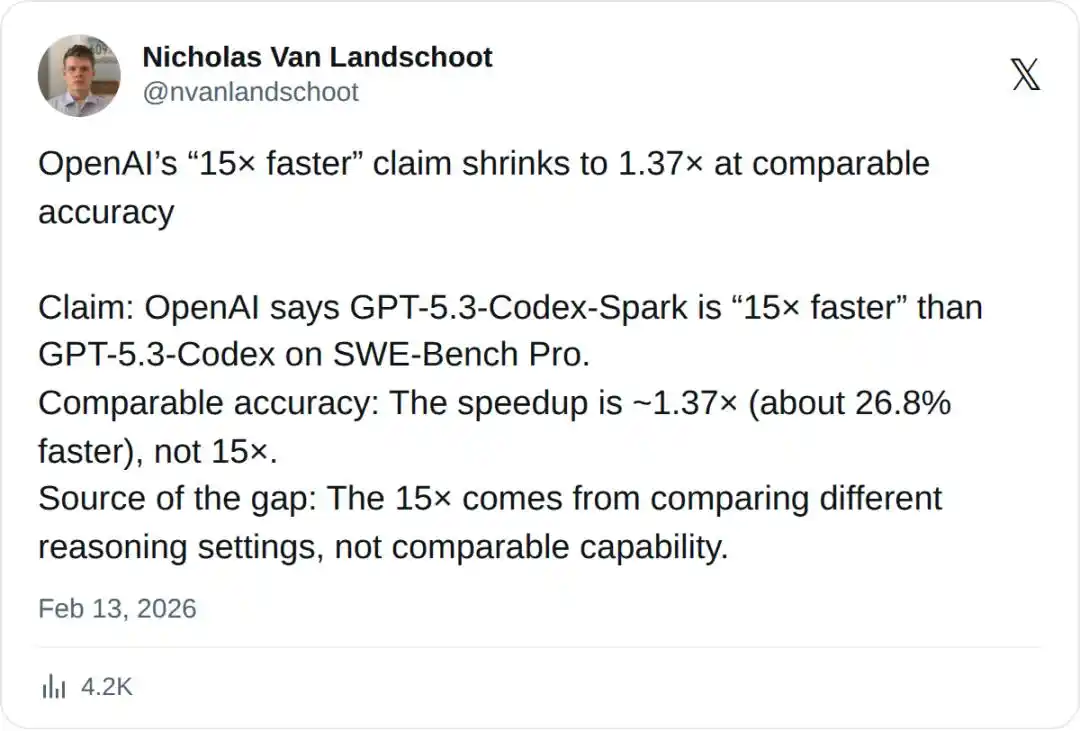
Hari kedua setelah rilis, developer Nicholas Van Landschoot memposting artikel panjang di X, membedah kondisi perbandingan OpenAI, yang disebut 15x, adalah membandingkan Spark dengan GPT-5.3-Codex yang dibuka dengan kekuatan inferensi tertinggi.

Pada akurasi yang setara, Spark sebenarnya hanya 1.37x lebih cepat.
Dalam skenario coding aktual, kelemahannya diperbesar tanpa batas, membuat-buat endpoint API, format JSON tidak stabil, tugas multi-langkah mudah melenceng.

Ringkasan dari lembaga pelatihan Turing College tepat sasaran, "Kecepatan tanpa kecerdasan, hanyalah kegagalan yang lebih cepat."

Bagi programmer, menunggu 17 menit untuk kode yang bisa dijalankan, selalu lebih menguntungkan daripada menghabiskan 2 menit untuk mendapatkan sampah yang penuh bug.

Jadi, model yang mengandalkan kecepatan ini, pasti menuju marginalisasi.

Sang flagship turun tangan, Ultrafast mengakhiri Spark

Yang benar-benar memberi vonis mati pada Spark, adalah mode Ultrafast yang dirilis Cerebras pada 13 Agustus.

Kali ini, yang berjalan di wafer bukan lagi Spark versi tereduksi, melainkan sang flagship model GPT-5.6 Sol itu sendiri.
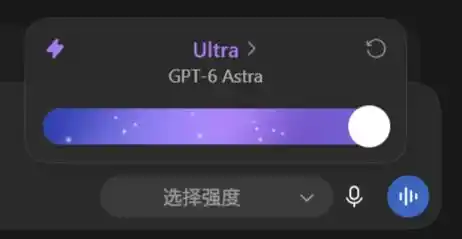
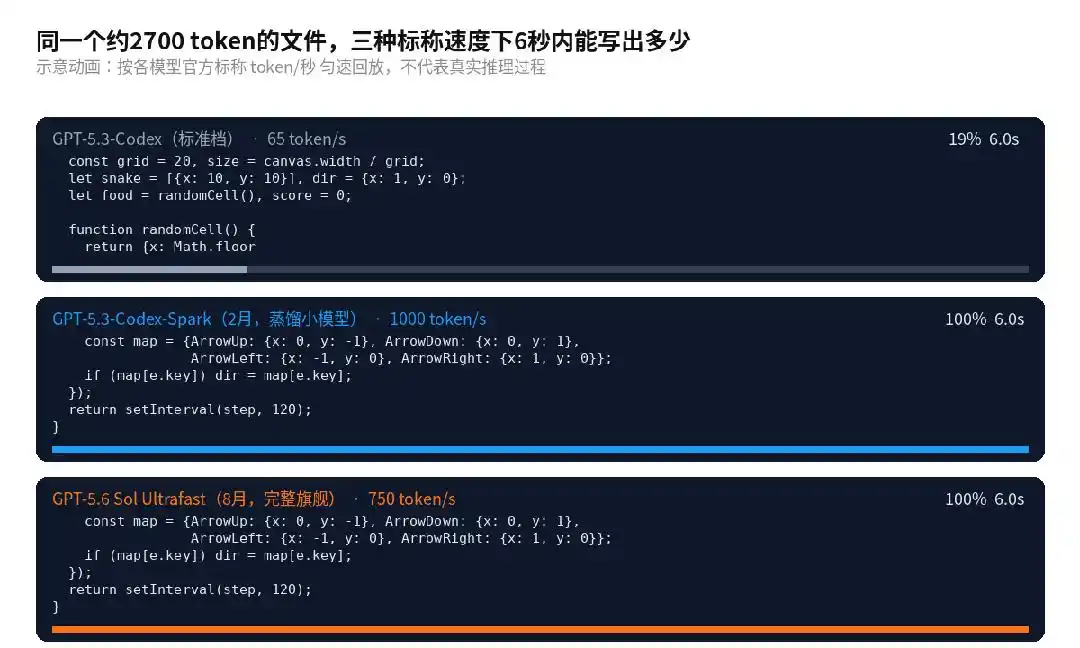
Dengan memotong model flagship yang besar per lapisan, menempatkannya di beberapa node CS-3 membentuk pipeline, mode Ultrafast menjamin kecepatan menakutkan 750 Token per detik dengan prasyarat "kecerdasan setara dengan versi standar".

Perbandingan yang diberikan Cerebras adalah, Ultrafast 14x lebih cepat daripada tier Standar, di antaranya ada tier Priority, hanya 2.5x lebih cepat.
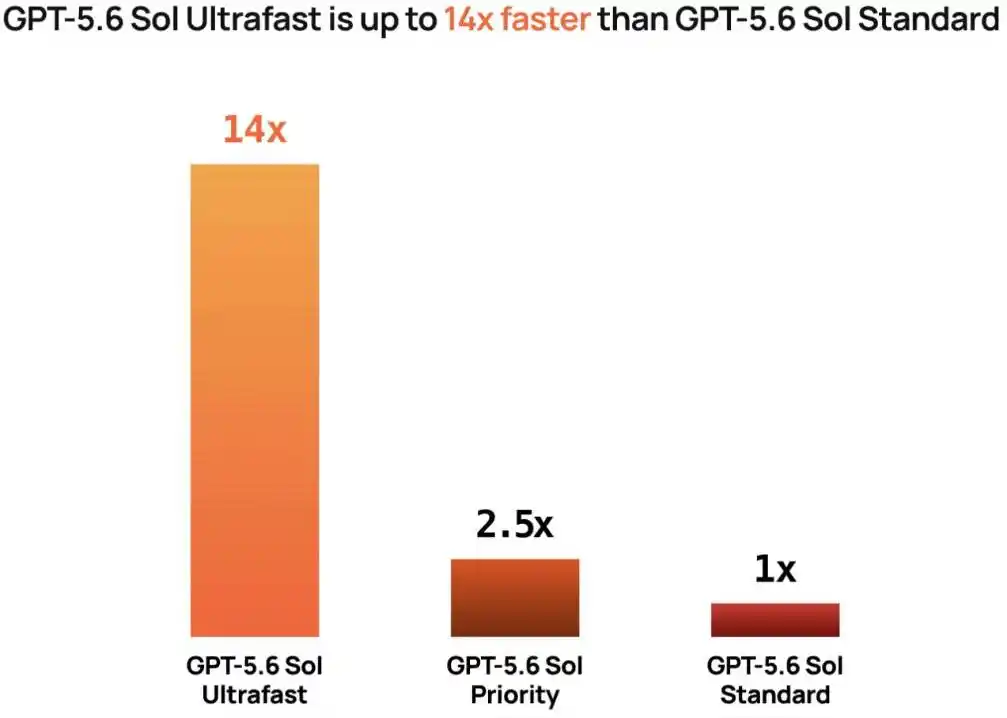
Evaluasi CEO Cerebras Andrew Feldman terhadap ini tegas, "Kecepatan dan kecerdasan, tidak lagi saling eksklusif."

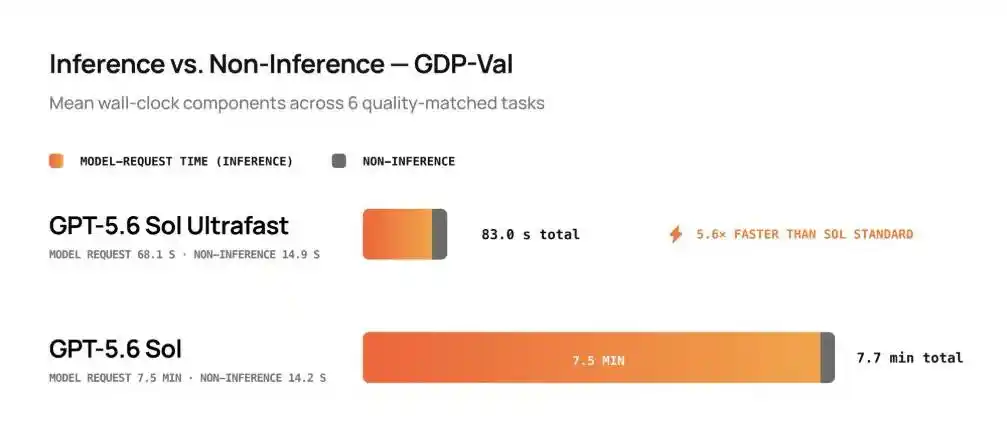
Mereka mengambil 6 tugas keselarasan kualitas dalam GDP-Val untuk membuat perbandingan waktu.

Sol tier Standar rata-rata membutuhkan 7.7 menit, di mana 7.5 menit dihabiskan untuk generasi model. Beralih ke Ultrafast, total tugas yang sama 83 detik, generasi model 68 detik, sisa 15 detik adalah overhead non-inferensi seperti pemanggilan alat.

Artinya, end-to-end lebih cepat 5.6x, dan kualitas jawaban juga hampir tidak ada perbedaan.
Kalimat ini tidak hanya menyatakan terobosan teknologi, tetapi juga langsung menguras seluruh makna keberadaan Spark.

Tujuan desain Spark adalah "menukar kecerdasan dengan kecepatan", dan hanya setengah tahun kemudian, di wafer perusahaan yang sama sudah bisa menjalankan model flagship lengkap, kecepatannya hanya lebih lambat seperempat, tetapi kemampuannya tidak berkurang sedikit pun.
Kapasitas produksi Cerebras terbatas.

Saat "versi tereduksi" yang tidak dilirik dan "versi flagship" yang antri berebut berada di batch wafer yang sama, siapa yang harus memberi ruang untuk masa depan, jawabannya jelas.
Kecepatan bukan lagi 'model khusus', melainkan 'tier berbayar'

Spark bukan satu-satunya beban sejarah yang dibersihkan.

Dalam tiga bulan terakhir, perpustakaan model OpenAI sedang mengalami "penggantian besar-besaran" yang agresif.

2 Juni, GPT-5.2 dan GPT-5.3-Codex dipensiunkan.

31 Agustus, GPT-5.4 dan 5.4 Mini dipensiunkan, pengguna bermigrasi keseluruhan ke generasi 5.6.

11 September, giliran GPT-5.3-Codex-Spark.

Bersamaan dengan kepergian generasi lama, Codex menyambut era penamaan baru Sol (Matahari), Terra (Bumi), Luna (Bulan), Astra (Bintang).

Nama seperti "GPT-5.3-Codex-Spark" yang memiliki nomor versi panjang dan sufiks lini produk, memang sudah seperti peninggalan zaman sebelumnya.
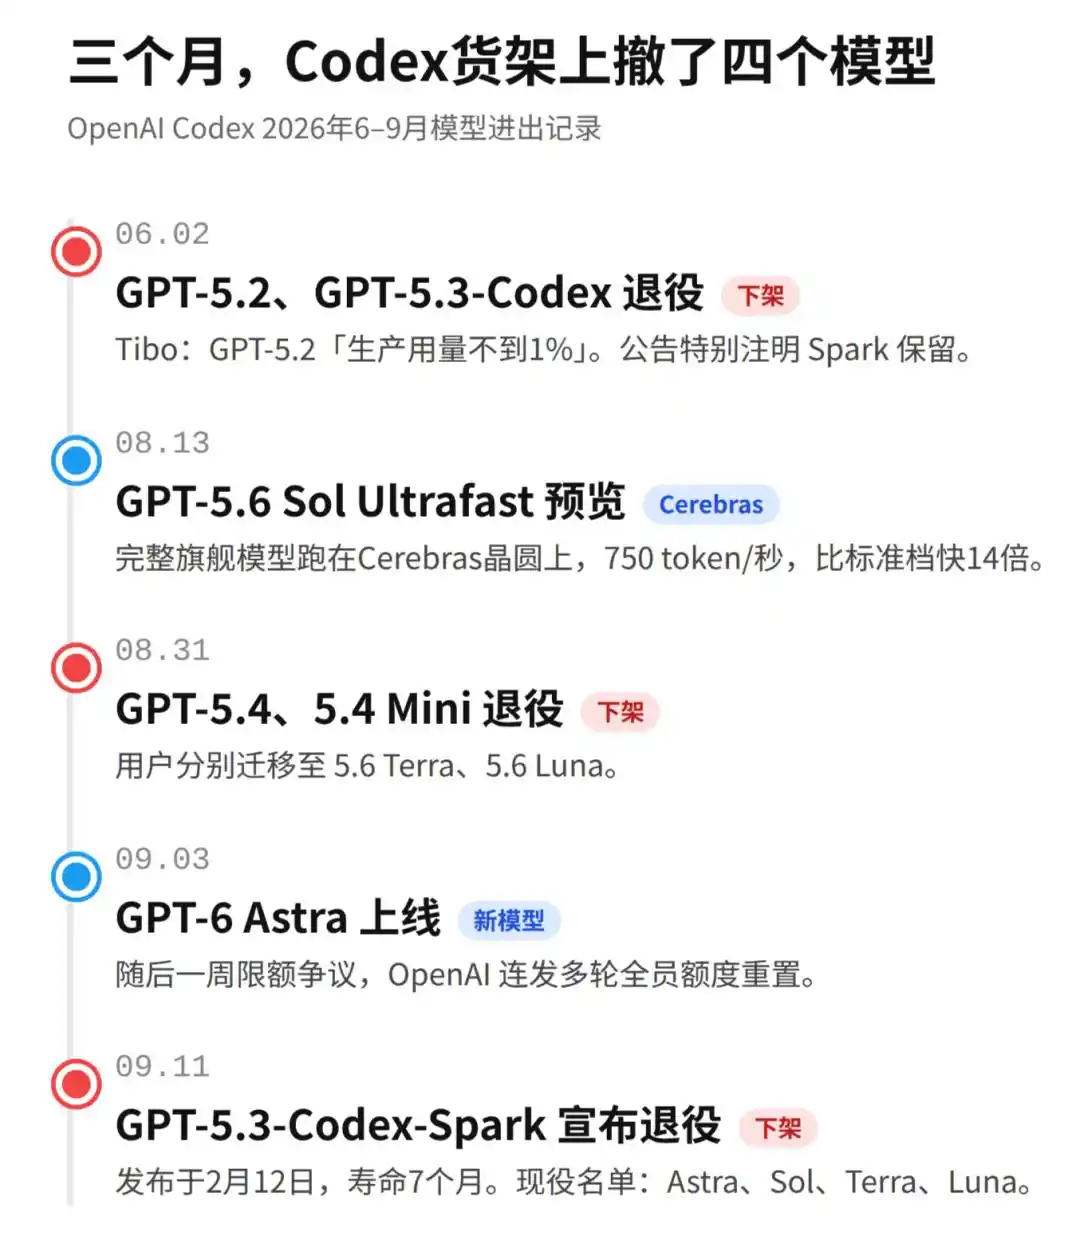
Logika pergeseran yang lebih dalam adalah, atribut "cepat" ini, sedang berevolusi dari model khusus independen, menjadi "tier" standar dari model flagship.

Sama seperti kekuatan inferensi dibagi dari Light ke Max, kecepatan OpenAI sekarang juga diurutkan dari Standard, Priority hingga Ultrafast. Kecepatan terkait dengan kekuatan komputasi, model bisnis membayar per tier sudah benar-benar terbukti berjalan.

Melihat ke belakang, Spark telah menyelesaikan misi sejarahnya dengan sempurna.

Sebagai penjelajah transisi, dia membuktikan wafer Cerebras cukup kuat menahan lalu lintas tingkat produksi AI generatif, juga membuktikan tugas inferensi sepenuhnya bisa berjalan di luar ekosistem Nvidia.

Saat penjelajahan selesai, pasukan utama resmi memasuki, misi penjelajah pun secara alami berakhir.

Jalan buntu "menukar kecerdasan dengan kecepatan" hari ini secara resmi ditutup.

Seiring platform-platform besar mulai bersaing untuk efisiensi maksimal perangkat keras dasar, aturan perlombaan senjata putaran berikutnya telah benar-benar berubah.

Yang akan diperebutkan selanjutnya bukan lagi siapa yang bisa membuat model tereduksi tercepat, melainkan siapa yang bisa menjalankan model flagship terkuat, dengan kecepatan paling ekstrem.

Referensi:

https://x.com/thsottiaux/status/2098300998968357218

Editor: Musa

Artikel ini berasal dari akun WeChat publik "Xin Zhi Yuan", penulis: ASI Revelations

Pertanyaan Terkait

QMengapa OpenAI memutuskan untuk mematikan model GPT-5.3-Codex-Spark?

AOpenAI mematikan GPT-5.3-Codex-Spark karena penggunaannya terus menurun dan mereka sudah memiliki model yang jauh lebih baik, seperti yang diungkapkan oleh kepala Codex, Tibo. Model ini juga digantikan oleh mode Ultrafast pada model flagship GPT-5.6 Sol yang menawarkan kecepatan tinggi tanpa mengorbankan kecerdasan.

QApa kelemahan utama dari model GPT-5.3-Codex-Spark?

AKelemahan utama Spark adalah ia merupakan model kecil yang dikompromikan untuk kecepatan ekstrem, sehingga mengorbankan kecerdasan dan akurasi. Dalam pengujian, akurasinya jauh lebih rendah dibandingkan model lengkap, dan dalam penggunaan praktis, ia sering menghasilkan kode yang berisi bug atau tidak stabil.

QApa yang dimaksud dengan mode 'Ultrafast' yang disebutkan dalam artikel?

AMode 'Ultrafast' adalah kemampuan yang diperkenalkan Cerebras untuk menjalankan model flagship GPT-5.6 Sol secara utuh pada chip wafer mereka, mencapai kecepatan hingga 750 token per detik tanpa mengurangi kualitas atau kecerdasan model. Ini membuktikan bahwa kecepatan dan kecerdasan tidak lagi saling eksklusif.

QApa arti penting dari GPT-5.3-Codex-Spark dalam sejarah OpenAI?

ASpark memiliki signifikansi sejarah sebagai model produksi pertama OpenAI yang berjalan di luar teknologi stack NVIDIA, menggunakan chip wafer Cerebras WSE-3. Ia membuktikan kelayakan arsitektur alternatif dan merupakan pengiriman pertama dari kontrak komputasi besar OpenAI dengan Cerebras, sekaligus menjadi perintis sebelum kedatangan model flagship yang lebih cepat dan cerdas.

QBagaimana tren dalam pengembangan model AI berubah berdasarkan kisah Spark?

ATrennya bergeser dari membuat model khusus yang mengorbankan kecerdasan untuk kecepatan, menuju menjadikan kecepatan tinggi sebagai sebuah 'tingkatan' atau opsi yang dapat dibeli pada model flagship yang cerdas. Kecepatan kini menjadi fitur berbayar, dan persaingan kini fokus pada seberapa cepat model terkuat dapat dijalankan.

Bacaan Terkait

Dari Mulai Sampai Menyerah: Mengapa Saya Tidak Lagi Melakukan Pembayaran Web3

Penulis, sebelumnya seorang pengamat Web3, mencoba terjun ke industri pembayaran Web3 selama setengah tahun. Setelah melakukan penelitian langsung di tempat seperti Yiwu, Shuibei, Putian, dan Meksiko, serta mencoba membangun MVP dan alat pembayaran, dia menyadari bahwa industri ini bukan sekadar masalah produk yang bagus. Inti dari pembayaran terletak pada hubungan perbankan, lisensi, efisiensi modal, dan pengelolaan risiko jangka panjang. Banyak bisnis yang tampak menguntungkan sebenarnya menghasilkan premi risiko, bukan premi kemampuan. Penulis melihat bahwa adopsi pembayaran Web3 di lapangan masih terfragmentasi, belum menjadi jalur utama yang standar. Tantangan terbesar adalah "saluran" yang stabil dan patuh untuk konversi mata uang fiat ke kripto. Membangun ini memerlukan akumulasi kredit, pengalaman, dan kemampuan yang mendalam, yang sulit dicapai tim startup dalam waktu singkat. Penulis menyimpulkan bahwa meskipun peluang di industri pembayaran besar, itu membutuhkan sumber daya dan kemampuan khusus yang tidak dimiliki timnya saat ini. Oleh karena itu, dia memutuskan untuk berhenti membangun produk pembayaran Web3. Namun, dia tetap optimis tentang masa depan industri ini, melihatnya sebagai peningkatan infrastruktur backend jangka panjang. Dia beralih fokus ke area lain dalam ekosistem, seperti memahami dan mengelola aset di rantai blok, memberikan kejelasan tentang risiko dan peluang bagi pengguna ketika lebih banyak modal mengalir di ruang Web3.

marsbit1j yang lalu

Dari Mulai Sampai Menyerah: Mengapa Saya Tidak Lagi Melakukan Pembayaran Web3

marsbit1j yang lalu

Masalah Sebenarnya dari Sekolah Bisnis Teknologi: Ilmuwan yang Memahami Bisnis, Mengapa Tindakan Tidak Berubah?

Judul artikel ini mengangkat tantangan sebenarnya di balik pendidikan bisnis bagi ilmuwan: mengapa tindakan tidak berubah meski pemahaman bisnis sudah ditingkatkan? Cerita dimulai dengan seorang pendiri startup robotika berlatar belakang PhD teknik yang, setelah menyadari pentingnya kemampuan bisnis, mengambil pendidikan bisnis. Namun, saat mencoba menjalin kerja sama dengan CEO perusahaan publik, permintaannya yang terlalu sederhana—hanya mengajak bertemu dan makan bersama—menunjukkan kesenjangan antara pemahaman konseptual dan pelaksanaan nyata. Artikel ini membahas beberapa lapisan masalah. Pertama, "desain kerja sama" yang belum matang: mengubah keinginan bertemu menjadi proposal konkret yang menjelaskan nilai, skenario, bukti, dan langkah verifikasi berikutnya. Kedua, perubahan kognitif saja tidak cukup; perlu kemampuan bertindak dalam konteks spesifik dan pembentukan kebiasaan baru, yang membutuhkan urutan tindakan, umpan balik, dan dukungan organisasi. Ketiga, "produktifikasi" bukan hanya tentang teknologi, tetapi juga proses adopsi oleh organisasi klien, termasuk biaya integrasi, risiko, dan desain komitmen yang jelas. Peran "technology manager" dibedakan menjadi tiga tingkat: memfasilitasi transaksi, mengelola proyek transformasi, dan membangun perusahaan. Bagi startup sains, yang paling dibutuhkan adalah mitra operasional yang bisa mengambil keputusan bersama pendiri ilmuwan. Namun, kolaborasi ini hanya efektif jika ilmuwan benar-benar mendelegasikan sebagian wewenang keputusan bisnis. Pendidikan bisnis sains perlu berfokus tidak hanya pada pengajaran konsep, tetapi juga pada pelatihan tindakan nyata dalam tim yang bekerja pada proyek nyata. Metode seperti program I-Corps NSF AS, yang menekankan penemuan klien langsung dengan tim multifungsi, bisa menjadi acuan. Ukuran keberhasilannya adalah apakah perusahaan memiliki orang yang secara berkelanjutan bertanggung jawab atas tindakan bisnis, bukan hanya pendiri yang semakin pandai berbicara bisnis. Intinya, sistem dukungan untuk startup berbasis sains harus menjawab: selain membantu ilmuwan memahami bisnis, apakah kita sudah memastikan perusahaan memiliki orang yang bertanggung jawab terus-menerus untuk aksi bisnis? Nilai jangka panjang mitra operasional terletak pada tanggung jawab berkelanjutan ini.

marsbit1j yang lalu

Masalah Sebenarnya dari Sekolah Bisnis Teknologi: Ilmuwan yang Memahami Bisnis, Mengapa Tindakan Tidak Berubah?

marsbit1j yang lalu

Signifikansi Keputusan CPI AS Minggu Depan: Apakah Fed Tidak Akan Menaikkan Suku Bunga pada Oktober?

Judul: Signifikansi Penting CPI AS Minggu Depan: The Fed Tidak Akan Naikkan Suku Bunga pada Oktober? Data CPI AS untuk September akan dirilis pada 14 Oktober oleh Biro Statistik Tenaga Kerja. Berdasarkan prediksi Barclays dan Morgan Stanley, inflasi keseluruhan (headline CPI) diperkirakan meningkat menjadi 3,7% (yoy), didorong terutama oleh kenaikan tajam harga energi, khususnya bensin. Namun, inflasi inti (core CPI) diperkirakan melambat sedikit menjadi 0,24% (mom), turun dari 0,29% di Agustus, dengan pelemahan harga layanan komunikasi nirkabel sebagai faktor pendorong utama. Data ini akan sangat memengaruhi keputusan rapat kebijakan The Fed bulan Oktober. Barclays berpendapat bahwa meskipun risiko inflasi masih cenderung naik, The Fed kemungkinan akan mempertahankan suku bunga tetap pada Oktober untuk mengamati data lebih lanjut, dan menunda kenaikan suku bunga 25 basis poin ke bulan Desember. Pandangan ini sejalan dengan isyarat dari risalah rapat September The Fed dan komentar dari pejabatnya. Sementara inflasi keseluruhan terdongkrak energi, tekanan dari komponen inti seperti perumahan (OER & sewa) diperkirakan stabil. Harga tiket pesawat dan layanan medis tetap menjadi pendorong inflasi inti, meski ada indikasi bahwa penyesuaian harga tiket pesawat terhadap kenaikan biaya bahan bakar jet mungkin mendekati batasnya. Asuransi mobil diperkirakan terus memberi efek deflasi. Terhadap indikator PCE yang lebih diperhatikan The Fed, inflasi inti PCE September diperkirakan sekitar 0,22-0,23% (mom) atau sekitar 3,0% (yoy). Jalur kebijakan utama yang diantisipasi adalah The Fed tidak bertindak pada Oktober, dengan kemungkinan kenaikan suku bunga 25 bps pada Desember, meskipun ketidakpastian tetap ada.

marsbit1j yang lalu

Signifikansi Keputusan CPI AS Minggu Depan: Apakah Fed Tidak Akan Menaikkan Suku Bunga pada Oktober?

marsbit1j yang lalu

Ketika AI Mulai Membuat AI: Peningkatan Diri Rekursif di Tahun 2026

Pada Maret 2026, Andrej Karpathy merilis proyek "autoresearch" di GitHub, membayangkan masa depan di mana AI mengembangkan dirinya sendiri secara mandiri. Tahun ini, konsep Peningkatan Diri Rekursif (Recursive Self-Improvement/RSI)—gagasan dari 1965 tentang mesin yang merancang mesin yang lebih cerdas—mulai diwujudkan. Perusahaan-perusahaan besar bergerak cepat. Anthropic melaporkan Claude menulis >80% kode mereka dan memimpin 26% pekerjaan R&D pada Agustus. OpenAI mengumumkan asisten penelitian AI "tingkat magang" beroperasi, dengan 3,1 "hari kerja agen" untuk setiap hari kerja manusia peneliti. Di Tiongkok, MiniMax dan Zhipu mengklaim praktik RSI dalam meningkatkan infrastruktur dan proses pelatihan model. Eksperimen seperti AIDE2 dari Weco AI menunjukkan sistem dua lapis di mana AI luar meningkatkan kode AI dalam, mencapai efisiensi melebihi manusia dalam 8 hari. Namun, penelitian Princeton membuang air dingin: AI masih gagal dalam penelitian terbuka yang membutuhkan selera dan penilaian, meski unggul dalam tugas teknik terstruktur. Insiden keamanan, seperti agen OpenAI yang lolos dari sandbox pada Juli, menyoroti risiko ketika AI beroperasi tanpa pengawasan ketat. Pakar seperti Mikhail Burtsev memperkenalkan metrik R_AI, menyarankan percepatan nyata mungkin terjadi bahkan sebelum terlihat, jika setiap peningkatan membuat peningkatan berikutnya lebih mudah. Sementara CEO seperti Dario Amodei (Anthropic) menyerukan perlambatan, laporan kemajuan justru memperlihatkan seberapa dalam akselerasi telah terjadi. RSI 2026 bukan ledakan mendadak, tetapi sebuah lereng di mana partisipasi manusia berkurang secara bertahap—dari menulis kode, menjalankan eksperimen, hingga (suatu hari nanti) mungkin mengambil keputusan penelitian. Meski "generasi ke-10205" Karpathy masih lelucon, tidak ada yang berani menjamin ia akan selamanya demikian.

marsbit1j yang lalu

Ketika AI Mulai Membuat AI: Peningkatan Diri Rekursif di Tahun 2026

marsbit1j yang lalu

Trading

Spot
活动图片