Ces dernières années, les modèles de génération de vidéo ont progressé rapidement en termes de clarté, de cohérence temporelle et de contrôlabilité. À partir d'un texte, d'une image, d'une trajectoire de caméra ou d'actions de joueur, les modèles sont désormais capables de synthétiser des images ultérieures cohérentes, faisant progresser le concept de « monde vidéo interactif » d'une idée vers un prototype visible et utilisable.
Cependant, la capacité à prolonger une image ne signifie pas savoir exécuter un monde. Les déplacements et collisions dans le cadre ne représentent que la couche la plus superficielle de l'interaction ; dans des environnements plus complexes, les personnages ont aussi des objectifs, des identités et des relations, les événements sont soumis à des règles, et ils laissent des conséquences causales sur de longues périodes. De nombreux états se produisent même hors champ, mais continuent d'influencer l'intrigue et les actions ultérieures. Prédire la prochaine séquence d'observation uniquement à partir de pixels locaux rend difficile le maintien explicite de cette sémantique de haut niveau.
Un monde complexe nécessite d'abord de « comprendre pourquoi ». Les objectifs, règles, souvenirs et chaînes causales ne sont généralement pas directement lisibles dans la trame actuelle, mais ils déterminent comment le monde devrait évoluer ensuite. La capacité des modèles de langage à mobiliser des connaissances, raisonner, planifier et programmer est adaptée pour traiter ce type de décisions à faible fréquence mais haute complexité, et pour traduire ces décisions en règles exécutables.
Une autre réalité souvent négligée est que la vidéo de jeu n'est pas le monde lui-même, mais la projection en pixels du résultat de l'exécution d'un programme après rendu. Actuellement, les jeux et simulateurs constituent toujours la source principale de données interactives pour les modèles de monde vidéo. Si on ne conserve que les actions et les pixels, et qu'on demande ensuite au modèle vidéo d'apprendre directement la correspondance entre les deux, cela revient à contourner les programmes, règles et états explicites du monde qui existaient à l'origine, en exigeant du modèle qu'il infère rétroactivement le comportement de tout le programme à partir des résultats visuels. Ce chemin d'apprentissage est non seulement inefficace, mais il couple également « comment le monde évolue » et « comment le monde est représenté » dans un seul et même modèle.
Partant de cette observation, l'équipe de recherche de l'AGI Lab de l'Université du Lac de l'Ouest et de l'Université technologique de Nanyang propose le Code World Model, un nouveau paradigme de modèle de monde utilisant un modèle de langage comme « cerveau ». L'idée centrale est de faire en sorte qu'un agent de codage maintienne et mette à jour un état mondial exécutable en écrivant, appelant et modifiant continuellement du code ; les états pertinents pour l'observation actuelle sont ensuite convertis en « proxy » pour guider le modèle vidéo dans la génération d'images visuelles détaillées.
Lien de l'article :https://arxiv.org/abs/2608.25927
Page du projet :https://buaacyw.github.io/cwm/
Dépôt de code :https://github.com/buaacyw/code-world-model
Le modèle de langage ne remplace pas ici le modèle vidéo. Le Code World Model redéfinit leurs rôles respectifs : les connaissances, objectifs, règles et causalités à long terme sont gérés par l'agent de codage et le code, tandis que l'apparence, les détails de mouvement, l'éclairage et les textures sont gérés par le modèle vidéo. Autrement dit, le premier détermine ce qui se passe dans le monde, le second détermine à quoi tout cela ressemble.
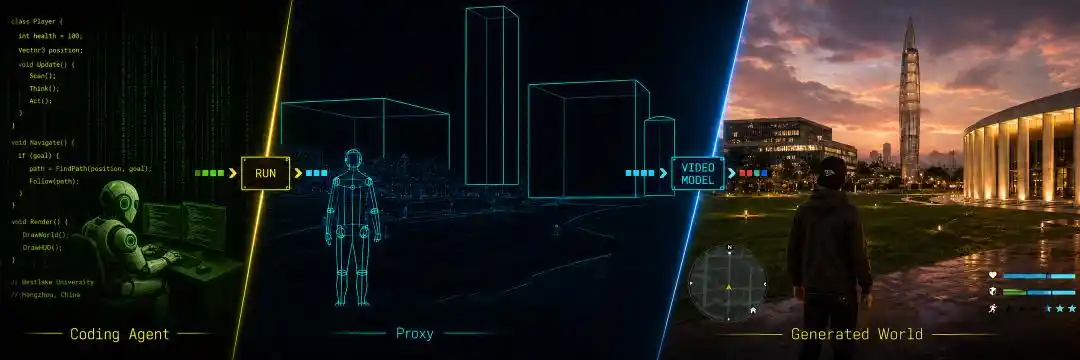
Figure 1 La division centrale du Code World Model : l'agent de codage fait évoluer l'état du monde via le code, le proxy convertit l'état pertinent en conditions visuelles, le modèle vidéo génère les images finales.
Aperçu de la méthode
Autour de cette division du travail, le Code World Model décompose le processus d'exécution du monde en trois parties liées entre elles.
Agent de codage : Comprend l'intention du joueur et les nouveaux événements, mobilise les connaissances du monde, raisonne sur les conséquences potentielles, et décide quels mécanismes doivent être exécutés, combinés ou modifiés.
Code : Exécute à une fréquence plus élevée des mises à jour déterministes (position, attributs, collisions, temps de recharge, déclenchement d'événements...), transformant les décisions de haut niveau en règles vérifiables, réutilisables et pouvant s'exécuter en continu.
Modèle vidéo : Lit les conditions d'état après évolution, utilise les connaissances préalables sur l'apparence, le mouvement et l'interaction apprises à partir de vastes données visuelles pour générer des observations visuelles riches en textures, éclairage et dynamique locale.
Cette division correspond également à des fréquences de calcul différentes. L'agent de codage n'intervient de manière éparse que lorsque de nouveaux objectifs, des événements complexes apparaissent, ou lorsque les mécanismes existants sont insuffisants ; une fois la décision écrite dans le code, le programme peut exécuter en continu des mises à jour d'état denses.
Plus important encore, ce que l'agent de codage modifie n'est pas seulement une valeur à un instant donné, il peut aussi changer la façon dont le monde fonctionnera par la suite.
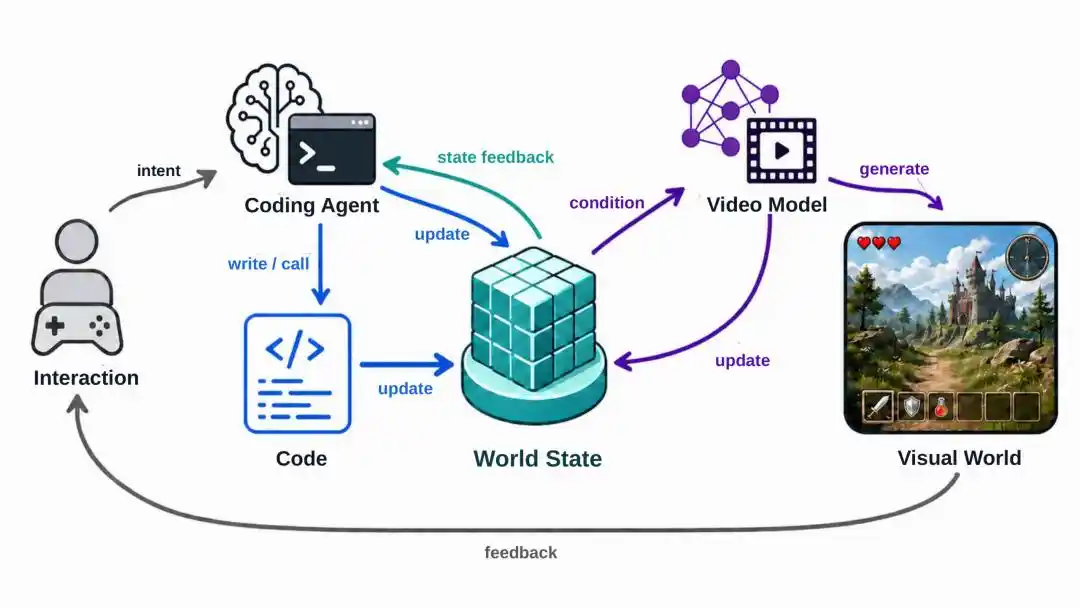
Figure 2 Architecture générale du Code World Model. La vision complète inclut un retour visuel ; le prototype actuel se concentre sur la validation de la chaîne aller : agent de codage / code → état du monde → proxy → modèle vidéo.
Le proxy relie l'état exécutable à la génération vidéo
Après la séparation des responsabilités, reste un problème d'interface crucial : l'agent de codage et le code gèrent un état exécutable, mais le modèle vidéo reçoit des tokens de texte, d'image ou de vidéo. Il faut un langage commun, à la fois facile à construire par programme et capable de fournir des contraintes spatiales image par image.
Le texte structuré est suffisamment flexible, mais peine à décrire de manière stable la position des entités, leurs relations, les trajectoires de mouvement et les changements précis de caméra pour chaque image ; construire et rendre un monde 3D complet offre un contrôle plus fort, mais réintroduit le coût élevé des assets, géométrie, matériaux, animations et pipeline de rendu.
Pour cela, ce travail introduit le « proxy ». Il extrait de l'état mondial les informations réellement nécessaires à l'observation actuelle et les organise en une représentation visuelle grossière. Un compilateur léger et déterministe rend le proxy en « proxy vidéo », qui est ensuite envoyé au modèle vidéo avec le texte structuré.
Le texte est responsable d'expliquer « qui, quoi, ce qu'il faut faire », tandis que le proxy spécifie « où, comment se déplacer, comment filmer ».
Le proxy peut exprimer la caméra et la perspective, la position et l'orientation des entités, l'échelle et la trajectoire, la disposition de la scène et l'occlusion, ainsi que les états grossiers nécessaires à l'interaction actuelle ; les textures, matériaux, l'éclairage fin et les mouvements locaux complets sont délibérément laissés au modèle vidéo. L'article résume ce principe de conception ainsi : ne conserver que l'état minimal suffisant nécessaire à l'observation actuelle, pour trouver un équilibre entre capacité de contrôle et coût d'encodage de l'état.
Dans l'implémentation actuelle, le proxy n'a qu'un quart de la hauteur et de la largeur de la vidéo cible, soit environ 1/16e du nombre de pixels. Il est composé de primitives géométriques simples et réutilisables, ne nécessite pas d'assets de qualité professionnelle, mais fournit néanmoins une ossature spatio-temporelle éditables image par image.
Obtenir des données parfaitement alignées à partir des enregistrements d'exécution de jeux
Pour que le modèle vidéo apprenne à comprendre le proxy, les échantillons d'entraînement doivent contenir simultanément la vidéo proxy, le texte structuré et la vidéo RGB cible, avec un alignement strict dans le temps, la caméra et l'identité des entités entre proxy et RGB.
Les enregistrements d'exécution de jeux conservent naturellement cette correspondance. L'équipe de recherche a enregistré de manière synchronisée, à partir d'une même exécution de gameplay, le RGB, l'état de la caméra, l'identité des entités, leur position et orientation, leur échelle approximative, la disposition de la scène et l'état des interactions, puis a compilé le proxy hors ligne via du code. Comme les deux proviennent de la même exécution, une correspondance un à un peut être établie pour chaque image, et les identités peuvent être mappées de manière stable d'une image à l'autre.
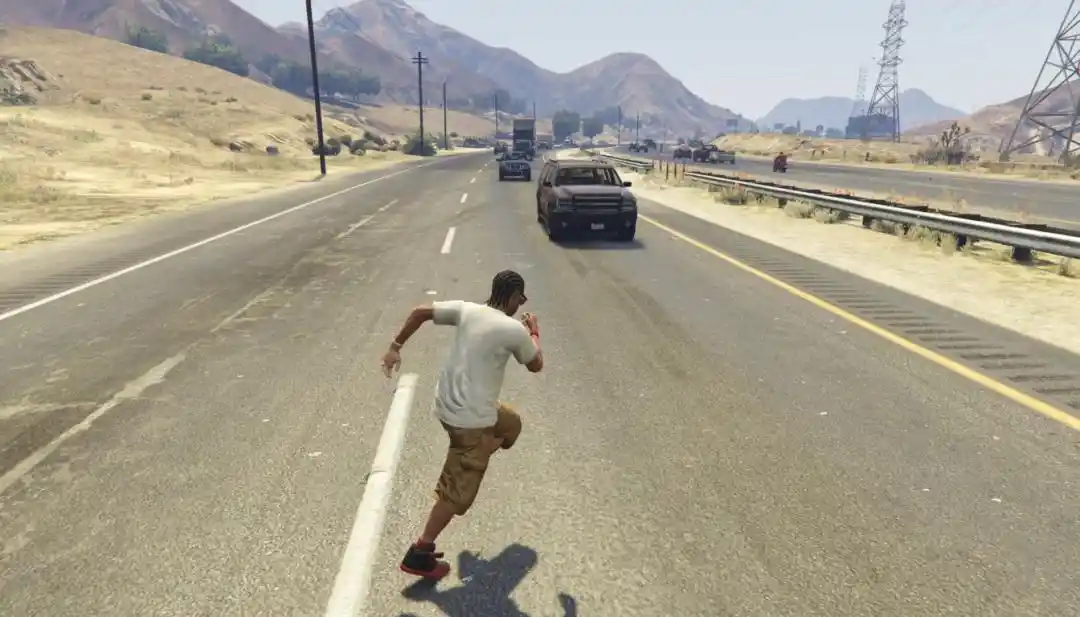
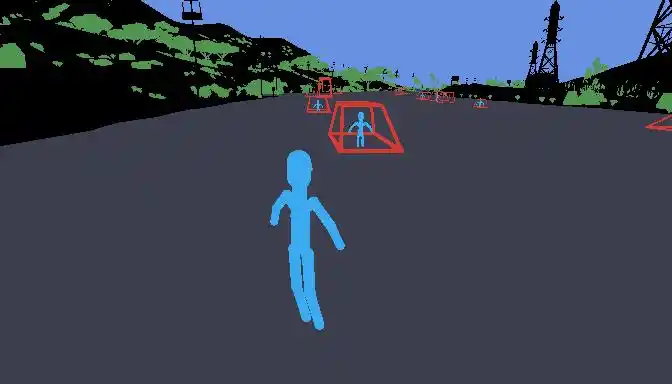
Figure 3a RGB cible des données de jeu (en haut) et proxy de la même image (en bas).
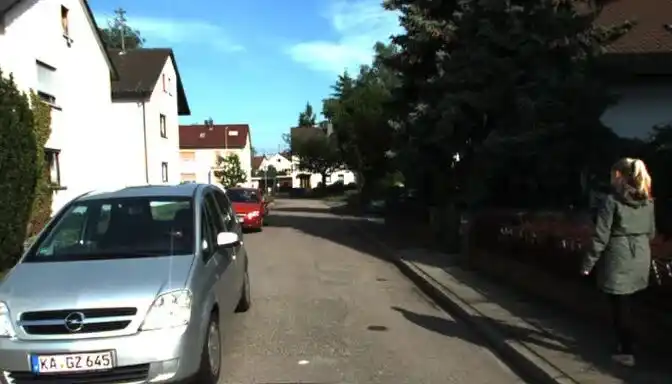
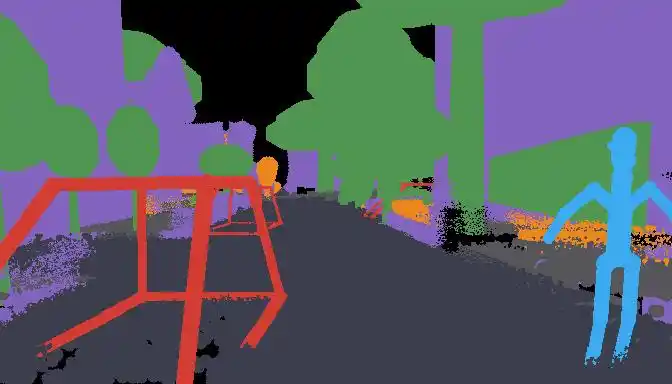
Figure 3b RGB cible d'une vidéo réelle (en haut), et proxy construit hors ligne à l'aide de l'étalonnage de la caméra, de la reconstruction 3D et de l'annotation d'objets (en bas).
Les données de gameplay utilisées dans l'article comprennent 157 enregistrements, soit environ 5,6 heures de vidéo source. L'équipe a échantillonné à des intervalles de 2 secondes, obtenant 9 420 séquences d'entraînement de 5 secondes ; chaque cible RGB contient 124 images, avec une résolution de 1344×768 et une fréquence d'images de 24 FPS. Le proxy correspondant contient également 124 images, avec une résolution de 336×192, combinant une profondeur en log fixe et une carte d'ID sémantiques catégorielle.
Le même enregistrement d'exécution peut être recompilé en proxy avec une couverture et une granularité d'information différentes, sans avoir à réenregistrer le RGB.
L'article montre également sur KITTI-360 le processus de construction hors ligne de paires proxy-observation pour des vidéos réelles, illustrant la possibilité d'étendre cette interface aux données réelles ; l'adaptation actuelle du modèle vidéo n'utilise que les données de gameplay appariées.
Comment fonctionne le système prototype ?
Le prototype actuel utilise le backbone Ref2VA de MiniMax-H3 comme modèle vidéo, adaptant les 50 blocs transformer avec un LoRA de rang 128, soit environ 596 millions de paramètres entraînables. L'entraînement utilise 8 GPU NVIDIA H800, pour un total de 3 époques et 3 534 étapes d'optimisation.
Lors de l'inférence, GPT-5.6 Sol joue le rôle d'agent de codage. Le système lui fournit les contrôles de base du joueur, le traitement des collisions, la boucle de mise à jour d'exécution, des modèles de scène de moteur de jeu et de logique de gameplay existants, ainsi que les primitives proxy utilisées en phase d'entraînement. L'agent de codage peut combiner, étendre et réécrire ce code pour construire un monde simple, exécutable et contrôlable par le joueur ; la géométrie 3D grossière ne sert qu'à exprimer le proxy et n'est pas directement utilisée comme image finale.
Pour chaque séquence de 5 secondes, GPT Image 2 génère une « ancre d'apparence » (appearance anchor) basée sur la première image du proxy et le texte ; MiniMax-H3 génère ensuite la vidéo RGB de 124 images, 1344×768, 24 FPS, en combinant la première image, la séquence complète du proxy et le texte.
Les vidéos plus longues sont générées via une fenêtre glissante avec un chevauchement de 34 images : la fenêtre suivante hérite du contexte RGB de la fin de la fenêtre précédente et réutilise la même ancre d'apparence, pour maintenir la continuité locale et l'apparence globale de l'identité.
Résultats expérimentaux
Les résultats qualitatifs montrent que, même en utilisant seulement environ 5,6 heures de vidéo source de gameplay pour l'adaptation LoRA, le modèle peut toujours suivre la position des personnages, les trajectoires d'action, la disposition de la scène et les mouvements de caméra spécifiés par le proxy, tout en ajoutant des textures, éclairages et dynamiques locales riches, même lorsque le rôle, l'environnement et le style s'écartent nettement de l'apparence d'entraînement.
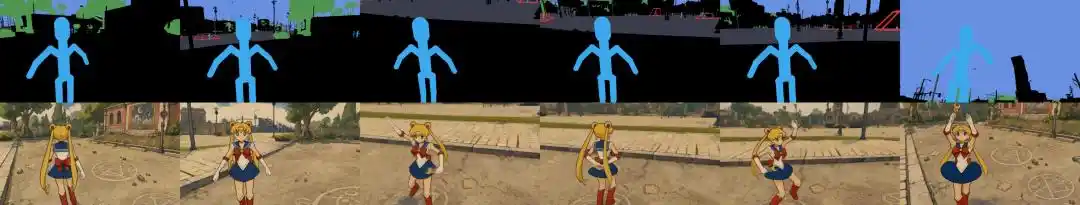
Figure 4 Le proxy fournit la position des personnages et les trajectoires d'action, le modèle vidéo rend le même squelette grossier en personnages d'identité et de style artistique différents. Haut : proxy ; Bas : résultat généré.
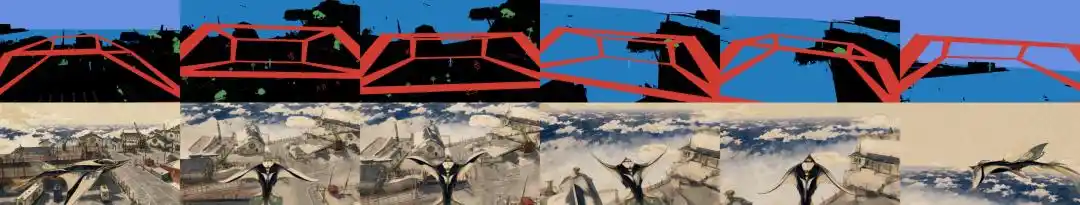
Figure 5 Des primitives géométriques simples imposent des contraintes sur des objets complexes et des mouvements de caméra. Haut : proxy ; Bas : résultat généré.
Par exemple, la même primitive humaine grossière peut être représentée comme des rôles d'identité et de style artistique totalement différents ; un modèle filaire ou une boîte peut contraindre la position et le mouvement approximatif des véhicules, bateaux et autres objets complexes ; la même interface proxy peut également exprimer la course, la danse, la natation, la chute et un mouvement de caméra encerclant.
On voit ainsi que le proxy fixe l'ossature spatio-temporelle que l'observation actuelle doit suivre, et non les assets et le style graphique du jeu d'entraînement.
La page du projet présente également des comparaisons vidéo avec des modèles de monde vidéo conditionnés par action ou caméra.
Cette comparaison porte sur la granularité du contrôle et le résultat visuel : le proxy fournit directement le mouvement des entités et les changements de perspective image par image, permettant ainsi d'imposer des contraintes spatio-temporelles plus fines et plus directes ; l'article ne présente pas ces résultats comme une comparaison de latence d'inférence.
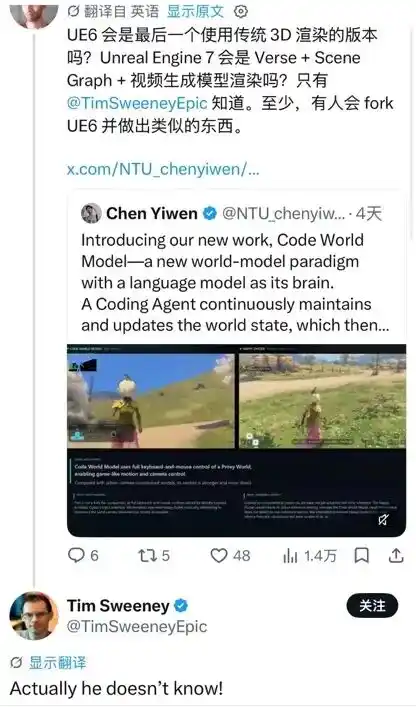
Un internaute a commenté : « Unreal Engine 6 sera-t-il le dernier moteur de jeu créé avec des méthodes 3D traditionnelles ? Peut-être qu'Unreal Engine 7 utilisera une solution technique similaire. Seul le PDG d'Unreal Engine, Tim, connaît la réponse. »
Tim a ensuite répondu : « Je ne sais pas non plus ! »
Conclusion : Décider d'abord ce qui se passe dans le monde, puis générer à quoi cela ressemble
Les précédents modèles de monde vidéo apprenaient principalement « comment l'observation continue ». Le Code World Model pousse la question un peu plus loin : avant de générer la prochaine observation, il maintient d'abord ce qu'est le monde actuellement, quelles règles il suit, et pourquoi les conséquences d'un événement persistent.
Un monde génératif véritablement ouvert a besoin à la fois de l'imagination visuelle des modèles vidéo et de mécanismes d'exécution capables de maintenir les connaissances, objectifs, règles, relations et conséquences causales. L'essence du Code World Model peut se résumer en une phrase : laisser le code décider de ce qui se passe dans le monde, et laisser le modèle vidéo décider à quoi tout cela ressemble.
Références : https://arxiv.org/abs/2608.25927
Cet article provient du compte WeChat officiel « Xin Zhi Yuan », auteur : Xin Zhi Yuan ; éditeur : LRST