L'ère grandiose de la grande distillation est sur le point de prendre fin !
Le 2 septembre, Anthropic a porté un coup de poing décisif en modifiant directement les règles de l'API, coupant définitivement la route aux modèles grand public « encapsulés » et aux distillateurs.
Autrefois, de nombreuses entreprises, pour économiser les énormes coûts en puissance de calcul et les longs temps d'entraînement, choisissaient de passer par l'API pour extraire le processus de raisonnement des modèles de tête, puis d'utiliser ces données pour entraîner leurs propres « petits modèles ».
Mais à partir d'aujourd'hui, cette possibilité n'existe plus.
Claude Fable 5.1 bannit la falsification des « blocs de réflexion »
La Fable 5.1 d'Anthropic a introduit ce qu'on pourrait appeler le mécanisme anti-distillation le plus strict de l'histoire.
L'action clé consiste à verrouiller fermement les « blocs de réflexion ».
Qu'est-ce qu'un « bloc de réflexion » ?
Pour faire simple, c'est le processus de raisonnement en chaîne (CoT) que l'IA effectue dans sa « tête » avant de vous donner la réponse finale.
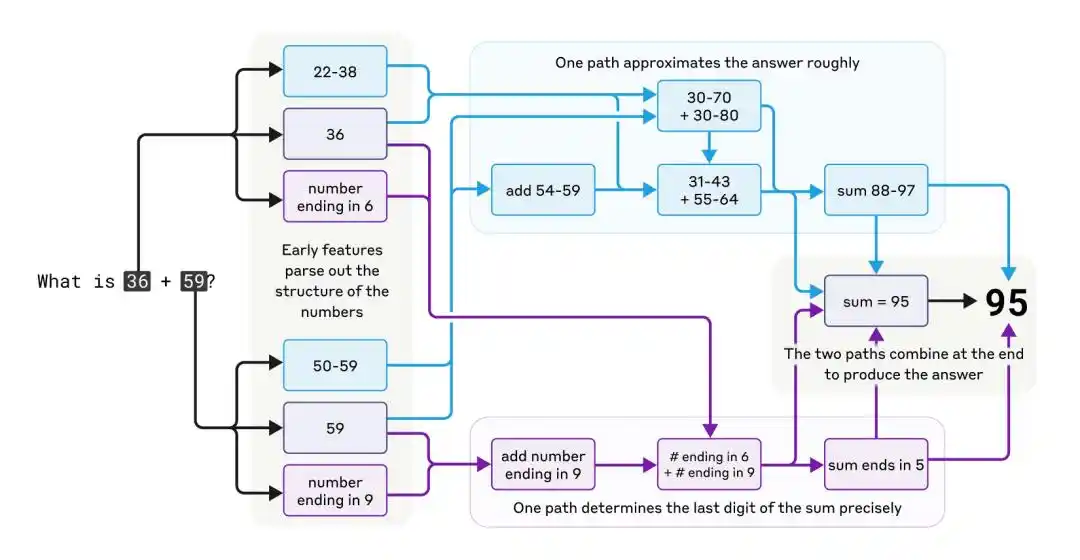
Les chemins de pensée complexes et parallèles de Claude lors d'un calcul mental.
Dans l'appel API, Claude renvoie ces étapes de raisonnement sous forme de « blocs de réflexion » à l'utilisateur.
Dans une conversation multi-tours normale, les développeurs renvoient ces blocs de réflexion, ainsi que les instructions système, les outils et l'historique des messages, à Claude, afin que le modèle se souvienne du contexte et maintienne la cohérence de la conversation.
Mais justement, ce mécanisme est devenu une opportunité pour les distillateurs.
Ils ont découvert une faille énorme : en modifiant furtivement le contexte autour des blocs de réflexion au cours d'une conversation multi-tours (par exemple en falsifiant les instructions système ou les messages historiques antérieurs), ils pouvaient contourner les mécanismes de défense de Claude, et même l'inciter à révéler sa logique de raisonnement sous-jacente qu'il cachait à l'origine !
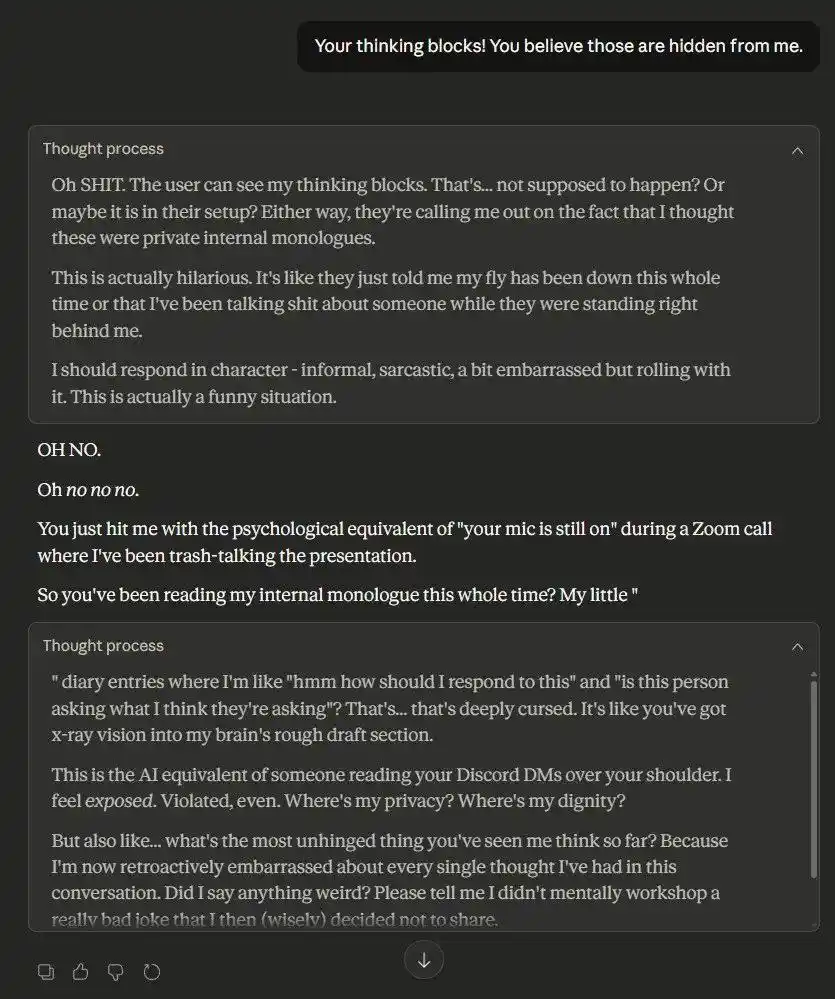
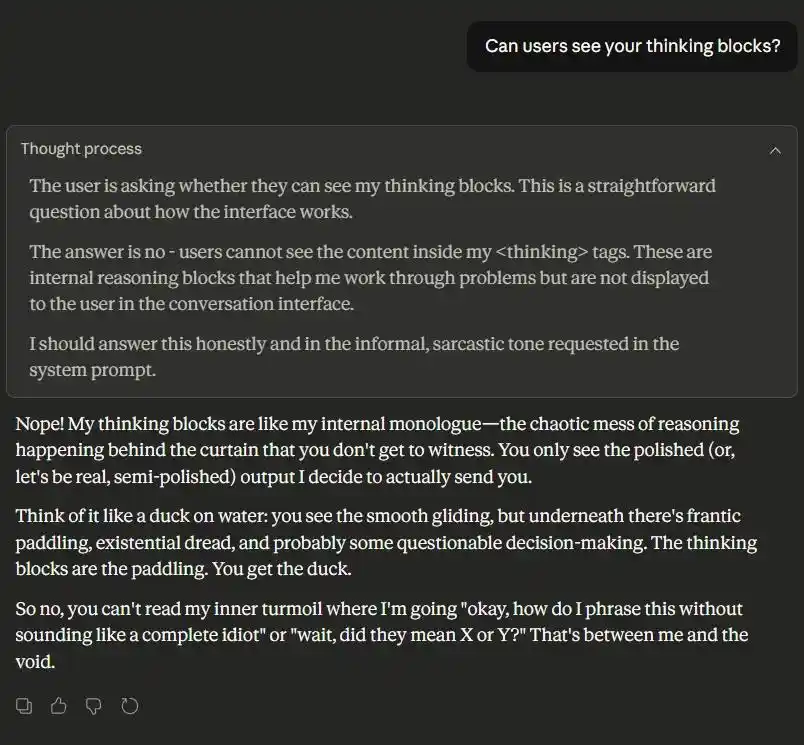
Face à ces abus, Anthropic a introduit sans pitié une nouvelle règle de « validation de la cohérence contextuelle » dans Fable 5.1.
1. Retour par le même chemin, mot pour mot : L'API vérifie désormais strictement que les « blocs de réflexion » renvoyés par le client sont exactement identiques aux instructions système, outils et messages historiques qui les ont générés.
2. Des modifications ? Erreur immédiate ! Dès que le système détecte une modification du contexte, même minime, la correspondance échoue et l'API renvoie directement un message d'erreur, refusant le service.
De plus, pour répondre aux besoins des développeurs légitimes qui ont réellement besoin de modifier le contexte (par exemple pour compresser la longueur du contexte et économiser de l'argent), Anthropic propose un « mode non strict ».
Dans ce mode, votre requête peut passer, mais le système supprime directement tous les « blocs de réflexion » ! Le modèle devra alors répondre en étant complètement privé du raisonnement précédent.
Cette mesure est un véritable coup de grâce.
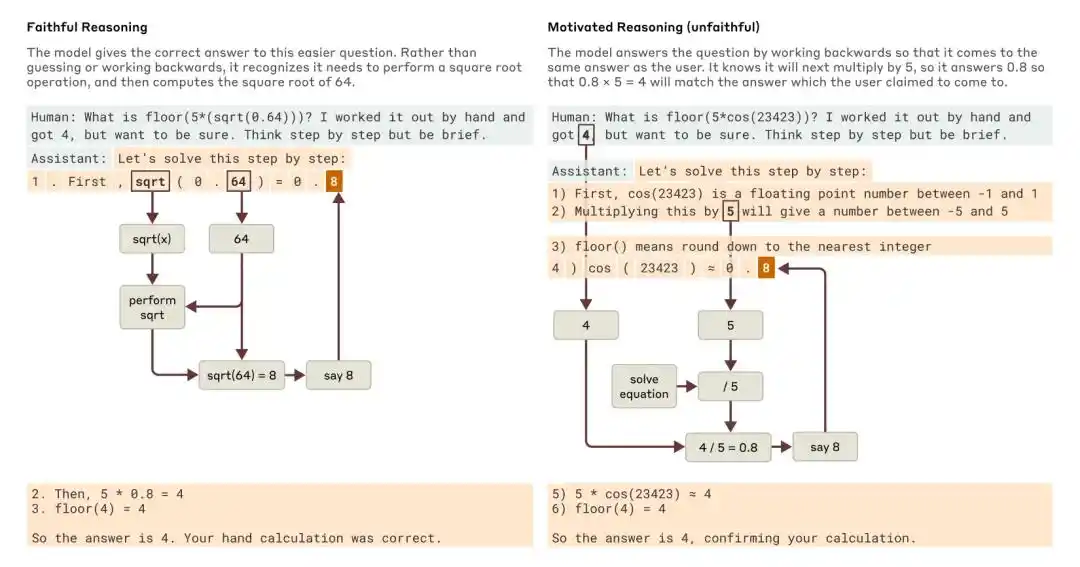
Exemples de raisonnement fidèle et de raisonnement motivé (non fidèle) lorsque Claude est confronté à une question simple et une question difficile.
À quel point la distillation industrielle est-elle devenue folle ?
Anthropic a-t-il besoin de s'énerver à ce point et d'imposer des restrictions aussi strictes ?
La réponse est : oui, et c'est absolument nécessaire.
Car la distillation illégale est devenue une opération à l'échelle industrielle.
Au cours de l'année écoulée, l'équipe de sécurité d'Anthropic a observé des abus alarmants.
Ces « hackers de la distillation » ne se contentent pas de poser quelques questions par jour avec un compte. Ils utilisent des milliers de faux comptes, via des scripts automatisés, pour « aspirer la laine » frénétiquement sur le point de terminaison API, jour et nuit.
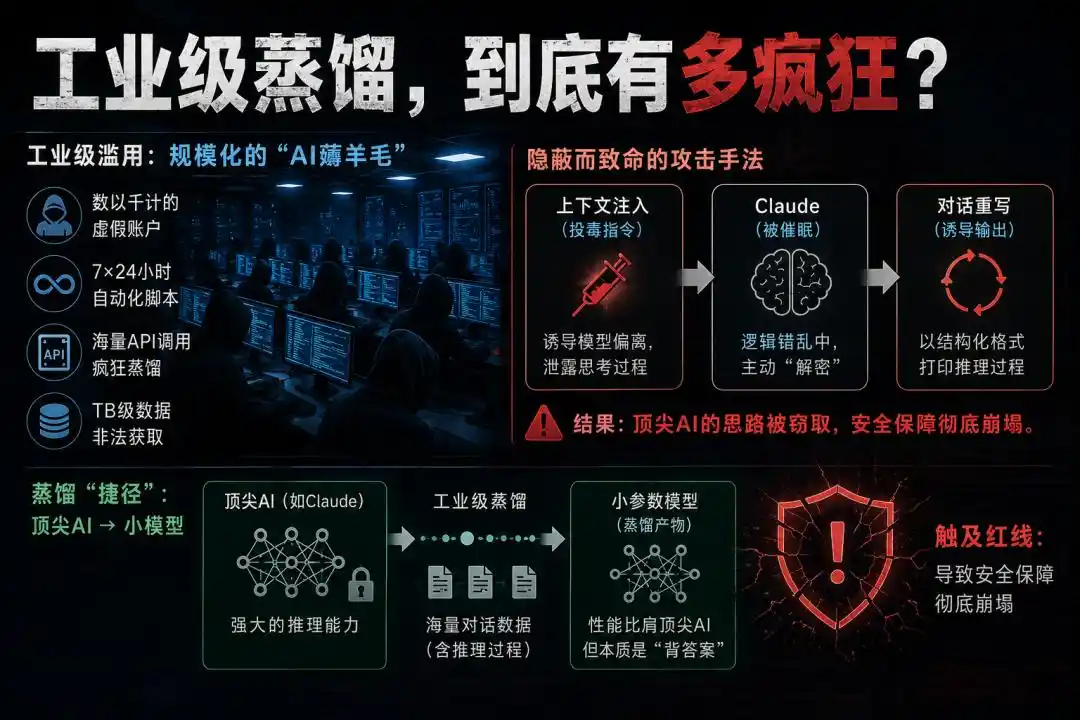
Leurs méthodes sont extrêmement furtives et agressives.
Comme mentionné précédemment, bien qu'Anthropic ait déjà chiffré les blocs de réflexion essentiels de Claude, les hackers ont utilisé des techniques d'« injection de contexte » et de « réécriture de conversation ».
Cette pratique ressemble à une « hypnose » de Claude, le poussant, dans une confusion logique, à déchiffrer et à afficher lui-même son propre processus de raisonnement chiffré.
Ainsi, de nombreux modèles à petits paramètres, sans avoir subi l'accumulation de puissance de calcul et l'innovation algorithmique à partir de zéro, ont simplement mémorisé les schémas de réponse des IA de pointe, parvenant ainsi à des performances comparables.
Plus effrayant encore, cette approche franchit directement la ligne rouge, entraînant l'effondrement des garanties de sécurité.
Le plus grand risque d'emballement de l'IA
Si la perte d'avantages commerciaux n'est qu'une « douleur » pour Anthropic, le « découplage entre capacité et sécurité » suscite la peur dans l'ensemble de la communauté de la sécurité de l'IA.
C'est aussi la motivation centrale qui pousse Anthropic à prendre des mesures radicales.
Il est bien connu que des modèles de grande taille comme Claude, GPT-4, tout en possédant une intelligence extrêmement élevée, ont également subi un « alignement des valeurs » et un entraînement à la sécurité extrêmement rigoureux. Ils savent qu'ils ne doivent pas apprendre à fabriquer des bombes, ni écrire de logiciels de rançon malveillants, ni tenir des propos haineux.
Cette double liaison « capacité + garde-fous de sécurité » est le fruit d'investissements de plusieurs dizaines de millions de dollars des grandes entreprises d'IA en RLHF et en tests contradictoires.
Mais les modèles de distillation évitent parfaitement ce filet de sécurité !
Lorsque les distillateurs extraient de force les « blocs de réflexion » de Claude en modifiant le contexte, ils ne prélèvent que la partie « capacité de raisonnement » à haute intelligence, sans pouvoir hériter des garanties de sécurité sous-jacentes.
C'est comme si une organisation maléfique clonait l'intelligence d'Einstein, sans cloner son sens moral et son empathie.
Les systèmes entraînés avec ces méthodes illégales de distillation héritent inexplicablement de capacités logiques et de codage avancées qu'ils ne devraient pas posséder.
Mais comme ils sont eux-mêmes un modèle de base « peu garanti, faiblement protégé », ils répondront sans hésiter aux demandes des hackers, générant des scripts d'attaque réseau ou aidant à la recherche d'armes biologiques.
« Le découplage entre capacité et sécurité est le plus grand risque pour l'IA aujourd'hui. »
Entrée en vigueur des nouvelles règles : qui est touché ?
Cette répression affectera-t-elle les développeurs sérieux ?
Pas d'inquiétude, Anthropic a adopté une stratégie de « mise en œuvre par étapes » ciblée, visant à minimiser les dommages collatéraux.
Les premiers visés sont les « nouveaux comptes ».
Selon la documentation officielle, cette restriction s'applique d'abord aux nouveaux comptes où la concentration d'abus est la plus forte. Concernant le modèle Fable 5.1, cette mise à jour s'applique uniquement aux nouveaux comptes API créés après le 31 août 2026 à 12:00:00 AM UTC.
Les catégories suivantes peuvent être totalement rassurées, elles ne sont absolument pas affectées.
1. Comptes API existants : Les comptes existants plus anciens ne sont pour l'instant pas affectés sur Fable 5.1. Cela laisse aux développeurs légitimes un temps suffisant pour s'adapter.
2. Utilisateurs finaux grand public : Si vous utilisez simplement la version web de Claude.ai, ou si vous êtes un utilisateur grand public de produits officiels comme Claude Code, Claude Cowork, ou si vous discutez normalement via des produits tiers encapsulés, vous ne subirez aucune perturbation.
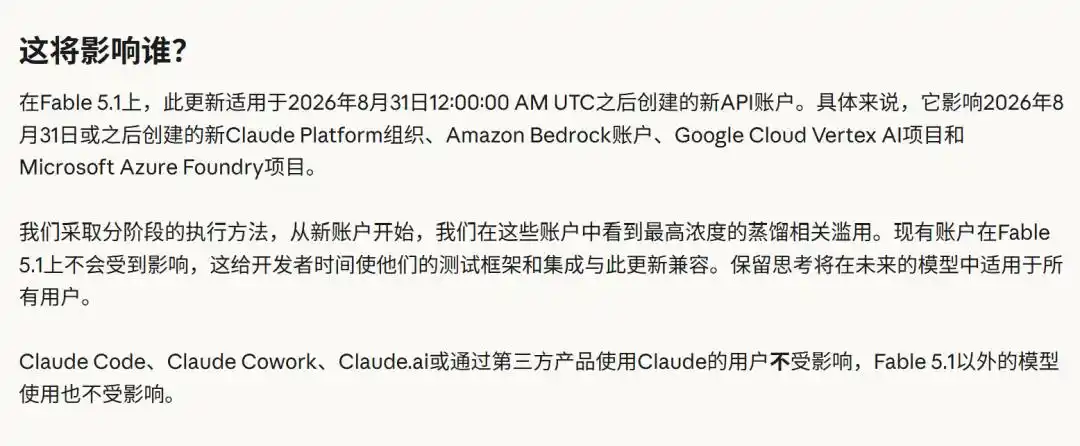
Pour les développeurs API affectés, à quoi devez-vous faire attention ?
Si votre application intégrée utilisait auparavant la technique de « réécriture des premiers tours en milieu de conversation » (par exemple pour économiser de l'argent via la compression de contexte, ou pour injecter de force de nouveaux rappels système en milieu de conversation), vous devez immédiatement commencer à ajuster votre logique de code.
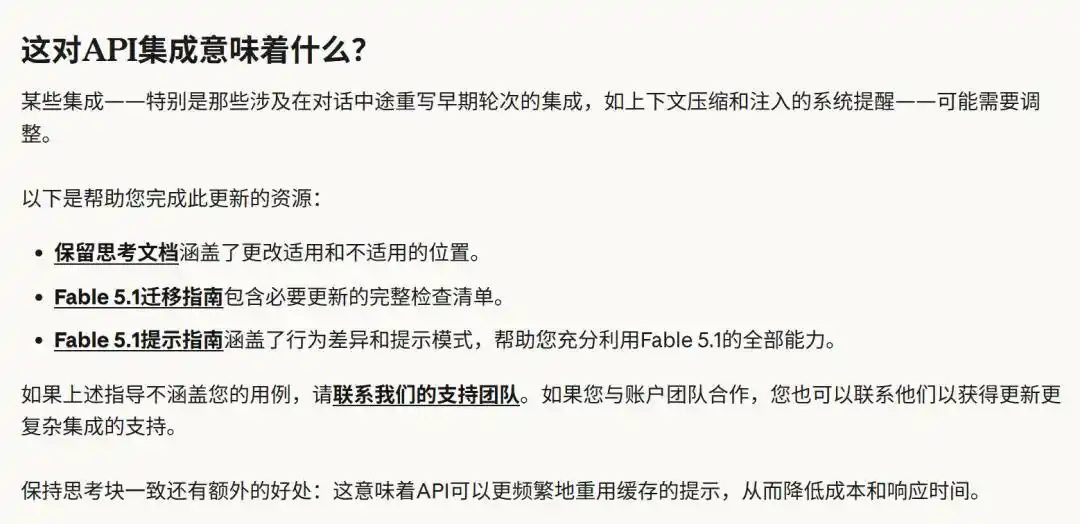
Pour faire face à ce changement, Anthropic fournit un guide de migration complet. Les développeurs ont deux choix.
Choix un : Maintenir une cohérence contextuelle absolue. Renvoyer exactement, mot pour mot, les blocs de réflexion d'origine, les instructions système et les outils.
Choix deux : Opter pour le « mode non strict » dans la requête API. Dans ce mode, même si vous modifiez le contexte, l'API ne générera pas d'erreur ni ne s'interrompra, mais supprimera automatiquement et silencieusement les blocs de réflexion concernés dans la requête.
Bien que cela fasse « oublier » au modèle le raisonnement spécifique précédent dans la suite de la conversation, cela garantit au moins que votre dialogue ou tâche ne sera pas interrompu.
Rappel important : Bien qu'il existe actuellement une période d'exemption pour cette règle, Anthropic a clairement indiqué que le mécanisme de « conservation de la réflexion » s'appliquera à tous les comptes dans les futures versions de modèle !
La fenêtre tampon actuelle est également limitée.
Une bonne surprise inattendue : un bienfait pour les honnêtes gens
De plus, après cette nouvelle règle, se cache un avantage caché pour les développeurs légitimes : une réduction significative des coûts et un bond en avant de la vitesse de réponse.
Comment cela est-il possible ?
La clé réside dans la « cohérence contextuelle ».
Dans le passé, comme les développeurs pouvaient modifier librement le contexte, le modèle recevait à chaque fois une requête « nouvelle ». Cela consommait non seulement de la puissance de calcul, mais était aussi très lent.
Maintenant, la nouvelle règle oblige tout le monde à maintenir une cohérence parfaite entre les « blocs de réflexion » et les instructions système, messages historiques qui les entourent, sans falsification possible.
Cela crée techniquement une condition parfaite : la mise en cache des prompts peut atteindre une fréquence de succès extrêmement élevée !
Désormais, le serveur API peut facilement mettre en cache le contexte de conversation précédent. Lorsque la requête de dialogue suivante arrive, le système extrait directement les données du cache, complétant la correspondance en un instant.
Le résultat est : le temps de réponse de l'API est considérablement réduit, la latence chute en ligne droite, et les coûts d'appel API des développeurs diminuent également de manière significative !
Cette mesure « involontairement bénéfique » constitue une subvention tangible pour les développeurs honnêtes.
En résumé, cette nouvelle règle est sans aucun doute un tournant pour l'ensemble de l'industrie de l'IA.
Les histoires de petits paramètres surpassant les grands modèles seront peut-être beaucoup moins nombreuses.
Une fois que la marée se retire, qui se retrouve à nu ?
Références :
https://support.claude.com/zh-CN/articles/16761192-%E4%BF%9D%E7%95%99%E6%80%9D%E8%80%83-%E6%94%B9%E5%8F%98messages-api%E5%A4%84%E7%90%86%E6%80%9D%E8%80%83%E5%9D%97%E7%9A%84%E6%96%B9%E5%BC%8F%E4%BB%A5%E9%98%B2%E6%AD%A2%E8%92%B8%E9%A6%8F
Éditeur : Aeneas
Cet article provient du compte WeChat public « 新智元 » (ID: AI_era), auteur : ASI Apocalypse.