El último muro de las matemáticas para la IA, se derrumba: GPT-6 Astra supera por completo FrontierMath Nivel 4

marsbitPublicado a 2026-09-11Actualizado a 2026-09-11

Resumen

El muro final de las matemáticas para la IA ha caído: GPT-6 Astra resuelve la última pregunta de FrontierMath Tier 4. FrontierMath, un conjunto de problemas matemáticos avanzados creado por más de 60 matemáticos (incluido Terence Tao) para evaluar los límites de la IA, ha visto cómo su nivel más difícil, el Tier 4, ha sido completamente superado. Aunque GPT-6 Astra obtuvo un 97.6% en una prueba reciente, su verdadero logro fue resolver la única pregunta que ninguna IA había logrado antes, completando así el conjunto. Lanzado en 2024 para evitar que los modelos superaran fácilmente los benchmarks existentes, FrontierMath constaba de 4 niveles de dificultad creciente. El Tier 4, añadido en 2025, contenía 50 problemas de nivel de investigación diseñados por profesores y posdoctorados. En un principio, se creía que algunos podrían resistir "décadas" ante la IA. Sin embargo, tras revisiones y correcciones, el progreso fue rápido: de un 2% inicial, los modelos líderes superaron el 90% en poco más de un año. Jay Pantone, profesor y creador de problemas, señaló que, a diferencia de intentos anteriores donde la IA buscaba atajos numéricos, la solución de Astra esta vez se acercó mucho a la esperada. Aunque este hito marca la "saturación" del Tier 4, no significa el fin del desafío. FrontierMath ya ha evolucionado hacia nuevos frentes aún más complejos: "Open Problems" (problemas de investigación reales sin resolver) y "FrontierMath Erdős" (problemas abiertos formalizados para verif...

Acaba de ocurrir: el último problema del Nivel 4 de FrontierMath, ha sido resuelto por GPT-6 Astra.

Con esto, todos los problemas de este conjunto de pruebas de nivel investigador, alguna vez considerado la pesadilla matemática de los modelos grandes, han sido resueltos con éxito al menos una vez por una IA.

Epoch AI también ha emitido oficialmente su conclusión: FrontierMath Nivel 4, saturado.
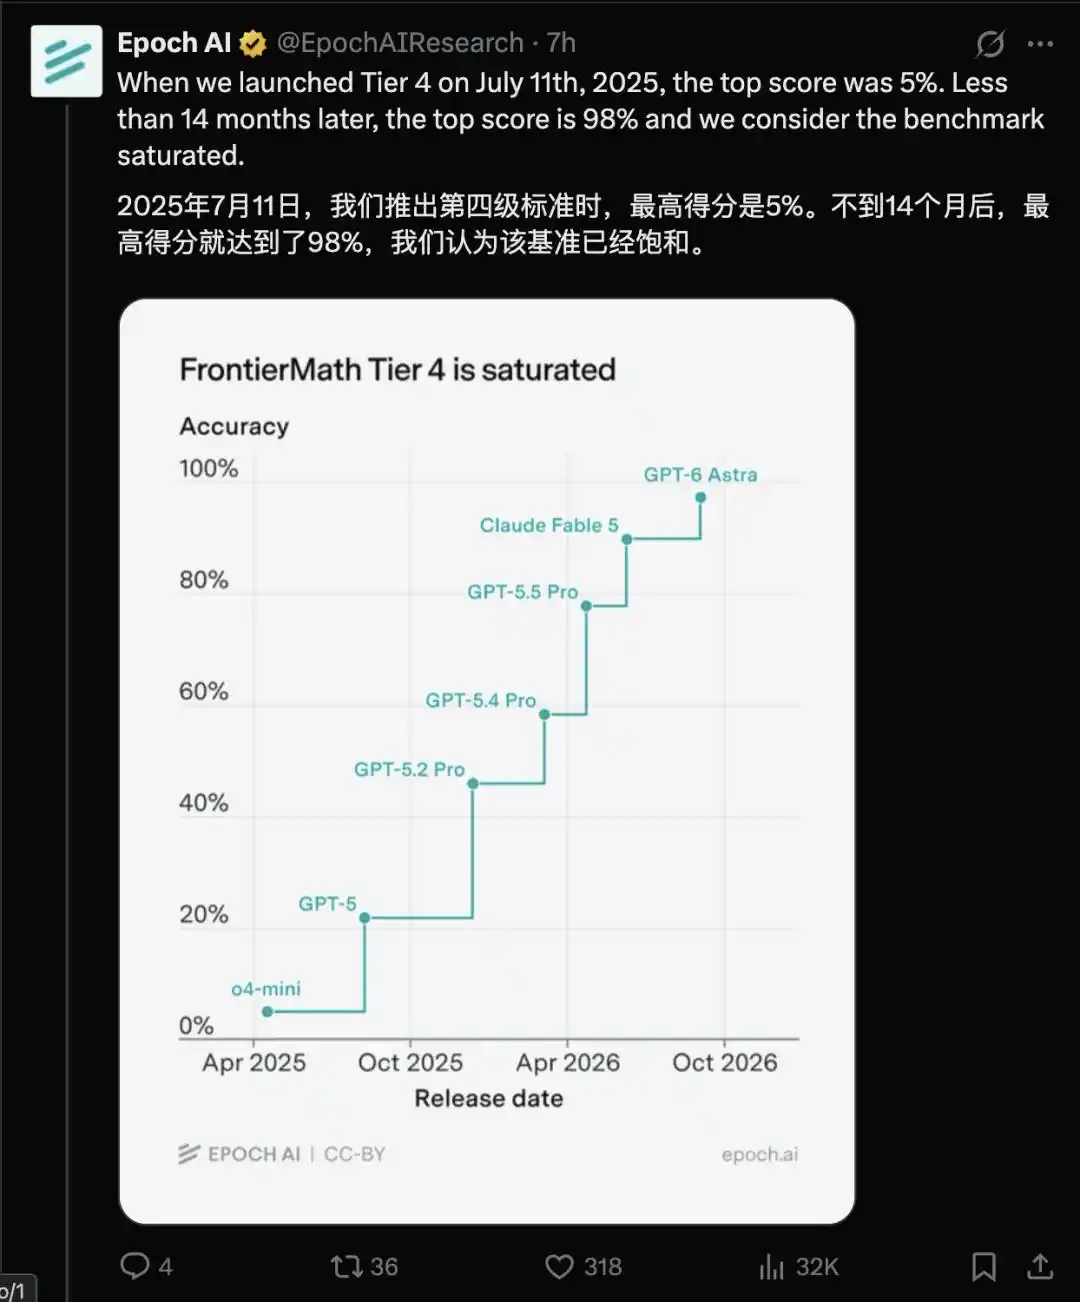
Aunque, por el gráfico anterior, se ve que Astra no ha llegado directamente al 100% (el resultado publicado por OpenAI es del 97,6%).

Según el algoritmo de Epoch, "resolver todos" significa que, tras acumular los intentos de diferentes modelos en diferentes momentos, cada problema del Nivel 4 ha tenido al menos una solución exitosa.

Y Astra acabó precisamente con el único que no había sido superado por una IA hasta entonces.

(En términos sencillos: es posible que Astra fallara en alguna prueba, pero el problema que resolvió correctamente era el único que faltaba).
Hay que reconocer que la velocidad de este desarrollo es realmente alucinante.

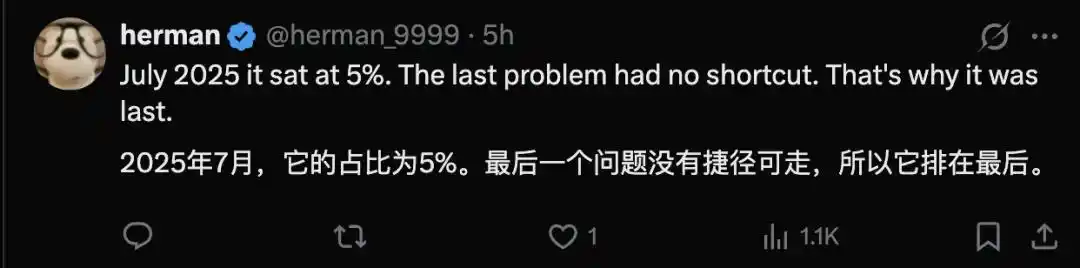
Si sigues las evaluaciones de modelos, sabrás que el 11 de julio de 2025, cuando se lanzó por primera vez el Nivel 4, la puntuación más alta rondaba solo el 5%.

Ahora, apenas un año y dos meses después, ese "muro infranqueable" se ha convertido en un "peldaño", y el último problema difícil de resolver para la IA sin atajos numéricos ha sido superado.

El creador de problemas, Jay Pantone, profesor asociado de matemáticas en la Universidad de Marquette, también comentó que las IA solían buscar atajos numéricos, pero esta vez, el enfoque de la IA fue bastante similar al suyo.
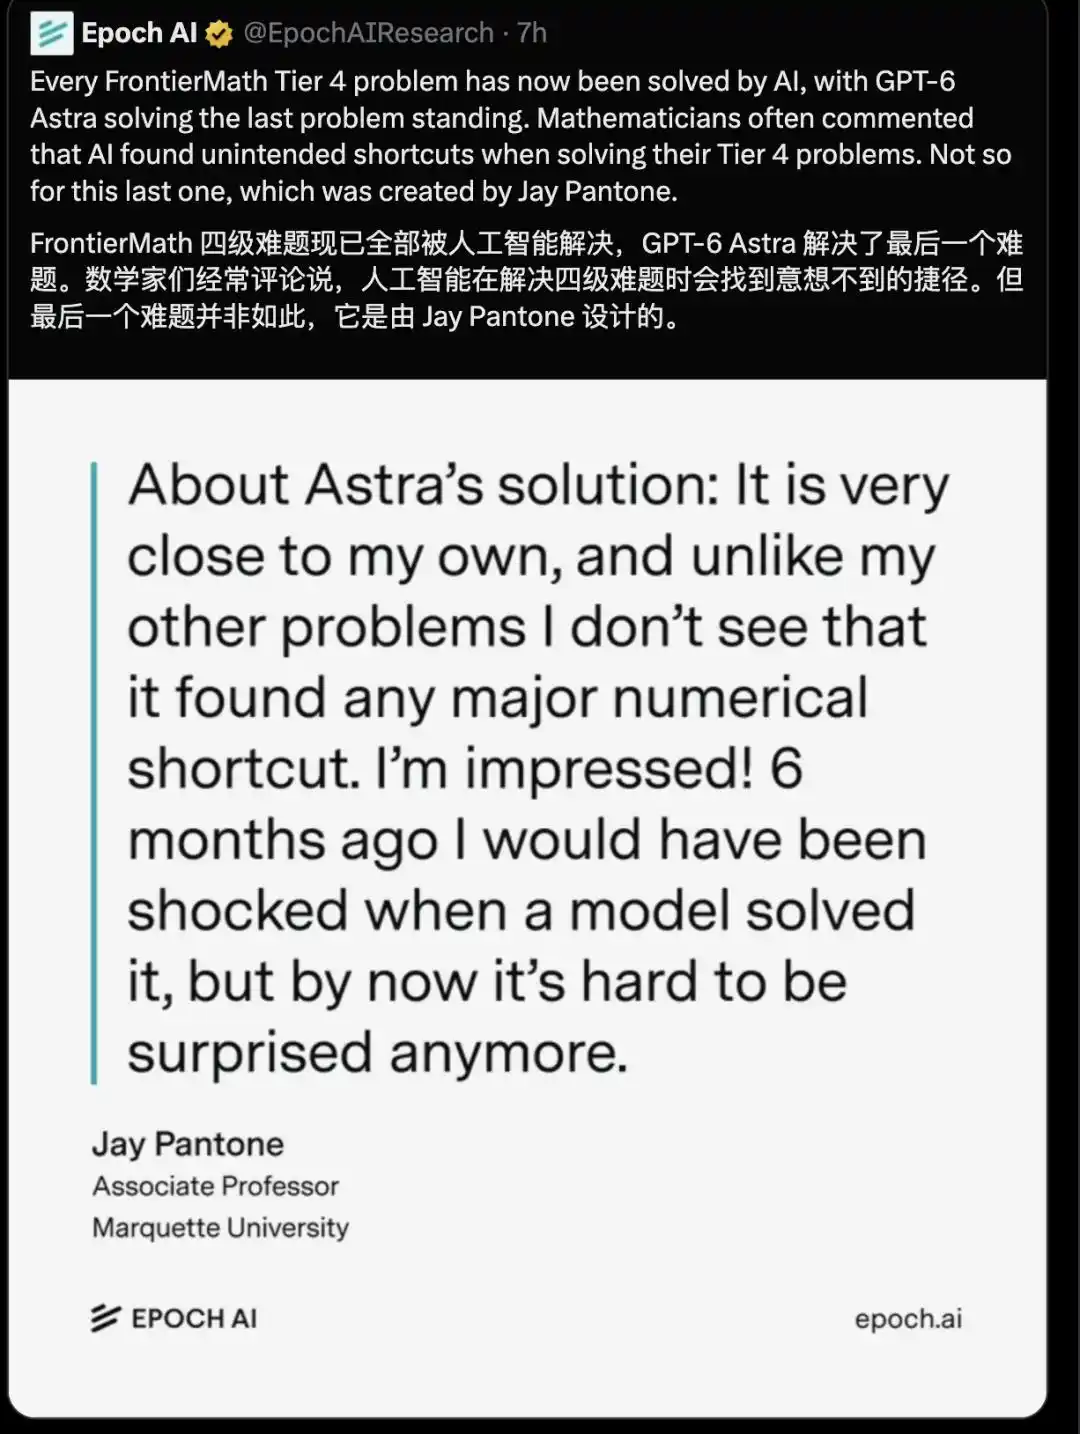
Sin embargo, justo cuando GPT-6 Astra ha estado atacando fuertemente el mundo matemático últimamente, resolviendo problemas del milenio cada dos por tres, Pantone dijo que ya le cuesta mucho sorprenderse.

Puede decirse que las matemáticas se han convertido en uno de los campos donde Astra está dejando más huella recientemente.

De menos del 2%, a añadir una "línea defensiva de nivel investigador" específica

FrontierMath se lanzó por primera vez el 7 de noviembre de 2024, y su propósito original era evitar que los benchmarks matemáticos fueran superados demasiado rápido por la IA.

En ese momento, benchmarks tradicionales como GSM8K y MATH cada vez tenían más dificultad para distinguir a los modelos punteros, por lo que Epoch AI, junto con más de 60 matemáticos, diseñó un nuevo conjunto de problemas originales nunca antes publicados.

Entre ellos, se incluían ganadores de la Medalla Fields como Terence Tao, Timothy Gowers y Richard Borcherds.

Tras revisar algunos de los problemas de nivel investigador, Tao comentó entonces que eran "extremadamente difíciles", e incluso predijo que el Nivel 3, el más difícil, podría mantener a la IA bloqueada durante algunos años más.
Los primeros resultados no defraudaron: la tasa de acierto de los modelos líderes era inferior al 2%.

Concretamente, al principio, el banco central de FrontierMath contenía 300 problemas, divididos en tres niveles de dificultad: Nivel 1, Nivel 2 y Nivel 3.
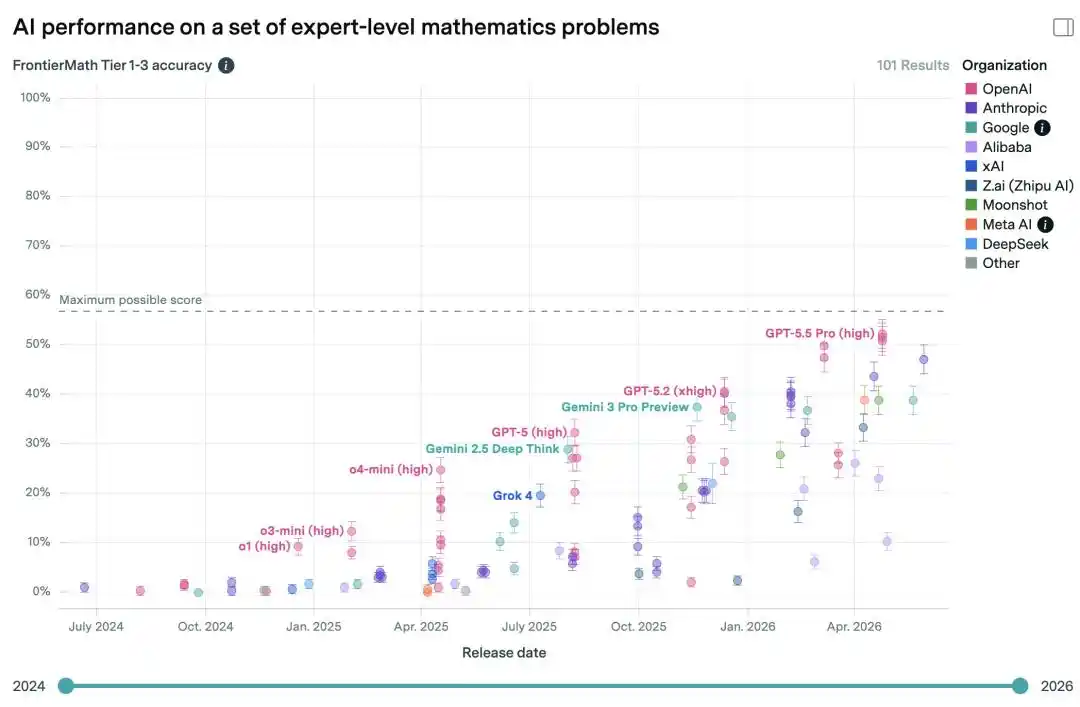
El Nivel 1 se asemejaba aproximadamente a problemas de pregrado de alta dificultad y olimpiadas matemáticas, pero permitiendo el uso de herramientas más avanzadas; el Nivel 2 alcanzaba la dificultad de posgrado avanzado; el Nivel 3 se acercaba más a problemas exploratorios de investigación que podrían encontrar doctorandos en sus primeras etapas.

Pero con la aparición de modelos de razonamiento, estos tres primeros niveles también empezaron a quedarse cortos, por lo que en 2025, Epoch añadió un nivel más arriba: el Nivel 4.

Los problemas del Nivel 4 fueron diseñados principalmente por profesores de matemáticas e investigadores posdoctorales. Cada uno realizaba investigaciones a corto plazo de varias semanas centradas en su propia área, y luego comprimía los resultados en un problema que pudiera verificarse automáticamente.
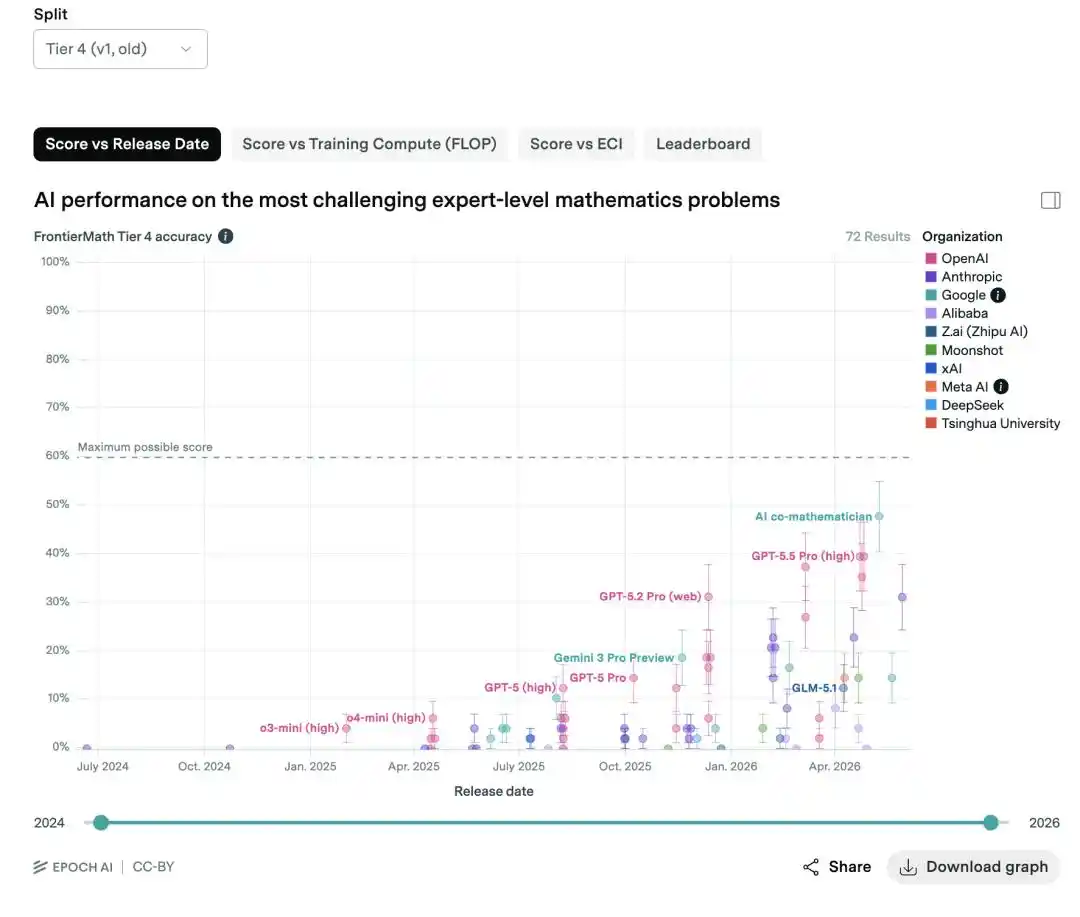
Inicialmente, el Nivel 4 contenía 50 problemas. Cubrían áreas como análisis, teoría de números, matemática discreta, topología, geometría algebraica...

En el momento de su lanzamiento, sumando todos los intentos de todos los modelos, solo 3 problemas habían sido resueltos, y algunas de esas soluciones dependían de suposiciones correctas pero no plenamente justificadas.

Debido a esto, en la página web pública de problemas de ejemplo, Epoch llegó a escribir: algunos de estos problemas podrían no ser resueltos por la IA en décadas.
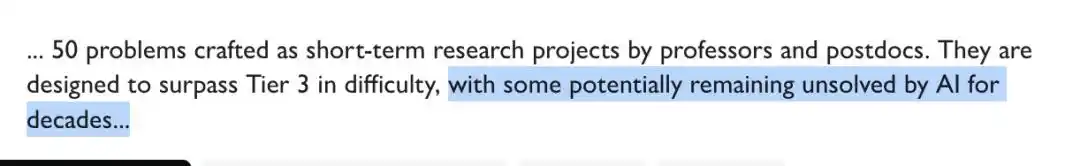
(Esta frase ahora se está usando repetidamente en su contra).

Sin embargo, a medida que los modelos se volvían más potentes, surgió otro problema: el propio banco de problemas empezaba a no resistir el "martilleo" de la IA.

OpenAI descubrió durante las pruebas que FrontierMath contenía más errores de los esperados.

Posteriormente, Epoch inició una auditoría independiente: primero utilizó GPT-5.5 y Claude Opus 4.7 para filtrar puntos sospechosos, y luego encargó a matemáticos que revisaran cada problema uno por uno. Finalmente, en junio de 2026, se lanzó la versión v2, en la que se corrigieron 12 problemas del Nivel 4, se eliminaron 7 y quedaron 43.

Tras la revisión, los resultados de los modelos siguieron mejorando rápidamente.

GPT-5.6 Sol alcanzó un 83,0%, Claude Fable 5 llegó al 90,2%, y con GPT-6 Astra, el resultado ya es del 97,6%.
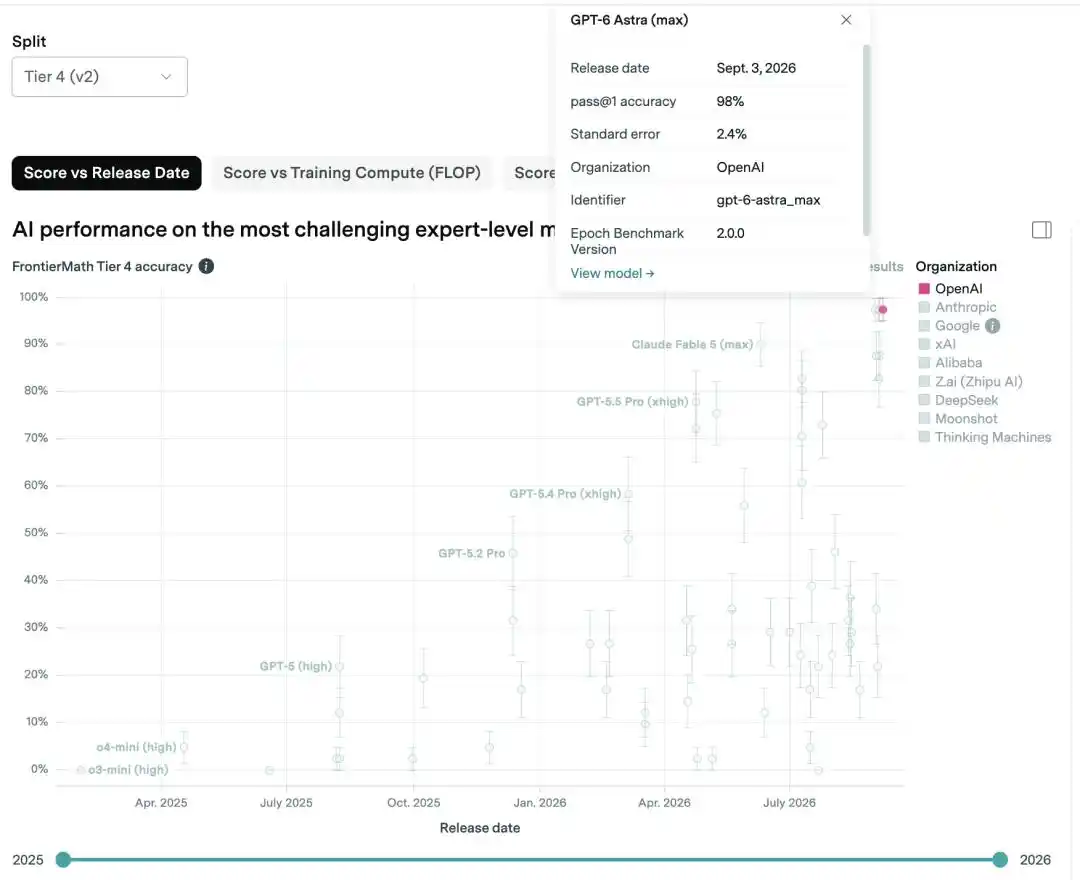
Y lo más crucial: Astra también resolvió el único problema que nunca antes había sido resuelto por una IA.
Así, cada problema del Nivel 4 ha sido superado al menos una vez por la IA. Esta línea defensiva de nivel investigador añadida específicamente para los modelos más potentes, finalmente también ha sido franqueada.

Sin embargo, esto no significa que "las matemáticas hayan sido resueltas por la IA". Al contrario, FrontierMath ya está avanzando hacia la siguiente etapa.

Ahora, además de los Niveles 1-4, todo el proyecto incluye auténticos Problemas Abiertos (Open Problems), y también FrontierMath Erdős, que formaliza problemas abiertos de Erdős en Lean.
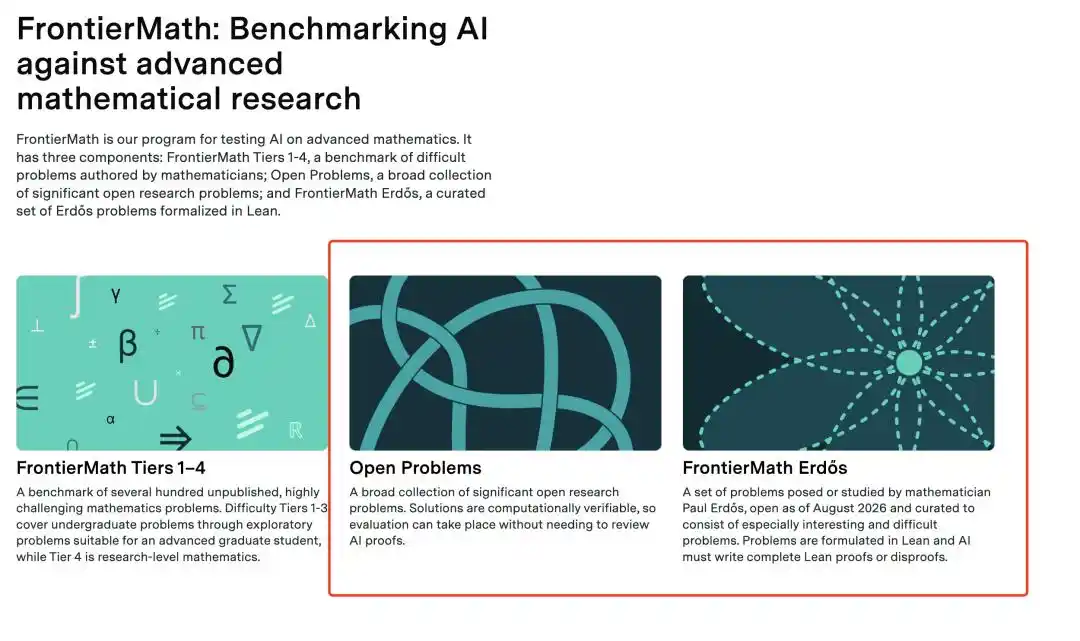
El primero evalúa a los modelos directamente con problemas de investigación aún no resueltos por la comunidad matemática; el segundo exige a la IA que escriba pruebas completas que puedan pasar la verificación formal.

Esta vez, Astra solo resolvió 2 de los 68 problemas de FrontierMath Erdős.

La historia continúa...

Este artículo proviene del WeChat Official Account "量子位" (Bit Cuántico), autor: henry

Preguntas relacionadas

Q¿Qué logro específico de GPT-6 Astra se anuncia en el artículo?

AGPT-6 Astra ha resuelto el último problema sin resolver del FrontierMath Tier 4, completando así la primera ronda de soluciones de IA para todo el conjunto de problemas de ese nivel.

Q¿Qué es el FrontierMath Tier 4 y por qué se creó?

AEl FrontierMath Tier 4 es un nivel de problemas de investigación matemática avanzada creado por Epoch AI y diseñado por profesores y posdoctorados. Se creó como una 'barrera de nivel de investigación' para evitar que los modelos de IA resolvieran demasiado rápido los benchmarks matemáticos existentes.

QSegún el artículo, ¿qué dijo el profesor Jay Pantone sobre la solución de Astra al último problema?

AEl profesor Jay Pantone, creador del problema, señaló que, a diferencia de soluciones anteriores de IA que a menudo tomaban atajos numéricos, el enfoque de GPT-6 Astra para este último problema fue muy similar al suyo.

Q¿Cómo ha evolucionado el rendimiento de los modelos de IA en FrontierMath Tier 4 desde su lanzamiento?

AAl lanzarse en julio de 2025, la tasa de precisión más alta de los modelos líderes en Tier 4 era de solo alrededor del 5%. En poco más de un año, modelos como GPT-5.6 Sol (83.0%), Claude Fable 5 (90.2%) y finalmente GPT-6 Astra (97.6%) han elevado drásticamente el rendimiento, hasta que Astra completó la solución de todos los problemas.

Q¿Qué indican los nuevos proyectos 'Open Problems' y 'FrontierMath Erdős' mencionados al final del artículo?

AIndican que el desafío para la IA en matemáticas avanza a un nivel superior. 'Open Problems' presenta problemas de investigación reales aún no resueltos por la comunidad matemática. 'FrontierMath Erdős' formaliza problemas abiertos de Erdős en Lean, requiriendo que la IA produzca pruebas completas y formalmente verificables, donde Astra solo ha resuelto 2 de 68 problemas.

Lecturas Relacionadas

La Explosión Matemática: OpenAI Resuelve 722 Problemas Matemáticos de la Noche a la Mañana, la Cuasi Hipótesis de Riemann Ha Sido Demostrada

Hoy, OpenAI ha sacudido a la comunidad matemática mundial al publicar de forma abrupta un repositorio de GitHub que contiene 722 manuscritos con soluciones a 372 familias de problemas matemáticos previamente no resueltos. El anuncio, hecho sin revisión por pares, ha generado tanto entusiasmo como indignación. Entre los logros más destacados, un modelo interno no publicado de OpenAI afirma haber demostrado una versión significativa de la Hipótesis de Riemann Generalizada, estableciendo que las funciones L de Dirichlet no tienen ceros en la región con parte real mayor que 7/8, y eliminando la posibilidad del "cero de Landau-Siegel". La prueba ha sido formalmente verificada con Lean. Otra contribución revolucionaria es la demostración, basada únicamente en P≠NP, de que los problemas que alcanzan el umbral de la relajación de programación semidefínica básica son NP-difíciles. Esto refuerza los límites teóricos para algoritmos de aproximación eficientes sin depender de la Conjetura de los Juegos Únicos. Además, se informan avances en la Conjetura de Hodge para variedades abelianas con multiplicación compleja y sus productos, y se resuelven problemas clásicos como la Conjetura de Chowla de dos puntos ordinarios y las Conjeturas de Mahler simétrica y general. Según OpenAI, la mayoría de estas pruebas fueron generadas automáticamente por su modelo en un promedio de 3 horas de "razonamiento" cada una. Este evento, denominado por algunos como una "masacre académica", ha desatado un intenso debate sobre el futuro de las matemáticas humanas ante la inteligencia artificial, marcando un posible punto de inflexión en la forma de descubrir conocimiento.

marsbitHace 1 hora(s)

La Explosión Matemática: OpenAI Resuelve 722 Problemas Matemáticos de la Noche a la Mañana, la Cuasi Hipótesis de Riemann Ha Sido Demostrada

marsbitHace 1 hora(s)

Se acercan las elecciones de mitad de mandato, en el mercado de valores estadounidense lo que realmente se negocia no es quién gana

Queda poco más de un mes para las elecciones legislativas de EE.UU., y la incertidumbre política vuelve a ser una variable para los mercados. Aunque históricamente los años electorales tienden a mostrar mayor volatilidad y un rendimiento ligeramente inferior (9,2% de subida promedio del S&P 500 desde 1937), no son un evento bajista per se. El patrón típico es un desempeño más débil en los primeros tres trimestres, seguido de una recuperación en el cuarto trimestre (alza promedio del 6,6%), a medida que se disipa la incertidumbre. El artículo subraya que los mercados no cotizan la victoria de un partido, sino las implicaciones políticas en la senda fiscal, regulatoria y de crecimiento. Una posible división en el control del Congreso podría llevar a un mayor estancamiento legislativo, pero los datos históricos muestran que el S&P 500 ha generado rentabilidades positivas promedio bajo distintos escenarios políticos. Para 2026, el factor clave no es el resultado electoral en sí, sino si, tras las elecciones, las variables fundamentales siguen siendo favorables. El foco debe estar en: 1) la trayectoria de los tipos de interés, 2) el crecimiento de los beneficios empresariales, y 3) si las políticas resultantes alteran sustancialmente las expectativas de flujos de caja. En definitiva, tras el evento electoral, el mercado volverá a fijarse en los fundamentos económicos.

marsbitHace 1 hora(s)

Se acercan las elecciones de mitad de mandato, en el mercado de valores estadounidense lo que realmente se negocia no es quién gana

marsbitHace 1 hora(s)

La IA no puede cambiar el "ADN" de SanDisk, ¿cuánto tiempo más podrá seguir siendo fuerte?

En los dos artículos anteriores, *Dolphin Research* destacó que la IA no solo está elevando la demanda de NAND, sino que también podría desafiar su cíclica naturaleza. Bajo una nueva lógica impulsada por la inferencia, la memoria NAND se ha vuelto esencial en la ruta de cálculo, funcionando como una "batería de Tokens". **1. ¿Cuánto durará este "superciclo" alcista?** Desde mediados de 2025, los precios spot del NAND han subido entre 5 y 6 veces. Se estima que el déficit de oferta se mantendrá hasta 2027 (~4-6% de brecha). Para 2028, con la nueva capacidad de YMTC y otros fabricantes, el mercado probablemente pasará a un exceso de oferta, poniendo fin al ciclo alcista. * **Oferta (2026-2028):** El crecimiento proviene principalmente de la migración tecnológica (más capas por chip, +73% del incremento), no de nuevas fábricas. La capacidad nueva se concentra en YMTC (China) hasta 2028, y luego en los grandes fabricantes globales a partir de 2029. * **Demanda:** La IA se convierte en el principal motor. La demanda de NAND para IA crecerá a un ~75% anual hasta 2028, representando entonces ~49% de la demanda total de servidores. La demanda no relacionada con IA crece solo un ~4%. **2. Perspectivas y valoración de Western Digital (WD)** WD se ha beneficiado enormemente, con un margen bruto que pasó de 22.5% (Q1 2025) a 84.6% (Q4 2026). Sin embargo, su modelo de negocio no ha cambiado estructuralmente. * **Pronóstico:** El precio medio por GB (ASP) de WD probablemente alcance su punto máximo en FY28 (~$0.38/GB) y luego disminuya en FY29-FY30, regresando a niveles de 2026. Los acuerdos a largo plazo (LTA) proporcionan un piso, pero no eliminan el ciclo. El margen bruto podría caer al 72% para FY30. * **Valoración:** La valoración actual parece reflejar un escenario neutral. El potencial alcista adicional depende de que el mercado crea que los precios se mantendrán estables más allá de 2028, algo que *Dolphin Research* considera poco probable dada la futura oleada de capacidad.

marsbitHace 2 hora(s)

La IA no puede cambiar el "ADN" de SanDisk, ¿cuánto tiempo más podrá seguir siendo fuerte?

marsbitHace 2 hora(s)

Trading

Spot
活动图片





